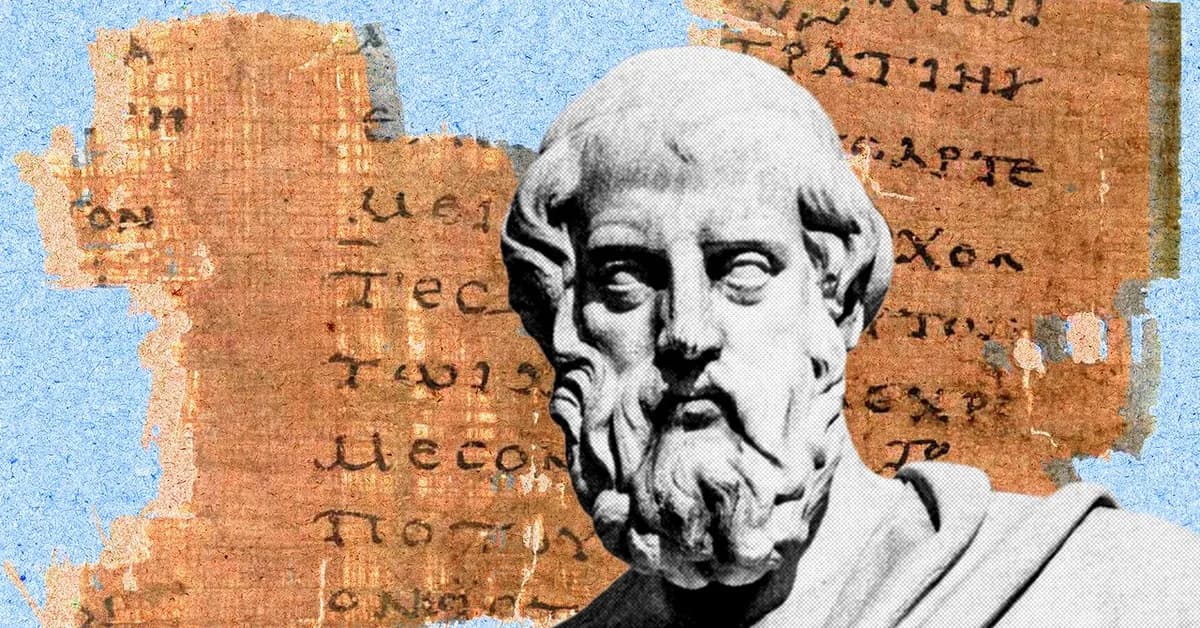
تصور کنید هزاران قطعه از تاریخ بشر در کتابخانههای جهان خاک میخورند، چون هیچ انسانی دیگر نمیتواند خطوط تکهتکه شده آنها را بخواند. حالا یک مدل هوش مصنوعی قرار است این سکوت چندصدساله را بشکند.
آکادمی علوم اتریش در ۲۴ سپتامبر ۲۰۲۶ مدل Apollo را برای رفع یک گلوگاه قدیمی در مطالعات کلاسیک معرفی کرد. این مدل روی صدها هزار قطعه پاپیروس آسیبدیده تمرکز دارد که در حال حاضر در موزهها و کتابخانههای سراسر جهان پراکندهاند.
ترمیم این اسناد تا پیش از این یک فرآیند دستی و طاقتفرسا بود. پژوهشگران باید بدون داشتن فاصله بین کلمات، مرز هر واژه را تشخیص میدادند و با تکیه بر دانش عمیق سیاسی و اجتماعی، جملات گمشده را حدس میزدند. همانطور که در تحلیلهای قبلی ما دربارهی کاربرد هوش مصنوعی در علوم انسانی اشاره کردیم، کمبود متخصصانی با این سطح از تسلط باعث شده بود بخش بزرگی از تاریخ مکتوب جهان باستان در حالت تکهتکه باقی بماند.
مدل Apollo که با همکاری شرکتهای Mistral و Sail Reply توسعه یافته، روی حدود ۶۰۰ میلیون واژه از متون تاریخی یونانی آموزش دیده است. این دادهها از مجموعهای متنوع از نسخههای خطی، پاپیروسها و کتیبهها استخراج شدهاند.
قابلیتهای فنی
- شناخت گویشها: این مدل خروجی خود را بر اساس متن ورودی تغییر میدهد؛ مثلاً برای اشعار حماسی از یونانی هومریکی و برای کتیبههای خاص از گویش دوریک استفاده میکند.
- ترمیم احتمالی: مدل بهجای ارائه یک جواب قطعی، لیستی از محتملترین کلمات را بر اساس آمار برای پر کردن جاهای خالی پیشنهاد میدهد.
- رابط کاربری آکادمیک: پژوهشگران از طریق یک چتبات رایگان به این مدل دسترسی دارند تا سرعت فهرستبندی مجموعههای بزرگ متنی افزایش یابد.
به نقل از آنا دولگانوف، مورخ آکادمی علوم اتریش، این سامانه برای تکمیل تخصص انسانی طراحی شده است، نه جایگزینی آن. مدل گزینهها را پیشنهاد میدهد، اما تصمیم نهایی با پژوهشگر است تا از ورود توهم (Hallucination) — شبیه دوستی که خاطرهای را اشتباه و با اطمینان تعریف میکند — به سوابق تاریخی جلوگیری شود.
این تغییر، تمرکز پژوهشگر را از کارهای مکانیکی بازسازی به تحلیلهای فکری منتقل میکند. به گزارش آرماند دآنگور از دانشگاه آکسفورد، وقتی ماشین سه کلمه محتمل را برای یک جای خالی پیشنهاد میدهد، سرعت کار بهطور چشمگیری بالا میرود.
هرچند بعید است Apollo بهطور ناگهانی نمایشنامههای گمشده سوفوکل را پیدا کند — چون بیشتر پاپیروسها نامههای شخصی یا اداری هستند — اما راهی مقیاسپذیر برای اثبات فرضیات علمی فراهم میکند. هر قطعه ترمیمشده، تکهای کوچک و concrete از دانش ما درباره دوران باستان را کامل میکند.
برای دنیای هوش مصنوعی، این پروژه یک نمونه موفق از بهکارگیری مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — روی دادههای تاریخی کمحجم و بسیار تخصصی است. اگر این مدل موفق شود، سازندگان قصد دارند همین تکنیکهای distillation و فهرستبندی را روی زبانهای مرده دیگر مثل لاتین یا مصری اجرا کنند.
این دستاورد در ادامه روند حل چالشهای دیرینه آکادمیک توسط AI است؛ مشابه موفقیت OpenAI در حل یک مسئله ریاضی ۲۰۰ ساله یا نقشهبرداری گوگل دیپمایند از جهشهای ژنتیکی. ارزش اصلی در اینجا، تبدیل یک مجموعه داده پراکنده به ابزاری پیشبین و قابل جستوجو است. این رویکرد در جهت تبدیل مدلهای زبانی به ابزارهای کاربردی است، مشابه آنچه در عرضه عامل Muse متا برای اجرای عملیات واقعی در اپلیکیشنها شاهد بودیم که هدف آن انتقال AI از محیط چت به محیطهای عملیاتی است.
گام بعدی شما
- اگر پژوهشگر متون کلاسیک هستید، از رابط چتبات Apollo برای تست قطعات پاپیروس خود استفاده کنید.
- نتایج مدل را با منابع متقاطع تاریخی بسنجید تا نرخ توهم مدل در گویشهای خاص مشخص شود.
- بررسی کنید آیا متدهای استخراج داده در Apollo میتواند برای دیجیتالی کردن آرشیوهای محلی به کار رود یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو