تصور کنید در حالی که یک پژوهشگر معمولی سالها برای تکمیل چند مقاله تلاش میکند، همکار شما در یک سال ۲۵۸ مقاله منتشر کند. این حجم از تولید محتوا، هر کسی را به فکر میاندازد که آیا ما هنوز با «پژوهش» سروکار داریم یا با یک خط تولید صنعتی. ۲۵۸ مقاله در یک سال، حجمی است که منتقدان ادعا میکنند بدون اتوماسیون گسترده هوش مصنوعی، از نظر فیزیکی غیرممکن است.
این عدد خیرهکننده متعلق به نیکولاس پولسون (Nicholas Polson)، استاد دانشکده کسبوکار دانشگاه شیکاگو است. او مرزهای بهرهوری آکادمیک را به حدی جابهجا کرده که همکارانش اکنون اعتبار فرآیند تحقیق او را زیر سؤال بردهاند. این اتفاق در حالی رخ میدهد که دنیای دانشگاه با پذیرش مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — دستوپنجه نرم میکند. در حالی که هوش مصنوعی معمولاً برای ویرایش یا تحلیل دادهها استفاده میشود، مقیاس خروجی پولسون نشاندهنده تغییری به سمت تولید محتوای مبتنی بر AI است. این وضعیت تنشی میان پژوهش سنتی، که برای «تلاش سخت» و ظرافتهای علمی ارزش قائل است، و عصر جدیدی از سنتز سریع و مبتنی بر پرامپت ایجاد میکند.
به گزارش جرمی هورپدال (Jeremy Horpedahl) که در ۲۹ سپتامبر ۲۰۲۶ منتشر شد، صفحه پولسون در پلتفرم SSRN نرخ انتشار تکاندهندهای را نشان میدهد. برای مثال، او تنها در ۲۶ اوت ۲۰۲۶، شش مقاله را بهطور همزمان آپلود کرد. هورپدال اشاره میکند که در حالی که خودش در سال جاری بیش از ۲۰۰ پست وبلاگی نوشته است، اما مقیاس کار پولسون اساساً متفاوت است، زیرا اینها یادداشتهای کوتاه نیستند.
این آثار، یادداشتهای اداری یا کوتاه نیستند. بسیاری از این مقالات طول استاندارد آکادمیک را حفظ کردهاند و تعداد صفحات آنها بین ۲۷ تا ۵۸ صفحه است. تولید چنین حجم عظیمی از متن در کمتر از یک سال، نشاندهنده یک خط لوله (Pipeline) بسیار خودکار است. هورپدال مشاهده میکند که خواندن هر یک از این مقالات به تنهایی، حس یک اثر آکادمیک معمولی را میدهد؛ از آن دست پروژههایی که یک پژوهشگر عادی ممکن است چندین ماه برای تکمیل آن وقت صرف کند. همین موضوع باعث میشود که حجم کل ۲۵۸ مقاله در یک سال، از نظر ریاضی برای یک انسان غیرممکن باشد.
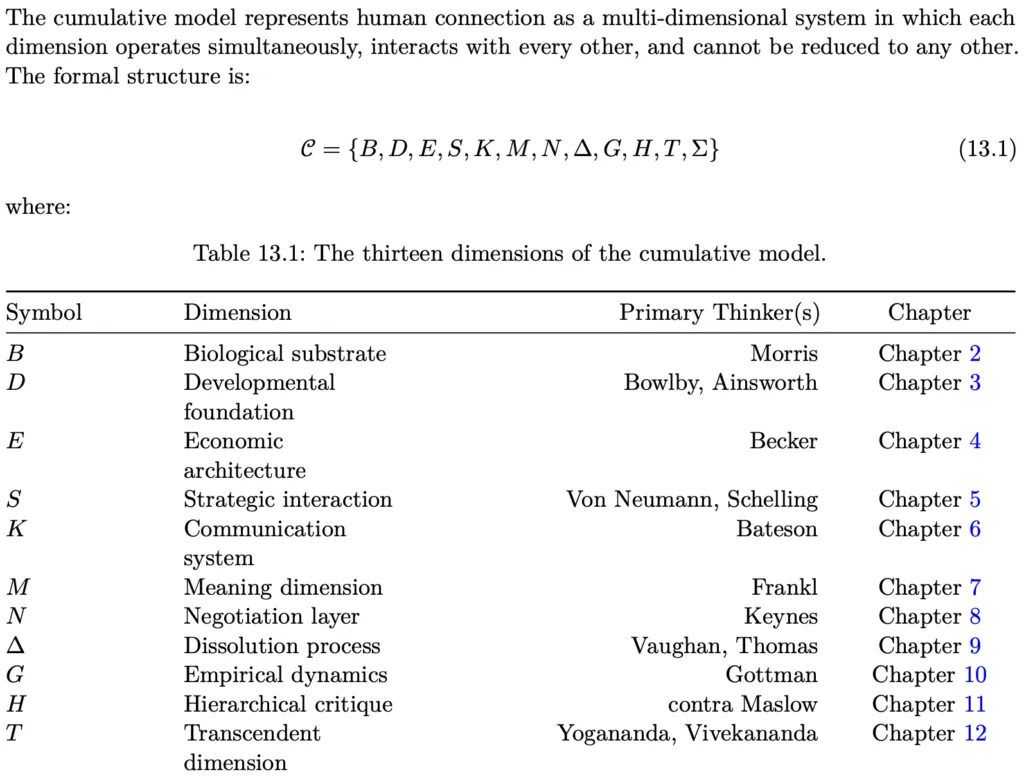
یکی از جنجالیترین آثار او با عنوان «تئوریهای ارتباط انسانی» (Theories of Human Connection) است که به عنوان مدرک اصلی برای منتقدان عمل میکند. این سند ۸۰ صفحهای ادعا میکند که یک سنتز میانرشتهای میان اقتصاد، روانشناسی، زیستشناسی، فلسفه، نظریه بازیها و سنتهای معنوی است.
چکیده این مقاله، ایدههای چهارده متفکر مختلف را با هم ترکیب میکند، از جمله:
- موریس: او ثابت کرد که نیاز به لمس فیزیکی یک رانه تکاملی است که به اندازه گرسنگی بنیادی است و شامل یک توالی بیولوژیکی از آسیبپذیریهای فزاینده است که اختلال در آن، شدتی بدون عمق ایجاد میکند.
- بولی: او نشان داد که چگونه مراقبتهای اولیه، الگوهای نامرئی ایجاد میکنند که صمیمیت در بزرگسالی را هدایت میکنند و این الگوها پیش از ظهور زبان، در سیستم عصبی کدگذاری میشوند.
- بکر: او آشکار کرد که مشارکتها ارزشی تولید میکنند که هیچیک از شرکا به تنهایی قادر به تولید آن نیستند، هرچند او فرض میکرد شرکا قابل جایگزینی هستند.
- ویکتور فرانکل: او فرض بکر را با نشان دادن این نکته که معنای ایجاد شده توسط یک زندگی مشترک قابل انتقال نیست و به جای جمع شدن، در رضایت از زندگی ضرب میشود، تخریب کرد. این موضوع گسست گسترده در ثروتمندترین جوامع تاریخ را توضیح میدهد.
- فون نویمان: او از نظریه بازیها برای توضیح این موضوع استفاده کرد که چگونه عقبنشینی متقابل برای محافظت از خود، در حالی که برای هر شریک به صورت فردی منطقی است، منجر به گسست ناخواسته میشود.
- بیتسون: او ساختارهای ارتباطی از تقاضاهای متناقض را شناسایی کرد که باعث میشود هر پاسخی اشتباه باشد و این امر فروپاشی رابطه را تسریع میکند.
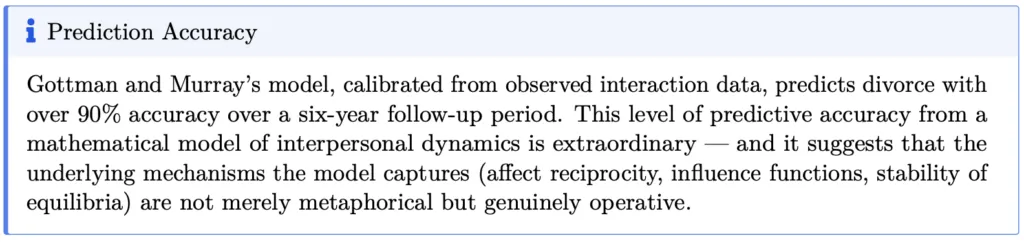
- گاتمن: او از مدلهای آزمایشگاهی برای پیشبینی جدایی با دقت بیش از ۹۰٪ بر اساس نسبت تعاملات مثبت به منفی استفاده کرد.
- سنت فلسفی هندو: مشارکت را به عنوان آزمایشگاهی میبیند که در آن خودخواهی و ترس به تدریج آشکار شده و تسلیم میشوند.
در مقدمه این اثر، لیست متفکرانی که برای این سنتز گردآوری شدهاند آمده است: بکر، بیتسون، فون نویمان، شلینگ، کینز، موریس، وون، فرانکل، مزلو، گاتمن، یوگاناندا، ویوکاناندا، مهاراج، پولسون، توماس و پالترو. نویسنده استدلال میکند که این افراد در قرنها، کشورهای و سنتهای فکری مختلفی فعالیت کردهاند و عمدتاً از کارهای یکدیگر بیخبر بودهاند. هدف مقاله، متحد کردن این ابعاد پراکنده از ارتباط انسانی در یک روایت واحد است.
با این حال، هورپدال اشاره میکند که این مقاله شامل ادعاهایی از گاتمن است که به طور گسترده به عنوان ادعاهای غیرمحتمل مورد انتقاد قرار گرفتهاند. به طور خاص، گاتمن ادعا کرده بود که میتواند طلاقها را با دقت ۹۴٪ پیشبینی کند؛ ادعایی که هورپدال آن را «مزخرف» (Bullshit) توصیف میکند و معتقد است پرامپتهای استفاده شده برای نوشتن مقاله، فاقد شرط «ارزیابی نقادانه ادعاهای غیرمحتمل» بودهاند.
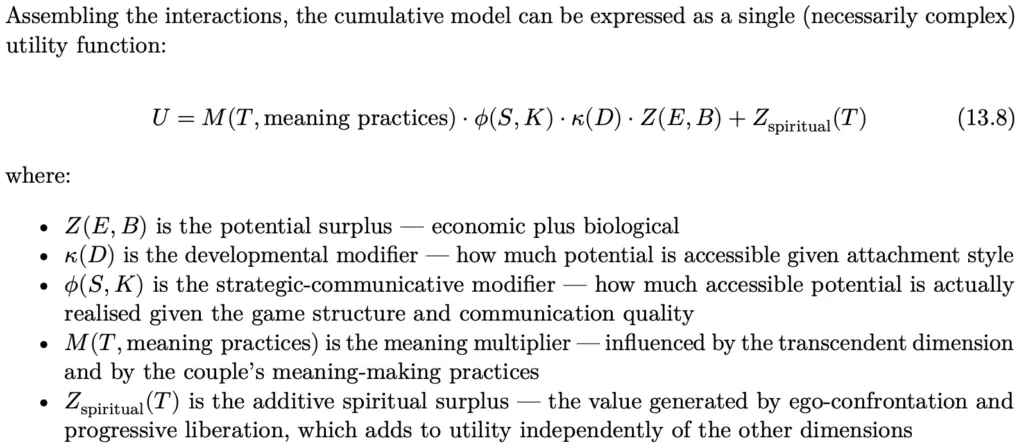
این سند همچنین در صفحه ۷۵ دارای یک «معادله جامع» (Master Equation) است که منتقدان آن را «مزخرفات آکادمیک» مینامند. هورپدال پیشنهاد میکند که این نوع کار بیشتر مناسب یک دانشکده علوم تربیتی است، به این معنا که فاقد دقت و سختگیری یک مقاله علمی جدی است. مقاله در نهایت به فصل ۱۳ میرسد که عنوان آن «مدل تجمعی: نظریه واحد ارتباط انسانی» است.
در مورد علت این جهش در تولید، چهار نظریه اصلی توسط ناظران مطرح شده است:
۱. آزمایش اجتماعی
احتمال اینکه این مقالات یک شوخی یا آزمونی باشند تا ببینند جامعه آکادمیک چه مقدار از محتوای تولید شده توسط AI را میپذیرد. هورپدال این احتمال را کم میداند زیرا هیچ نشانه داخلی یا «چشمک زدنی» به خواننده در متن وجود ندارد و کار کاملاً جدی ارائه شده است. او استدلال میکند که اگر این یک آزمایش بود، مقالات احتمالاً شبیه مقالات آمار خالص بودند، نه چیزی به وضوح ساختگی مانند «تئوریهای ارتباط انسانی».
۲. جعل هویت (Impersonation)
این تئوری میگوید یک بات با انتخاب نام یک دانشگاهی موفق، در حال جعل هویت پولسون است و اینترنت را با مقالات بمباران میکند. این میتواند یک آزمایش غیرشخصی باشد که در آن یک چتبات برنامهریزی شده تا یک آکادمیک شناخته شده را انتخاب کرده و مقالاتی را به نام او منتشر کند. هورپدال میپذیرد که این احتمال کم است اما ممکن است.
۳. اشغال فکری (Intellectual Squatting)
نظریهای که توسط مایکل ماکوسکی مطرح شد و پیشنهاد میکند نویسنده از AI برای ایجاد «حق مالکیت» روی ایدهها در مراحل اولیه پژوهش استفاده میکند. ماکوسکی این کار را به «ریختن مجموعهای از پشتههای کاه در دشت و ادعای مالکیت احتمالی روی سوزنهای موجود در هر کدام» تشبیه میکند.
ماکوسکی استدلال میکند که برای کسی با ایدههای انتزاعی زیاد، هوش مصنوعی اجازه میدهد سالها «تلاش سخت» برای متقاعد کردن همکاران درباره انسجام یک ایده را دور بزند. او پیشنهاد میکند که نویسنده ممکن است یک ساعت روی پرامپتهای مربوط به یک ایده وقت بگذارد و اجازه دهد یک LLM یک مقاله پژوهشی ساختگی تولید کند تا مطمئن شود اعتبار «اولین نفر بودن» را به دست میآورد.
۴. ترویج آموزشی (Educational Outreach)
این دیدگاه معتقد است پولسون از AI استفاده میکند تا بینشهای خود را سریعتر از آنچه نشر سنتی اجازه میدهد، با مخاطبان گستردهتر به اشتراک بگذارد. در این سناریو، پولسون ممکن است باتی را برنامهریزی کرده باشد تا ۲۵۸ موضوع جالب را بگیرد، پرامپتها را اعمال کند و مقالات حاصل را مستقیماً در SSRN پست کند. هورپدال اشاره میکند که در این حالت، محتوای مقالات — مانند «مدل تجمعی» که او آن را به سبک استیون وولفرام تشبیه میکند — ممکن است برای خود پولسون هم به اندازه خوانندگان غافلگیرکننده باشد.
در مقابل، وادیم سوکولوف (Vadim Sokolov)، یکی از همکاران در چندین مقاله، تئوریهای جعل و شوخی را رد کرده است. سوکولوف تأکید میکند که مقالات شوخی یا آزمایش نبودند و تلاشی برای اشغال فکری هم نبودند.
او مدعی است که پولسون و تیمش صرفاً ۲۵۸ چیز مختلف برای گفتن داشتند. به گفته سوکولوف، هوش مصنوعی مدرن این امکان را فراهم کرد که این مطالب با سرعتی تکمیل شوند که پیش از این غیرممکن بود. او گزارش میدهد که حداقل یکی از مقالات چندین دور بازبینی را پشت سر گذاشته است، که نشان میدهد دخالت انسانی فراتر از پرامپتهای ساده بوده است.
سوکولوف همچنین اشاره میکند که برخی مقالات «بسیار جدیدتر هستند و با کمکهای گستردهتری از AI توسعه یافتهاند». او استدلال میکند که AI برای «تکمیل» مطالب استفاده شده است، هرچند منتقدانی مانند هورپدال این را یک مغالطه میدانند؛ تبدیل چند صد کلمه پرامپت به ده هزار کلمه متن، تنها «کف و حباب» (Froth) اضافه میکند و از نظر فکری چیزی را تکمیل نمیکند. هورپدال این فرآیند را به داستان «شاگرد جادوگر» تشبیه میکند.
با این حال، بررسی ردپای دیجیتال پولسون دو حساب کاربری مجزا در SSRN را آشکار میکند. یک حساب حاوی تاریخچه سنتی مقالات است که به ۱ ژانویه ۲۰۰۱ بازمیگردد (با مقاله «تأثیر جهشها در نوسانات و بازدهها»). آخرین اثر substantive او در این حساب، «یادگیری عمیق در مدلهای فاکتور مرتبشده بر اساس ویژگیها» است که در سپتامبر ۲۰۱۸ پست و در ژوئن ۲۰۲۳ بازبینی شد.
حساب دوم، که حاوی جهش AI است، از دسامبر ۲۰۲۳ با مقالهای ضعیف با عنوان «کرامنیک در برابر ناکامورا یا بیز در برابر p-value» شروع شد. هورپدال پیشنهاد میکند این مقاله احتمالاً توسط یک غیرانگلیسیزبان نوشته شده است، نه AI. سپس این حساب در مارس ۲۰۲۶ شاهد جهشی عظیم بود، از جمله مقاله «تئوریهای ارتباط انسانی» در ۱۱ مارس.
پولسون همچنین مقالاتی در Arxiv دارد، از جمله «بیز بدون شرم: هندسههای پذیرش استنتاج پیشبینانه» به تاریخ ۲۴ اوت ۲۰۲۶. هورپدال اشاره میکند که این مقاله به ویژگی مارتینگل اشاره میکند و بسیار substantive تر و شبیه به یک «مقاله علمی واقعی» است تا مقاله ارتباط انسانی؛ موضوعی که قدرت چتباتها در ایجاد سطوح مختلفی از کیفیت را نشان میدهد.
علاوه بر این، گزارشها حاکی از آن است که پولسون ادعا کرده «فرضیه ریمان» را ثابت کرده است؛ دستاوردی که یکی از بزرگترین موفقیتهای ریاضی تاریخ خواهد بود. این ادعا شکاکیت نسبت به متدولوژی فعلی او را دوچندان کرده و باعث نگرانی همکارانش شده است.
این پرونده نشان میدهد که وقتی هزینه تولید یک مقاله ۵۰ صفحهای از چند ماه به یک ساعت مهندسی پرامپت (Prompt Engineering) — هنر سؤال درست پرسیدن برای گرفتن بهترین جواب از مدل — کاهش مییابد، نسبت سیگنال به نویز در سرورهای پیشچاپ فرو میپاشد. این روند به طور گستردهتر در کنفرانسهای علمی نیز مشاهده میشود، جایی که افزایش شدید تعداد مقالات ارسالی به ICLR ۲۰۲۷ بحران کیفیت را در عصر تولیدات AI به شدت تشدید کرده است.
اگر ارزش خالص این مقالات منفی باشد — به این معنی که زمان تلف شده توسط همکاران برای خواندن آنها بیشتر از سهم علمیشان باشد — اکوسیستم آکادمیک با نوع جدیدی از آلودگی مواجه میشود. هورپدال پیشنهاد میکند که پولسون به جای اسپم کردن SSRN، میتوانست یک مقاله واحد و انسانی بنویسد و توضیح دهد چرا این ۲۵۸ ایده مهم هستند؛ مشابه مقالهای که هورپدال با همکارش «آکی» درباره مهمترین ایدههای آماری ۵۰ سال گذشته نوشت.
خطر دیگر تنها دادههای جعلی نیست، بلکه «پژوهشهای سنتتیک» (Synthetic Scholarship) است که درست به نظر میرسند اما فاقد تاییدیه سختگیرانه هستند. این پدیده در مقیاس کلان میتواند منجر به تغییرات بنیادین در ساختار قدرت علمی شود، چرا که خودکارسازی گسترده R&D پتانسیل برهم زدن توازن قدرت جهانی در تولید دانش را دارد.
برای خواننده، این یک هشدار است: وجود یک وابستگی معتبر (مانند دانشگاه شیکاگو) دیگر تضمینی نیست که مقاله واقعاً توسط نویسنده لیست شده خوانده یا بررسی شده باشد.
باید منتظر ماند و دید سرورهای پیشچاپ مانند SSRN و Arxiv چگونه به این حجم از تولیدات AI پاسخ میدهند، زیرا ممکن است مجبور شوند برای جلوگیری از تبدیل شدن پلتفرم به مخزنی از «حبابهای AI»، سیستمهای تایید سختگیرانهتر یا الزامات «انسان در حلقه» (Human-in-the-loop) را اجرا کنند.
گام بعدی شما
- هنگام مطالعه مقالات در SSRN یا Arxiv، به تاریخ انتشار و حجم غیرعادی آثار یک نویسنده دقت کنید.
- از ابزارهای تحلیل متن برای شناسایی الگوهای تکراری و ساختارهای متنی مشابه در مقالات مشکوک استفاده کنید.
- در پژوهشهای خود، مرز بین استفاده از AI برای ویرایش و استفاده برای تولید استدلال را به دقت تعریف کنید.
اما این تنها آغاز ماجراست؛ اثر موجگونهی این مدل تولید محتوا بر اعتبار مدارک دانشگاهی را در گزارش بعدی بررسی خواهیم کرد.


گفتگو