تصور کنید در دنیایی زندگی میکنید که خرابیهای توجیهناپذیر نرمافزار دیگر «باگ» نیستند که باید رفع شوند، بلکه ویژگیهای پذیرفتهشدهای از سیستم هستند. این تغییر خطرناک به این دلیل رخ میدهد که توسعهدهندگان برای رسیدن به سرعتِ عرضهٔ قابلیتهای «قدرتگرفته از AI»، مسئولیتپذیری مهندسی را فدای ضربالاجلهای روز جمعه کردهاند. این رویکرد باعث شده است که نرمافزارهای مدرن بهطور فزایندهای دمدمیمزاج و غیرقابلپیشبینی شوند.
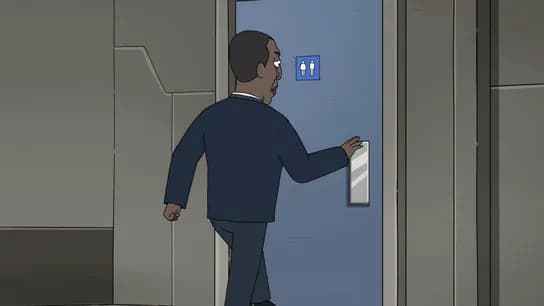
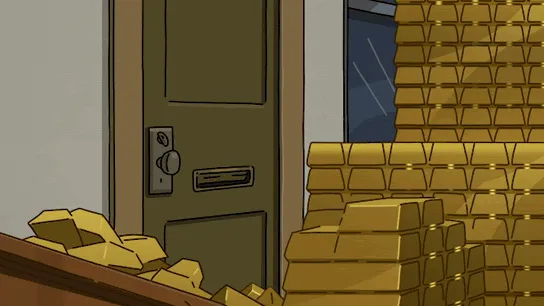
یک درِ بسته را تصور کنید که باز نمیشود. در دنیای سنتی، شما دنبال یک مانع فیزیکی میگشتید تا دلیل بسته ماندن در را بفهمید. در یکی از قسمتهای سریال President Curtis، رئیسجمهور دو بار با یک در دستوپنجه نرم میکند؛ بار اول به دلیل وجود یک جسد و بار دوم به دلیل وجود حدود یک میلیارد دلار شمش طلا. در هر دو مورد، واکنش ساده است: «این چیز احمقانه افتضاح است». اما در دنیای جدیدِ توسعه با هوش مصنوعی، وقتی در باز نمیشود، توسعهدهنده صرفاً میگوید در «افتضاح است» و شانه بالا میاندازد، چون مدل زبانی با ۷۳٪ اطمینان پاسخ داده است. این تغییر دیدگاه، نحوه ساخت و درک ما از ابزارهای دیجیتال را دگرگون میکند.
این وضعیت بازتابی از فقدان قابلیت اطمینان در ابزارهای مدرن است. حتی محصولات تثبیتشدهای مثل Slack گاهی برای برخی کاربران گیجکننده باقی میمانند، زیرا پیامها در نسخههای رایگان، پولی و سازمانی گم میشوند و تنها هفتهها بعد ظاهر میگردند. این امر چشماندازی را ایجاد میکند که در آن کاربران انتظار دارند محصولات شکست بخورند و توسعهدهندگان دیگر انتظار کارکرد درست آنها را ندارند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، سرعت در برابر پایداری همواره یک تضاد است. این چالش بهویژه در ابزارهای توسعه دیده میشود، جایی که اولویت سرعت بر دقت در دستیارهای کدنویسی AI منجر به کاهش کیفیت نهایی کدها شده است. اکنون مرکز این تضاد، مدل Jev ساخته شرکت TypeSafe AI است. Jev برای بازگرداندن مقادیر تایپشده (Typed Values) همراه با تخمینهای احتمالی طراحی شده است. به گزارش وبسایت ihatethefuture.com، نقطه فروش اصلی این مدل «سرعت و ارزان بودن» است تا تیمها بتوانند با سرعت خیرهکنندهای محصول بسازند و عرضه کنند. در واقع، جذابیت اصلی آن در همین سادگی خلاصه میشود: سریع است، ارزان است، میتوانید بهسرعت روی آن بسازید، باز هم سریع است و باز هم ارزان است.
اما این سرعت، هزینهای پنهان در بخش تضمین کیفیت (QA) دارد. طبق بررسیهای منتشر شده، چندین شکاف بحرانی در نحوه پیادهسازی Jev وجود دارد:
- فقدان ارزیابی (Evals): بسیاری از کاربران سؤالات مبهم را به مدل میدهند و پاسخهای مبهم را بدون اجرای مجموعههای ارزیابی میپذیرند. آنها برای اینکه محصول را پیش از تعطیلات آخر هفته عرضه کنند، بودجههای خطا (Error Budgets)، حالتهای شکست (Failure Modes) و مجموعههای آزمون را نادیده میگیرند. این مسئله یادآور آن است که چگونه پرامپتهای کلی در مقیاس تولید به دلیل عدم بهینهسازی در طبقهبندی قصد کاربر، با شکست مواجه میشوند.
- اعتماد تقلیدی (Cargo Cult Confidence): توسعهدهندگان از امتیازات اطمینان (Confidence Scores) مدل برای توجیه شکستها استفاده میکنند. بهجای استفاده از مدل برای مدیریت هزینههای عدم قطعیت، آنها ادعا میکنند که امتیاز اطمینان ۷۳٪ به این معناست که بودجه خطای آنها ۲۷٪ است.
- شکاف کالیبراسیون: در حالی که تبلیغات Jev بر روی بنچمارکها (Benchmarks) — همان آزمونهای استانداردی که قدرت مدل را میسنجند — تمرکز دارد، این موضوع را نادیده میگیرد که آیا امتیازات اطمینان واقعاً کالیبره شدهاند یا خیر. «کتابچه راهنمای» (Cookbook) ارائه شده برای درختهای طبقهبندی، به این موضوع نمیپردازد که این امتیازات در واقعیت چقدر دقیق هستند.
- ناپدید شدن مسئولیتپذیری: برخلاف خطای ۵۰۰ در HTTP که نشاندهنده یک قرارداد شکسته، شکست DNS یا خطای سینتکس در جاوااسکریپت است، شکستهای AI اکنون به عنوان امری اجتنابناپذیر تلقی میشوند.
این وضعیت منجر به «عادیسازی توجیهناپذیری» میشود. وقتی دکمهای در وبسایت خراب میشود، معمولاً یک مسئول مشخص وجود دارد. حتی در شکستهای مشهور — مثل وقتی بیل گیتس به طور نمادین نتوانست Movie Maker را دانلود کند — توافقی کلی وجود داشت که این مشکل باید توسط کسی حل شود. اما در توسعه شتابیافته با مدل زبانی بزرگ (LLM)، بررسیها معمولاً با این نتیجه به پایان میرسد که هوش مصنوعی صرفاً یک اشتباه کرده است.
برای کاربر عادی، این یعنی نرخ بالاتری از استیصال و ناامیدی. برای توسعهدهنده، این به معنای فرسایش انضباط مهندسی است. تراژدی اینجاست که همان ابزارهای AI که برای تولید این «زبالههای نرمافزاری» (Slop) استفاده میشوند، میتوانستند برای نوشتن گردشکارهای خودکار QA و ارزیابیهایی به کار روند که استفاده از مدل را در وهله اول توجیه کند. این ارزیابیهای حیاتی اغلب تنها در فاصله چند پرامپت (Prompt) قرار دارند.
در نهایت، ما در حال مهندسی سیستمهایی هستیم که نه سازنده و نه کاربر، اهمیتی نمیدهند که آیا «جسمی پشت در» هست یا خیر. ما دنیایی را میپذیریم که در آن نرمافزار یک ابزار قابل اعتماد نیست، بلکه موجودی دمدمیمزاج است که گاهی بدون دلیل شکست میخورد.
گام بعدی شما
- اگر از مدلهای سریع و ارزان برای تولید کد استفاده میکنید، حتماً یک مجموعه داده مرجع (Ground Truth) برای تست خروجیها بسازید.
- به دنبال ظهور «بنچمارکهای کالیبراسیون» باشید که نه فقط صحت مدل، بلکه همبستگی امتیاز اطمینان با دقت واقعی را میسنجند.
- از ابزارهای AI برای نوشتن تستهای خودکار (Automated Testing) استفاده کنید تا سرعت عرضه را با کیفیت ترکیب کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.


گفتگو