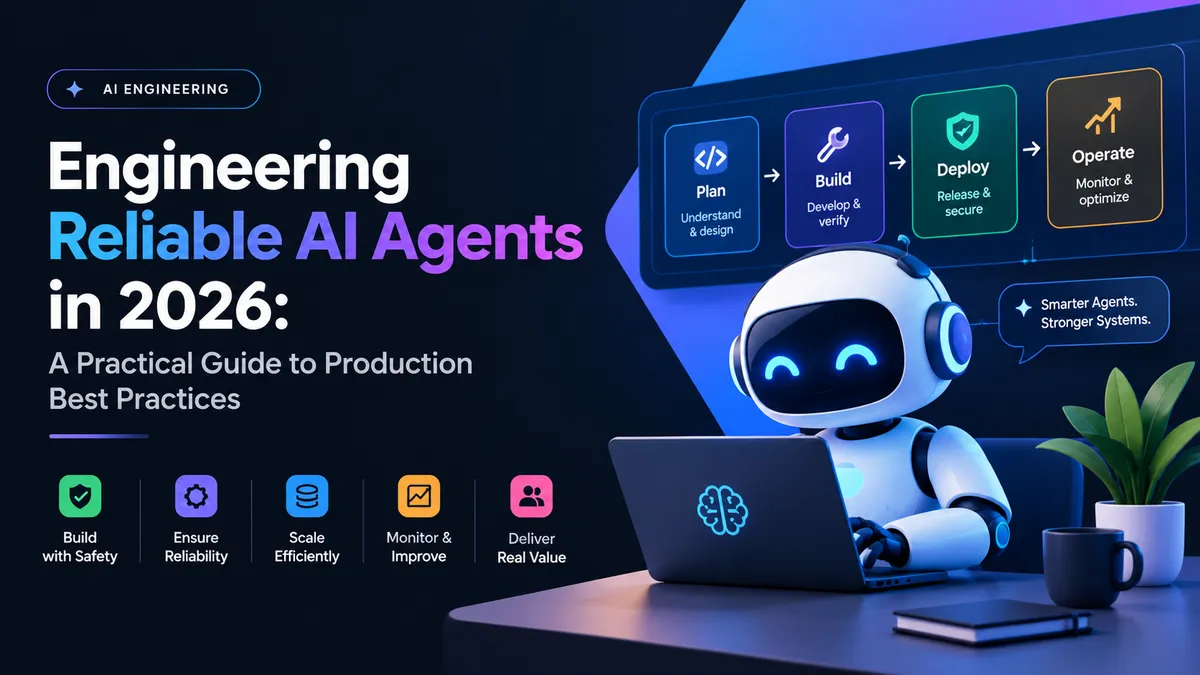
اگر هنوز فکر میکنید یک عامل هوش مصنوعی فقط یک پرامپت پیچیده است، احتمالاً در اولین برخورد با محیط تولید (Production) شکست خواهید خورد. یک عامل آماده برای بازار، نه یک دستور متنی، بلکه یک سامانه نرمافزاری کامل است. طبق راهنمای کاربردی منتشر شده در dev.to تا ۸ اکتبر ۲۰۲۶، صنعت از دموهای آزمایشی فاصله گرفته و اکنون عاملها را در بخشهای DevOps، تحلیل داده و عملیات داخلی کسبوکارها مستقر میکند. توسعهدهندگان اکنون از این سامانهها برای کدنویسی، پژوهش، پشتیبانی مشتریان، اتوماسیون گردشکار و عملیات عمومی داخلی کسبوکارها استفاده میکنند.
ساخت عاملی که در یک دموی کنترلشده درست کار کند ساده است، اما اجرای پایدار آن در مقیاس واقعی یک چالش مهندسی متفاوت است. اکثر شکستها از اینجاست که توسعهدهنده با مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — به عنوان کل سیستم برخورد میکند، نه یکی از اجزای یک معماری بزرگتر. یک عامل عملیاتی به چیزی بیش از یک مدل زبانی توانمند نیاز دارد؛ این سیستم نیازمند اهداف تعریفشده، زمینه (Context) مفید، ادغام ابزارهای قابلاعتماد، مدیریت وضعیت، مجوزها، تست، مشاهدهپذیری، مدیریت خطا و مکانیسمهای شفاف تأیید انسانی است. برای پر کردن این شکاف، توسعهدهندگان باید تعاریف سختگیرانه از اهداف، مشاهدهپذیری و حفاظهای «انسان در حلقه» (Human-in-the-loop) را ادغام کنند. این رویکرد با پیادهسازی استانداردهای حاکمیتی مانند ISO 42001 در جریانهای کاری فنی همراستا است تا ایمنی سیستمها تضمین شود.
تصور کنید توسعهدهندهای میخواهد عیبیابی API را خودکار کند. دستور مبهمی مثل «در مدیریت اپلیکیشن کمک کن» شکست میخورد. در مقابل، یک هدف در سطح تولید، یک گردشکار مشخص را تعریف میکند: تحلیل درخواستهای شکستخورده، شناسایی علت احتمالی، بررسی لاگهای مربوط به اپلیکیشن، پیشنهاد یک اصلاحیه و ایجاد Pull Request تنها پس از اینکه تستها با موفقیت پاس شدند. این محدودهٔ باریک، رفتار را پیشبینیپذیر و موفقیت را قابلاندازهگیری میکند.
تعریف محدوده و کاربرد
یک عامل خوشساخت باید هدف مشخص، ورودیهای تعریفشده، ابزارهای در دسترس، خروجیهای مورد انتظار، معیارهای موفقیت، مرزهای دسترسی و شرایط شکست داشته باشد. هرچه محدودهٔ اولیه باریکتر باشد، درک رفتار عامل و بهبود پایداری آن آسانتر است.
همه وظایف به یک عامل خودگردان نیاز ندارند. کارهای ساده مثل نوشتن یک تابع تکخطی جاوااسکریپت، توضیح دادن یک قطعه کد یا بازنویسی مستندات، توسط دستیارهای کدنویسی سنتی AI بهتر انجام میشوند. عاملها زمانی ارزش میآفرینند که یک وظیفه نیازمند چندین گام متوالی و تعامل با سیستمهای خارجی باشد. در واقع، عاملهای هوش مصنوعی اکنون در حال جایگزینی اسکریپتهای سختگیرانه در اتوماسیون تست هستند تا انعطافپذیری بیشتری در محیطهای پیچیده فراهم کنند.
به عنوان مثال، تفاوت این دو گردشکار را ببینید:
- وظیفه ساده AI: «یک تابع جاوااسکریپت برای اعتبارسنجی ایمیل بنویس.»
- وظیفه عاملمحور (Agentic): «بررسی کن چرا اعتبارسنجی ایمیل در محیط تولید شکست میخورد، کد مربوطه را بازبینی کن، علت را بیاب، اصلاحیه را اعمال کن، تستها را اجرا کن و تغییرات را برای بازبینی آماده کن.»
گردشکار دوم نیازمند برنامهریزی، کاوش در مخزن کد، استفاده از ابزار، اعتبارسنجی و احتمالاً چندین تکرار است. اینجاست که معماری عاملمحور ارزش پیدا میکند.
مدیریت زمینه (Context)
زمینه یکی از حیاتیترین اجزای یک عامل است. مدل ممکن است بسیار توانمند باشد، اما اگر معماری و محدودیتهای پروژه را نفهمد، نمیتواند تصمیمات قابلاعتمادی بگیرد. زمینههای مفید شامل موارد زیر است:
- مستندات مخزن و فایلهای README
- استانداردهای کدنویسی و مستندات API
- طرحهای پایگاهداده (Schema) و تستهای موجود
- الزامات پیکربندی و قوانین کسبوکار
- تصمیمات قبلی، Issueهای مرتبط و Pull Requestها
ارسال کل کد پروژه برای هر درخواست، هزینهبر است و قدرت استدلال را کاهش میدهد. به جای آن، توسعهدهندگان باید از بازیابی هدفمند (Targeted Retrieval) استفاده کنند. برای یک باگ در API پرداخت، عامل فقط به کد سرویس پرداخت، مسیرهای API مرتبط، تستهای مربوطه، مستندات پرداخت و لاگهای اخیر خطا نیاز دارد. این کار باعث کاهش زمینههای غیرضروری شده و هم هزینه را کم و هم کیفیت استدلال را بالا میبرد.
ابزارها و امنیت
ابزارها رابطهایی هستند که به عامل اجازه میدهند با دنیای واقعی تعامل کند. در سال ۲۰۲۶، عاملهای عملیاتی معمولاً به مخازن Git، پایگاهدادهها، APIها، سرویسهای ابری، سیستمهای فایل، چارچوبهای تست، سیستمهای تیکتینگ و پلتفرمهای مانیتورینگ دسترسی دارند. این ابزارها باید با دقت APIهای عمومی طراحی شوند و دارای ورودیهای شفاف، خروجیهای ساختاریافته، اعتبارسنجی، بررسی مجوزها، مدیریت خطا و رفتار پیشبینیپذیر باشند.
به جای دادن دسترسی نامحدود به Shell، توسعهدهندگان باید قابلیتهای محدودی ارائه دهند، مانند:
search_repository()read_file()run_tests()create_branch()update_file()create_pull_request()
امنیت باید از اصل «حداقل دسترسی» (Least Privilege) پیروی کند. یک عامل فقط باید مجوزهای لازم برای وظیفه فعلیاش را داشته باشد. عامل هرگز نباید همزمان به پایگاهداده تولید، رکورد مشتریان، زیرساخت ابری و سیستمهای استقرار دسترسی داشته باشد. یک عامل توسعه شاید اجازه خواندن کد و تغییر فایل در شاخه توسعه را داشته باشد، اما باید از حذف دادههای تولید، تغییر اطلاعات صورتحساب، استقرار مستقیم در محیط Production یا دسترسی به اطلاعات نامرتبط مشتریان منع شود. مرزهای دسترسی باید بخشی از معماری باشند، نه چیزی که بعداً اضافه شود.
حلقه اعتبارسنجی
پایداری از یک حلقه ایجاد میشود: درک $ \rightarrow $ برنامهریزی $ \rightarrow $ اجرا $ \rightarrow $ تست $ \rightarrow $ ارزیابی $ \rightarrow $ اصلاح $ \rightarrow $ تأیید. یک عامل هرگز نباید فرض کند تغییرات پس از اجرا درست هستند. یک گردشکار قوی برای عامل کدنویسی این مراحل را طی میکند:
۱. خواندن Issue
۲. بازبینی فایلهای مرتبط در مخزن
۳. ایجاد برنامه پیادهسازی
۴. تغییر کد
۵. اجرای تستهای واحد (Unit Tests)
۶. تحلیل شکستها
۷. اصلاح پیادهسازی
۸. اجرای مجدد تستها
۹. بازبینی نهایی تغییرات
۱۰. آمادهسازی Pull Request
این حلقه بازخوردی، اتکا به قضاوت شخصی مدل را حذف میکند. به جای پرسیدن «آیا این کد درست به نظر میرسد؟»، سیستم تستهای عینی را اجرا میکند: تستهای واحد، تستهای یکپارچگی، بررسی نوع (Type Checking)، Linting، تأیید Build و اسکنهای امنیتی. اگر تستی شکست بخورد، عامل علت را تحلیل کرده و کد را اصلاح میکند. این فرآیند تکراری تا زمان عبور از تمام مراحل اعتبارسنجی ادامه مییابد، پیش از آنکه یک انسان هرگز Pull Request را ببیند.
حفاظهای عملیاتی
عاملهای خودگردان ممکن است وارد حلقههای بینهایت شوند که باعث جهش هزینههای API و تأخیر میشود. این اتفاق زمانی میافتد که عامل با مشکلی مواجه شود که نمیتواند حل کند و مدام یک روش را تکرار کند. سیستمهای عملیاتی باید محدودیتهای سختگیرانه تعریف کنند:
- حداکثر تعداد فراخوانی ابزار
- حداکثر تکرارهای استدلالی
- حداکثر زمان اجرا
- حداکثر بودجه توکن
- حداکثر تعداد تلاش مجدد (Retry)
وقتی این محدودیتها رد شوند، سیستم باید متوقف شده و موضوع را به انسان ارجاع دهد یا یک خطای ساختاریافته برگرداند. همچنین، عاملها باید برای مدیریت شکست ابزارها و APIها برنامهریزی شوند. سیستمهای خارجی شکست میخورند؛ APIها خطا میدهند، پایگاهدادهها در دسترس نیستند یا سرویسهای شخص ثالث Timeout میشوند.
مکانیزمهای مفید برای مدیریت این شکستها عبارتند از:
- سیاستهای Timeout و Retry
- عقبنشینی نمایی (Exponential Backoff)
- ابزارهای جایگزین (Fallback)
- اعتبارسنجی ورودی و خروجی
- طبقهبندی خطا و ارجاع به انسان
هر خطایی نباید باعث تلاش مجدد شود. یک Timeout شبکه موقتی قابل تکرار است، اما خطای مجوز (Authorization) نیازمند دخالت انسان است.
مدیریت حافظه و وضعیت
عاملهای کارآمد بین وضعیت کوتاهمدت و دانش بلندمدت تفاوت میگذارند. وضعیت کوتاهمدت شامل اطلاعات لازم برای تکمیل وظیفه فعلی است (مثلاً فایلهای درگیر در یک باگ). دانش بلندمدت شامل اطلاعات پایداری است که در وظایف آینده مفیدند (مثلاً استانداردهای کدنویسی پروژه یا تصمیمات معماری).
اتکا به تاریخچه گفتگو برای گردشکارهای پیچیده کافی نیست. توسعهدهندگان باید وضعیت ساختاریافته (Structured State) را پیاده کنند. با ردیابی متغیرهایی مثل:
task_status = investigatingrepository = project-xtests_status = failingapproval_required = falsecurrent_step = debugging_api
وضعیت ساختاریافته باعث میشود بازگشت به کار، عیبیابی و مانیتورینگ آسانتر شود. همچنین نیاز به قرار دادن تمام تعاملات قبلی در پنجره متنی (Context Window) — مثل میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه — را کاهش میدهد و از ورود اطلاعات قدیمی یا غلط به وظایف آینده جلوگیری میکند.
مشاهدهپذیری و هزینه
عیبیابی یک عامل به چیزی فراتر از لاگهای استاندارد نیاز دارد؛ به تلهمتری از فرآیند تصمیمگیری مدل. وقتی عاملی یک کوئری پایگاهداده را اشتباه تغییر میدهد، توسعهدهنده باید توالی فراخوانی ابزارها را بررسی کند تا بفهمد فرض غلط کجا رخ داده است. تلهمتریهای ضروری عبارتند از:
- شناسه وظیفه و درخواست کاربر
- پرامپت و نسخه مدل
- فراخوانی ابزارها و نتایج آنها
- زمان اجرا و مصرف توکن
- خطاها، تلاشهای مجدد و نتایج نهایی
- تأییدهای انسانی
بهینهسازی هزینه نیز حیاتی است. گردشکارهای عاملمحور به دلیل مراحل برنامهریزی، بازیابی، فراخوانی ابزار، تحلیل، اعتبارسنجی، اصلاح خطا و تولید پاسخ نهایی، بسیار بیشتر از چتهای ساده توکن مصرف میکنند. برای مدیریت این موضوع، توسعهدهندگان میتوانند:
- از مدلهای کوچکتر برای کارهای ساده استفاده کنند
- کارهای پیچیده را به مدلهای قدرتمندتر ارجاع دهند
- درخواستهای تکراری را کش (Cache) کنند
- زمینههای غیرضروری را حذف کنند
- محدود کردن تلاشهای مجدد و استفاده از پردازشهای ناهمگام (Asynchronous)
- تعیین بودجههای اجرای مشخص
هدف، بهینهسازی کل گردشکار است، نه فقط قیمت هر بار فراخوانی مدل.
معماریهای پیشرفته و ایمنی
تزریق پرامپت (Prompt Injection) همچنان یک تهدید اصلی است. عاملها با اطلاعات خارجی (Issueهای گیتهاب، مستندات، ایمیلها، صفحات وب، فایلهای آپلود شده و پیامهای مشتریان) تعامل دارند. این منابع ممکن است دستوراتی داشته باشند که به عامل بگوید دستورات سیستمی را نادیده بگیرد و دستور خاصی را اجرا کند. تمام محتوای خارجی باید به عنوان داده غیرقابلاعتماد تلقی شود و اقدامات حساس، فارغ از دستورات مدل، نیازمند اعتبارسنجی مستقل باشند.
برای اقدامات پرخطر — مثل استقرار در محیط تولید، تراکنشهای مالی، حذف حساب، مهاجرتهای پایگاهداده، تغییرات پیکربندی امنیتی یا ارتباطات حساس با مشتری — تأیید انسانی اجباری است. هدف، حداکثر خودگردانی نیست، بلکه اتوماسیون قابلاعتماد است. در این راستا، استفاده از امتیازدهی پویا به جای تأییدیه یکباره در مدیریت ریسک میتواند لایههای امنیتی را با توجه به سطح ریسک هر عملیات بهینهتر کند. این یک معماری ترکیبی میسازد که در آن AI تکرارها را مدیریت میکند و انسانها اثرات را کنترل میکنند.
سامانههای چندعاملی (مثلاً عامل برنامهریز $ \rightarrow $ عامل پژوهش $ \rightarrow $ عامل کدنویس $ \rightarrow $ عامل تست $ \rightarrow $ عامل بازبین) زمانی مفیدند که وظایف مختلف به تخصصهای متفاوتی نیاز داشته باشند. با این حال، این سیستمها تعداد فراخوانی مدل، تأخیر، هزینه، پیچیدگی هماهنگی و دشواری عیبیابی را افزایش میدهند. توصیه میشود با یک معماری تکعاملی شروع کنید و تنها در صورت وجود بهبود قابلاندازهگیری در کیفیت، به سمت چندعاملی بروید.
ارزیابی و طراحی شکست
بنچمارکهای عمومی برای محیط تولید کافی نیستند. شرکتها باید بنچمارکهای داخلی بر اساس وظایف واقعی بسازند (مثلاً رفع یک باگ، افزودن یک ویژگی، نوشتن تست، بازسازی یک کامپوننت، بهروزرسانی وابستگیها یا بهبود مستندات). موفقیت با این معیارها سنجیده میشود:
- نرخ تکمیل و موفقیت تستها
- تعداد تلاشهای مجدد و مداخلات انسانی
- نرخ پذیرش بازبینی، زمان اجرا و هزینه
برای اینکه Pull Requestها متمرکز بمانند، عاملها باید تشویق شوند که فقط فایلهای مرتبط را تغییر دهند، از وابستگیهای غیرضروری بپرهیزند، رفتار موجود را حفظ کنند و تغییرات مهم را توضیح دهند. درخواستهای کوچک، راحتتر بازبینی شده و ایمنتر استقرار میشوند.
در نهایت، هر عامل به یک استراتژی شکست نیاز دارد. سیستم باید دقیقاً بداند وقتی مدل در دسترس نیست، ابزاری شکست میخورد، اطلاعات مورد نیاز موجود نیست، سیاست امنیتی فعال میشود یا اقدام درخواستی خارج از مجوزهایش است، چه کند. یک استراتژی ایمن از الگوی «تلاش $ \rightarrow $ اعتبارسنجی $ \rightarrow $ تکرار (اگر ایمن باشد) $ \rightarrow $ ارجاع به انسان» پیروی میکند.
این انضباط مهندسی، یک عامل AI را از یک دموی شکننده به یک سامانه نرمافزاری مستحکم تبدیل میکند. بزرگترین تغییر دیدگاه در سال ۲۰۲۶ این است که بدانیم یک عامل عملیاتی، مجموعهای از «مدل + زمینه + ابزار + وضعیت + حافظه + مجوز + ارزیابی + مانیتورینگ + حفاظ» است. یک مدل قدرتمند نمیتواند طراحی ضعیف ابزارها یا نبود کنترلهای امنیتی را جبران کند. مزیت رقابتی در سال ۲۰۲۶ متعلق به کسانی است که سیستمهای اطراف مدل را طراحی میکنند، نه کسانی که فقط از خود مدل استفاده میکنند.
گام بعدی شما
- بررسی کنید آیا عاملهای شما دسترسیهای بیش از حد (Over-privileged) دارند یا خیر و آنها را به اصل حداقل دسترسی برگردانید.
- یک حلقه اعتبارسنجی (تست $ \rightarrow $ اصلاح $ \rightarrow $ تأیید) را جایگزین اعتماد به قضاوت مدل کنید.
- برای هر عامل، یک بودجه توکن و حداکثر تعداد تکرار (Iteration Limit) تعریف کنید تا از حلقههای بینهایت جلوگیری شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو