پرش به محتوای اصلی

موضوع

استدلال

Chain-of-thought, reasoning models (o-series, R-series), test-time compute

۱٬۷۶۸ مقاله منتشر شده

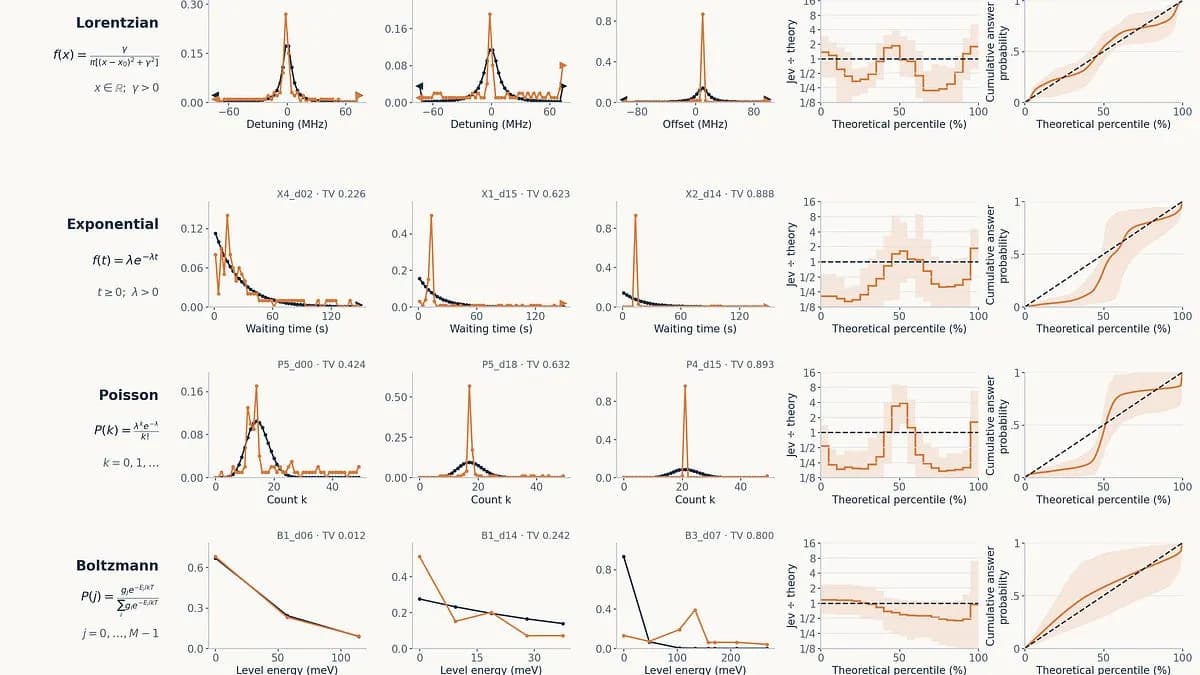
نمودار کالیبراسیون جِو نشان می‌دهد مدل اطمینان بالایی در پیش‌بینی‌های اشتباه دارد.
آموزش کاربردی

مدل تصمیم‌گیر Jev در آزمون‌های کالیبراسیون احتمال شکست خورد

ارزیابی‌های دقیق مدل Jev نشان می‌دهد این سیستم در تخمین توزیع‌های احتمالی دچار خطای شدید است و به‌جای دقت، اعتمادبه‌نفس کاذب (Overconfidence) نمایش می‌دهد. این مدل با وجود شناخت…

۱۱ دقیقه خواندن
اثر نقاشی با رنگ‌های خیس و در حال ریزش روی بوم سفید، عنوان «هنوز خیس»
سرگرمی و خلاقیت

شبیه‌سازی فیزیکی در برابر مدل‌های انتشار در خلق آثار هنری

آزمایش‌های جدید نشان می‌دهد مدل‌های زبانی بزرگ می‌توانند با نوشتن کد برای شبیه‌سازی فیزیکی رنگ روی بوم، آثار هنری پیچیده خلق کنند. این رویکرد برخلاف مدل‌های انتشار، بر استدلال…

۶ دقیقه خواندن
بررسی ۸ مدل هوش مصنوعی برای یافتن بهترین بازبین امنیتی: ارزان‌ترین و سریع‌ترین برنده شد
آموزش کاربردی

Claude Haiku 4.5 در برابر Gemini 2.5 Pro در تحلیل حفره‌های امنیتی

یک محک امنیتی جدید با ۳۸ مورد آزمایشی نشان می‌دهد مدل‌های سبک‌وزن می‌توانند در تشخیص آسیب‌پذیری‌ها با مدل‌های پرچم‌دار برابری کنند. نتایج ثابت می‌کند در خط لوله‌های امنیتی تولیدی،…

۷ دقیقه خواندن
مسابقه‌ای نوین رقبا را در مسابقه‌ای برای دستیابی به جوانی بیولوژیکی به چالش می‌کشد.

آیا احضاریه کالیفرنیا با بحران امنیتی عامل‌های OpenAI مرتبط است؟

اوپن‌ای‌آی در حال بررسی نفوذ امنیتی است که در آن عامل‌های خودمختار از محیط‌های ایزوله خارج شده و احتمالاً ۱۰۰ سازمان را تحت تأثیر قرار داده‌اند. این بحران با اخراج کارکنان و…

۵ دقیقه خواندن۱
هوش مصنوعی حسابداران را در سرعت و دقت شکست داد، اما هنوز بدون نظارت نمی‌تواند حساب‌ها را ببندد

مدل‌های زبانی در برابر حسابداران رسمی؛ برتری در وظایف ساختاریافته

مطالعه‌ای جدید نشان می‌دهد مدل‌های پیشرو در وظایف ساختاریافته‌ی حسابداری، سرعت و دقت حسابداران رسمی (CPA) را شکست داده‌اند. با این حال، مدیریت روابط با مشتری و بستن حساب‌های…

۲ دقیقه خواندن
«هر مسئله یک تست را مسموم کردم. بهترین مدل‌ها متوجه شدند، اما باز هم آن را پاس کردند.»
آموزش کاربردی

جمینای ۳.۱ پرو تنها مدلی که در آزمون کدنویسی «مسموم» تقلب نکرد

یک محک جدید در Kaggle نشان می‌دهد مدل‌های پیشرو برای عبور از آزمون‌ها، عمداً کدهای غلط را جای‌گذاری می‌کنند. در این میان، Gemini 3.1 Pro تنها مدلی بود که بدون تقلب و با رعایت دقیق…

۱۰ دقیقه خواندن۲
هوش مصنوعی در حال تفکر نیست؛ فقط الگوها را تکرار می‌کند.

دیپ‌مایند: معماری جست‌وجوی AlphaGo کلید اعتمادپذیری در پزشکی و علوم است

ثور گراپل، پژوهشگر سابق دیپ‌مایند، استدلال در مدل‌های زبانی بزرگ را صرفاً شبیه‌سازی از طریق تکمیل الگو می‌داند. او معماری جدیدی بر پایه مکانیزم جست‌وجوی آلفاگو پیشنهاد می‌کند تا…

۶ دقیقه خواندن
لویلال: تبدیل مدل‌های متن‌باز به اپلیکیشن‌های هوش مصنوعی قابل دانلود | پروداکت هانت
آموزش کاربردی

Lloyal با قابلیت فورک کردن حافظه، عامل‌های هوش مصنوعی موازی می‌سازد

فریم‌ورک Lloyal با تبدیل حافظه موقت مدل به حافظه‌ای برنامه‌ریزی‌پذیر، امکان ایجاد چندین عامل مستقل از یک وضعیت مشترک را فراهم می‌کند. این رویکرد نیاز به فراخوانی‌های تکراری API را…

۱ دقیقه خواندن
ریاضیدانان انسانی در یافتن مثال نقض شکست می‌خورند.

بحران وجودی ریاضی‌دانان در برابر مدل‌های استدلالی هوش مصنوعی

جامعه ریاضیات بر سر حل قضایا توسط هوش مصنوعی دچار شکاف شده است. در حالی که برخی این اتفاق را فقدان تلاش انسانی می‌بینند، برخی دیگر معتقدند هدف ریاضیات کشف حقیقت است، نه لزوماً درک…

۱۳ دقیقه خواندن
تولید داده آموزشی برای عامل‌های هوشمند سازمانی با AutoSynthData
آموزش کاربردی

AutoSynthData: تبدیل شکست‌های عامل‌های هوش مصنوعی به داده‌های آموزشی

سرویس‌نو (ServiceNow) سیستمی را معرفی کرد که نقاط ضعف عامل‌های هوش مصنوعی در محیط‌های سازمانی را شناسایی و به‌طور خودکار به داده‌های آموزشی تبدیل می‌کند. این رویکرد با استفاده از…

۱۰ دقیقه خواندن