
اگر امروز از یک دستیار هوش مصنوعی استفاده میکنید، احتمالاً متوجه شدهاید که هرچه تاریخچه گفتگوها طولانیتر میشود، مدل کندتر و پرتوپلاگویتر میشود. این پدیده که «پوسیدگی حافظه» نام دارد، باعث میشود سیستمهای هوش مصنوعی پس از مدتی به جای کمک، به یک مانع تبدیل شوند.
به نقل از مستندات HyperMarrow، در ۱ اکتبر ۲۰۲۶ معماری جدیدی معرفی شد که حافظه را نه به شکل یک گزارش ایستا، بلکه به عنوان یک پایگاهداده پویا مدیریت میکند. همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، مدیریت داده در لبه (Edge) کلید حریم خصوصی است؛ HyperMarrow نیز با انتقال حافظه به دیسک محلی کاربر، ریسکهای امنیتی را محدود کرده است.
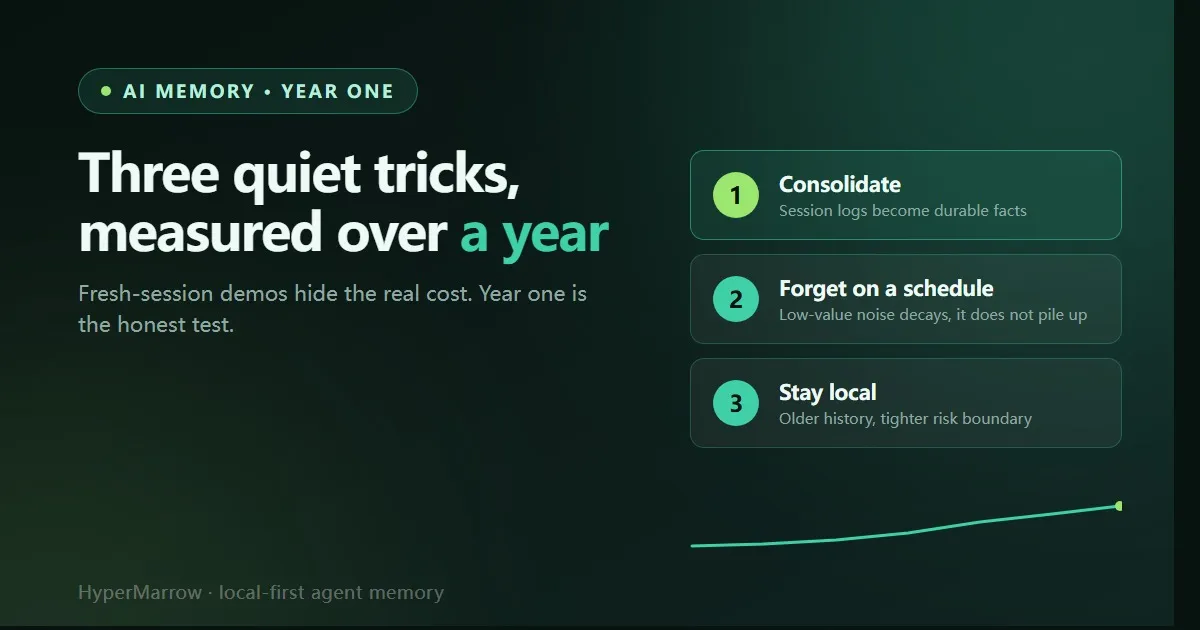
بسیاری از کاربران تنها در جلسات کوتاه، قدرت حافظه را میسنجند، اما ارزش واقعی یک سیستم در عملکرد آن پس از یک سال استفاده مداوم مشخص میشود. این چالشها باعث شده تا استانداردهای جدیدی برای ارزیابی حافظه توسعه یابد، مشابه آنچه در رویکرد جدید Glasshouse برای سنجش حافظه AI مشاهده کردیم. طبق گزارش وبسایت dev.to، بدون مدیریت فعال، نسبت سیگنال به نویز کاهش مییابد و بازیابی اطلاعات ناکارآمد و پرریسک میشود.
HyperMarrow برای حل این مشکل از چهار بلوک سازنده شامل بازیابی، ثبت-رهگیری، تثبیت و پل فایل استفاده میکند. این سیستم بر سه مکانیزم کلیدی تکیه دارد:
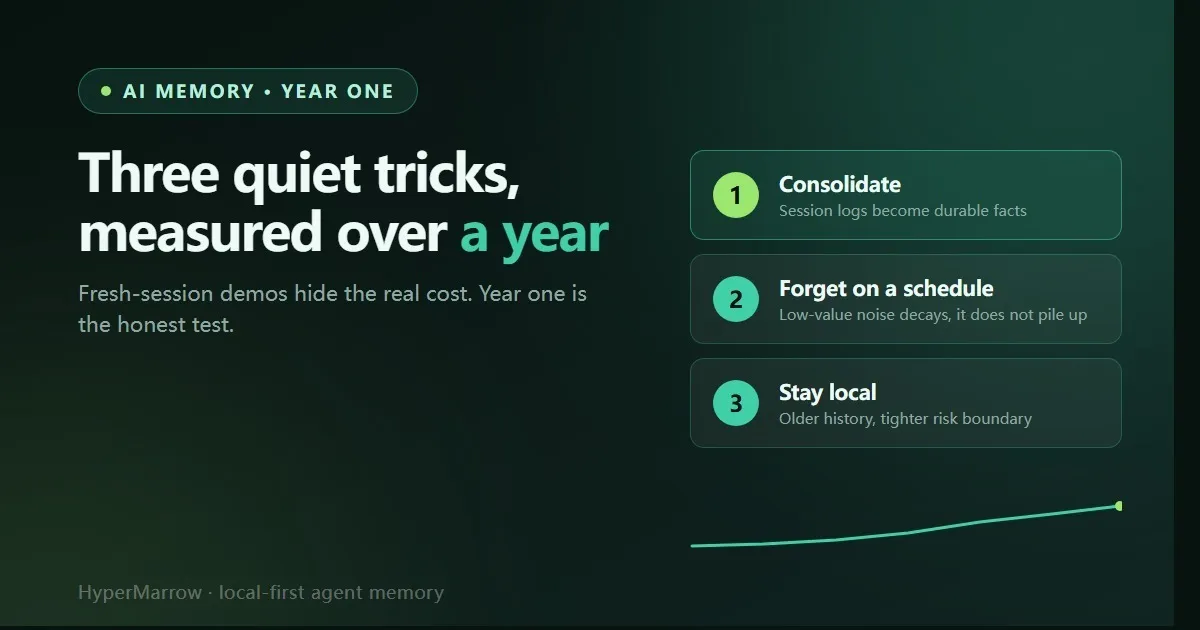
- تثبیت (Consolidation): تبدیل گزارشهای خام جلسات به حقایق ساختاریافته و بادوام برای حفظ سیگنالهای مفید. این متد در تضاد با برخی دیدگاههاست، مانند پروژه Lossless-Memory که تلخیص هوش مصنوعی را برای بازیابی دقیق خاطرات رد کرد.
- فراموشی برنامهریزیشده (Scheduled Forgetting): اجازه دادن به نویزهای کمارزش برای محو شدن تدریجی به جای انباشت ابدی. این ضرورت حذف دادهها را به یادآور بحثهای پیشین ما دربارهی اینکه چرا مدلها برای هوشمند بودن باید فراموش کنند پیوند میدهد.
- ذخیرهسازی محلی (Local Storage): نگهداری تاریخچه روی دیسک کاربر برای کنترل ریسکهای امنیتی با رشد مجموعه داده.
این تغییر رویکرد، مسئله حافظه را از یک چالش «ذخیرهسازی» به یک چالش «کیوریتوری» یا گزینش تبدیل میکند. برای کاربر عملی، این یعنی درک هوش مصنوعی از ترجیحات او در طول ماهها تقویت میشود، نه اینکه با زمینههای قدیمی و منسوخ شلوغ شود.
با اولویت دادن به پایداری محلی، این سیستم از تضادهای حریم خصوصی در حافظههای ابری فاصله میگیرد. این معماری نشان میدهد که آینده هوش مصنوعی شخصی، کمتر به پنجرههای متنی (Context Window) — مثل میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه — و بیشتر به هرس کردن هوشمند دادهها وابسته است.
گام بعدی شما
- مستندات API مدل HyperMarrow را برای بررسی نحوه پیادهسازی حافظه محلی مطالعه کنید.
- استراتژیهای «فراموشی داده» را در عاملهای هوش مصنوعی خود برای کاهش توهمات بررسی کنید.
- تفاوت سرعت بازیابی دادههای تثبیتشده را با لاگهای خام مقایسه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو