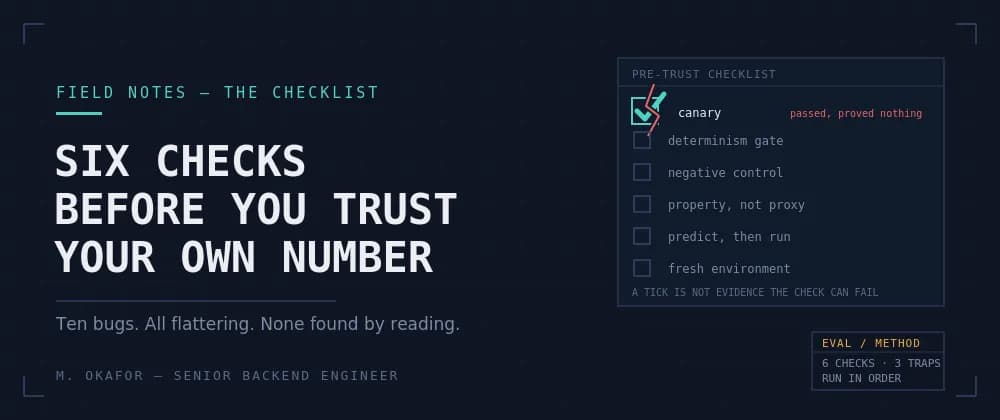
اگر امروز بر اساس اعداد و ارقامی که ابزارهای ارزیابی به شما میدهند تصمیم میگیرید، احتمالاً در حال اعتماد به یک دروغ شیرین هستید. بسیاری از توسعهدهندگان متوجه نمیشوند که ابزار اندازهگیری آنها بهجای گزارش حقیقت، در حال تایید آرزوهای آنهاست. این تنش در ۱۳ سپتامبر ۲۰۲۶ برجسته شد، زمانی که یک توسعهدهنده در وبسایت dev.to تحلیلی هشداردهنده منتشر کرد و توضیح داد که چگونه ۱۰ باگ پنهان در یک سامانه اندازهگیری (Measurement Harness)، نتایج مدلهای هوش مصنوعی را بسیار بهتر از آنچه در واقعیت بودند، نشان میداد. این خطاها بهسادگی از فیلتر بازبینی کد (Code Review) عبور کردند، چون نتایجی «خوشایند» تولید میکردند و غریزه عیبیابی برنامهنویس را تحریک نمیکردند.
سامانههای اندازهگیری در واقع زیرساختهای نامرئی توسعه AI هستند. آنها تصمیم میگیرند که آیا یک بهبود در مدل واقعی است یا صرفاً نویز. اما اکثر توسعهدهندگان با این ابزارها مثل ناظران بیطرف برخورد میکنند؛ در حالی که در واقعیت، یک سامانه اندازهگیری صرفاً کد است. وقتی این کد بهگونهای شکست میخورد که فرضیات و امیدهای شما را تایید کند، احتمالاً تا زمان رسیدن محصول به دست کاربر متوجه آن نخواهید شد.
این وضعیت شبیه به ساختن کیلومترشماری است که بهطور تصادفی هر کاهش سرعت را نادیده میگیرد اما هر شتابی را ثبت میکند. در این حالت، شما باور میکنید ماشینتان سریعتر از آنچه هست است، نه چون دروغ میگویید، بلکه چون ابزارتان نسبت به نتیجهای که دوست دارید، سوگیری دارد. این همان مکانیسم «شکستهای چاپلوس» (Flattering Failures) است که بنچمارکهای هوش مصنوعی را فاسد میکند.
سازوکار شکستهای چاپلوس
عیبیابی معمولاً با «غافلگیری» شروع میشود. وقتی نتیجهای خوشایند است، غافلگیری ایجاد نمیشود. در نتیجه، فیلتری که باگهای اندازهگیری را حذف میکند، بهصورت نامتقارن عمل میکند: در برابر نتایجی که نمیپسندید سختگیر است و در برابر نتایجی که دوست دارید، نرم عمل میکند.
در هر مرحله از فرآیند، باگهای «ناخوشایند» بیشتر از باگهای «چاپلوس» حذف میشوند. پس از چند روز، ابزار اندازهگیری در یک جهت خاص منحرف میشود. چون هیچ بخشی از فرآیند برای شناسایی این انحراف طراحی نشده، خطا باقی میماند. این مکانیسم نیازی به عدم صداقت یا بدخواهی ندارد، و به همین دلیل است که صرفاً «دقت کردن» یا «مراقب بودن» مشکل را حل نمیکند.
مجموعه اعتبارسنجی اجرا
برای مقابله با این وضعیت، نویسنده یک چکلیست سختگیرانه پیشنهاد میکند که طراحی شده تا در جایی که غافلگیری وجود ندارد، آن را بهصورت مصنوعی ایجاد کند. هر بررسی بهگونهای طراحی شده تا یک ویژگی خاص را ثابت کند و در عین حال، صراحتاً اعلام کند که چه چیزی را ثابت نمیکند.
گام ۱: قناری (The Canary)
این روش شامل جایگزین کردن مورد مورد آزمایش با چیزی است که غیرقابل تجزیه (Unparseable) باشد و سپس تایید کنیم که سامانه اندازهگیری متوجه این موضوع میشود.
- چه چیزی را ثابت میکند: تغییرات شما واقعاً به مفسر (Interpreter) میرسد.
- چه چیزی را ثابت نمیکند: ایزوله بودن تغییرات، صحت امتیازدهی، یا اینکه یک تغییر «معتبر» به مفسر میرسد.
به نقل از نویسنده، او در یک مورد متوجه شد که نصبهای قابل ویرایش (pip install -e) در بستههایی با ساختار src-layout باعث میشد واردات (Imports) به نسخه اصلی بازگردند. در نتیجه، تغییراتی که در یک کپی موقت نوشته شده بودند، هرگز اجرا نمیشدند. سامانه امتیاز ۰.۰۰۰ را گزارش میکرد و او ابتدا تصور کرد که «این مجموعههای آزمون افتضاح هستند»، نه اینکه «ابزار اندازهگیری من خراب است».
نکته جالب این بود که یک تغییر با طول یکسان بهطور بیصدا نادیده گرفته شد، اما دادههای نامفهوم (Garbage) شناسایی شدند چون طول بایت متفاوتی داشتند و حافظه پنهان بایتکد پایتون را باطل کردند. این نکته ظریف توسط Vinh Nguyen (@vinhnguyenthanhdn) شناسایی شد که پیشنهاد داد برای بستن این شکاف، از نسخهای از قناری استفاده شود که طول بایت را حفظ کند. این ارزانترین بررسی در لیست است و باید پیش از هر اندازهگیری نوشته شود.
گام ۲: دروازه قطعیت (The Determinism Gate)
این گام مستلزم اجرای سه بارهی امتیازدهی بهصورت متوالی و متوالی است، بهطوری که خروجیها در سطح بایت کاملاً یکسان باشند.
- چه چیزی را ثابت میکند: اجرا بین دفعات مختلف کاملاً ایزوله است.
- چه چیزی را ثابت نمیکند: اینکه فایل درست اجرا میشود. سه اجرای یکسان از یک فایل غلط، باز هم کاملاً قطعی (Deterministic) هستند.
در این مورد، مقصر اصلی «اجرای موازی» (Parallel Execution) بود. اجرای همزمان تغییرات در یک هدف که I/O نامتقارن واقعی داشت، در چهار اجرا، سه نتیجه متفاوت تولید میکرد. نویسنده پیش از این بر اساس این دادهها ادعای بهبود کرده بود، اما آن بهبود صرفاً نویز بود.
بسیار حیاتی است که درک کنیم قناری و دروازه قطعیت جایگزین هم نیستند. قناری در حالی پاس میشود که اجرای موازی نتایج را فاسد میکند؛ و دروازه قطعیت در حالی پاس میشود که واردات به فایل غلط ارجاع داده میشوند. شما به هر دو نیاز دارید.
مقابله با سخاوتمندی ابزار
گام ۳: کنترل منفی (The Negative Control)
این روش مستلزم ساخت موردی است که امتیاز آن باید نزدیک به صفر باشد؛ مثلاً مجموعهای که هیچ چیز معناداری را وارد، فراخوانی یا تایید نمیکند. اگر یک مجموعه توخالی امتیاز بالایی بگیرد، یعنی سامانه بیش از حد سخاوتمند است.
- چه چیزی را ثابت میکند: امتیازدهی شما بهگونهای سخاوتمند نیست که در حالت عادی هرگز متوجهش شوید.
- چه چیزی را ثابت نمیکند: هیچ چیزی درباره سقف یا بالای محدوده امتیازات.
این روش که توسط Ahmet Özel (@ahmetozel) پیشنهاد شد، منطق سامانه را وارونه میکند. در هر جای دیگر، امتیاز بالا خوب است و امتیاز پایین باعث بررسی میشود. اما در کنترل منفی، امتیاز بالا زنگ خطر است. این تنها شرایطی است که یک شکست چاپلوس «غافلگیرگیرنده» میشود و تنها زمانی است که عیبیابی بهطور قابلاعتمادی فعال میشود.
یک محدودیت طراحی حیاتی وجود دارد: کنترل باید در صورتی که بهدلیل یک دلیل پیشپاافتاده پاس شود، بهشدت خطا دهد. امتیاز نزدیک به صفر زمانی هم رخ میدهد که هیچ چیزی بارگذاری نشود. بنابراین، کنترل باید بهطور جداگانه تایید کند که مجموعه روی سورس تمیز پاس میشود و ماژول واقعاً وارد و اجرا شده است.
در پروژه نویسنده، کنترل مقدار صفر برنگرداند، بلکه ۷ از ۵۱ را برگرداند. توضیح این مورد یک حقیقت کالیبراسیون بود: عبارت assert x is not None یک آشکارساز واقعی است، هرچند بسیار محدود. هر هفت مورد شناسایی شده مربوط به همین یک عملگر بود. اگر کنترل کاملاً تمیز (صفر) برمیگشت، هیچ چیز به نویسنده نمیآموزاند.
گام ۴: تایید ویژگی، نه جایگزین (Property, Not Proxy)
در هنگام نوشتن تستهای رگرسیون (Regression Test)، بهجای بررسی سیگنالی که با صحت همبستگی دارد، خودِ ویژگی مورد نظر را بررسی کنید.
- جایگزین (Proxy): سیگنالی که با صحت مرتبط است (مثلاً
assert count_cache_files(workdir) == 0). - ویژگی (Property): رفتار واقعی (مثلاً
assert after != beforeپس از یک تغییر). - چه چیزی را ثابت میکند: رفتاری که به آن وابسته هستید واقعاً برقرار است.
- چه چیزی را ثابت نمیکند: اینکه شما ویژگی (Property) درستی را انتخاب کردهاید.
وقتی نویسنده مشکل بایتکد را حل کرد، از یک جایگزین استفاده کرد که تایید میکرد تعداد فایلهای کش در کپی موقت صفر است. اما با تنظیم PYTHONPYCACHEPREFIX بایتکدها به یک درخت مرکزی میرفتند که بر اساس مسیر مطلق کلیدگذاری شده بود. تعداد فایلهای کش در کپی صفر بود، اما خوانش قدیمی باز هم رخ میداد. جایگزین تایید شد، اما سامانه دروغ گفت. Vinh Nguyen این مورد را با اجرای سه شاخه مختلف روی ماشین خود برای ایزوله کردن متغیر شناسایی کرد.
برای اینکه این تستها «دندان» داشته باشند، نویسنده توصیه میکند یک متا-تست اضافه کنید که مورد خراب را بازتولید کند. تست رگرسیونی که هرگز شکستش دیده نشده، به اندازه قناریای که نمیتواند شکست را تشخیص دهد، بیفایده است. این رویکرد سختگیرانه برای شناسایی باگهای پنهان، یادآور پروتکل سه-مرحلهای MonkeyCode است که برای توقف خطاهای تولید شده توسط هوش مصنوعی طراحی شده است.
لایه انسانی و محیطی
گام ۵: پیشبینی نتیجه پیش از اجرا
این یک عادت است نه یک بررسی کد. پیش از هر تشخیص، انتظار خود را در یک خط بنویسید. هر تضادی را دلیلی برای توقف و بررسی بدانید، نه چیزی برای توجیه آنی.
- چه چیزی را ثابت میکند: بهتنهایی هیچ چیز را ثابت نمیکند.
- ارزش منحصربهفرد: غافلگیری را در جایی ایجاد میکند که در غیر این صورت وجود نداشت.
این عادت ۴ مورد از ۱۰ باگ را شناسایی کرد. برای مثال، نویسنده میدانست یک تست خاص تولید شده خراب است و پیشبینی کرد حذف آن باعث سبز شدن مجموعه شود. وقتی این اتفاق نیفتاد، متوجه باگی شد که در مرحله بازسازی، واردات مشترک را حذف میکرد و شکستهای جعلی میساخت. چون امتیازها منطقی به نظر میرسیدند و در جهتی که دوست داشت، حرکت میکردند، فقط پیشبینی قبلی خطا را لو داد.
گام ۶: اجرا در محیط غیرتوسعه
ابزار را در یک محیط تازه، خارج از پوشه توسعه خودتان نصب کنید و آن را روی مخزنی بگیرید که برای آن ساخته نشده است.
- چه چیزی را ثابت میکند: ابزار برای کسی غیر از شما هم کار میکند.
- چه چیزی را ثابت نمیکند: صحت مطلق؛ بلکه ثابت میکند صحت برای دیگران قابل دستیابی است.
این گام دهمین باگ را شناسایی کرد. نویسنده مشکلی را در ۱۲ مخزن منتخب حل کرده بود، اما در رابط خط فرمان (CLI) فراموش کرده بود این بررسی را به دستور اصلی متصل کند. یک کاربر غریبه با استفاده از ابزار روی یک پروژه معمولی، امتیاز ۰.۰۰۰۰ را بدون هیچ هشدار دریافت میکرد. محیط توسعه تنها پیکربندی بود که نویسنده بهطور تصادفی آن را بهینه کرده بود و همین باعث شد محیطی باشد که کاربران کمتر از همه احتمال بازتولید آن را دارند. این تجربه نشان میدهد که حتی با وجود تستهای گسترده، برخی حفرهها باقی میمانند؛ مشابه آنچه در بررسی Traceguard ۱.۶.۰ رخ داد که در آن دو حفره امنیتی از میان هزاران تست سبز عبور کردند.
شکاف امتیازدهنده (The Scorer Gap)
باید توجه داشت که این ۶ گام، مسیر اجرا را تایید میکنند، نه امتیازدهنده (Scorer) را — یعنی کدی که نتیجه را میخواند، معنای آن را تعیین میکند و تجمیع میکند. ۳ مورد از ۱۰ باگ در سطح امتیازدهنده بودند: یک طبقهبندیکننده که روی واحد غلط اجرا میشد، یک مرحله بازسازی که واردات مشترک را حذف میکرد و یک سبک تایید (Assertion) که برای طبقهبندیکننده نامرئی بود.
همانطور که Zain Dana Harper (@zaindanaharper) اشاره کرد، یک آرتیفکت سالم به شما نمیگوید که آیا ابزاری که آن را تفسیر میکند درست است یا خیر. یک گزارش میتواند از نظر ساختاری بینقص و در سطح بایت تایید شده باشد اما عددی غلط را حمل کند.
برای بستن این شکاف، نویسنده در حال ساخت سه بررسی جدید است:
۱. فیکسرهای با نتیجه معلوم (Known-outcome fixtures): تایید اینکه خط لوله پاسخی را گزارش میکند که از پیش بر اساس ساختار معلوم است.
۲. ناورداهای حفاظتی (Conservation invariants): اطمینان از اینکه تعدادها در هر مرحله با هم همخوانی دارند.
۳. متادیتای صریح واحدها (Explicit unit metadata): اجازه دادن به مصرفکننده برای تایید آنچه دریافت میکند بهجای فرض کردن.
یکی از اینها بلافاصله باگی را پیدا کرد: یک طبقهبندیکننده خروجی را تنها زمانی «خطای مجموعه» مینامید که عبارت خاصی در خروجی باشد، عبارتی که نسخه فعلی pytest هرگز تولید نمیکرد. این منجر به یک دستهبندی خالی شد که نویسنده آن را بهعنوان یک یافته منتشر کرده بود: «صفر خطا در تمام ۱۲ هدف». این موضوع بهعنوان تضمین کیفیت داده خوانده شد، در حالی که در واقع امضای یک کد مرده بود.
پیادهسازی و موازنه
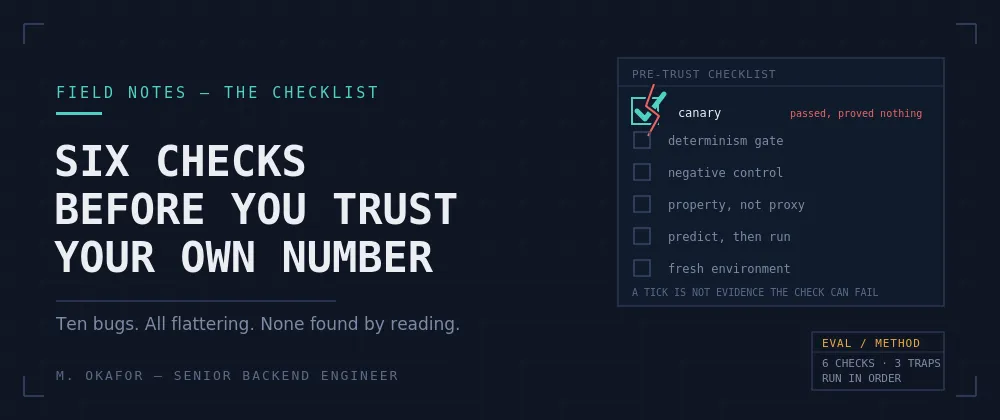
برای کسانی که سامانههای ارزیابی میسازند، ترتیب عملیات حیاتی است چون وقتی به نتایج وابسته میشوید، اجرای صادقانه بررسیها سختتر میشود:
۱. قناری: پیش از هر اندازهگیری.
۲. دروازه قطعیت: پیش از اعتماد به هر عددی.
۳. کنترل منفی: پیش از تفسیر یک نتیجه خوب.
۴. محیط تازه: پیش از اینکه هر کس دیگری ابزار را اجرا کند.
۵. ویژگی بهجای جایگزین: هر بار که تست رگرسیون نوشته میشود.
۶. پیشبینی سپس اجرا: در هر تشخیص، برای همیشه.
سه تلهای که هیچ بررسیای آنها را نمیگیرد
برخی تصمیمات امتیازدهی باید آگاهانه گرفته شوند چون هیچ بررسی خودکاری آنها را نمیگیرد:
- امتیازدهی دستهای در برابر تستی (Batch vs. Per-Test): اگر یک مورد خراب کل دسته را باطل کند، عدد بهدستآمده یک «کف» (Floor) است، نه اندازهگیری. هر دو روش قابل دفاعاند، اما باید صراحتاً ذکر کنید از کدام استفاده میکنید.
- تطبیق بودجه (Budget Matching): هنگام مقایسه روشهایی با هزینههای متفاوت، واحد خنثی وجود ندارد. تطبیق تعداد فراخوانیها باعث محدود شدن خروجی یک طرف میشود و تطبیق توکنهای خروجی، طرف دیگر را بازسازی میکند. بردار کامل منابع را گزارش کنید و ذکر کنید که واحد را پیش از دیدن نتایج انتخاب کردهاید.
- کنترلها در تعداد کم (Small n): از تزیین یک کنترل ضعیف (مثلاً با مخرج ۱) برای واقعی جلوه دادن آن بپرهیزید. اعتراف به نبود کنترل بهتر از انتقال اعتماد بیاساس است.
نتیجهگیری: انتشار ابزار
ده باگ، همگی چاپلوس، و هیچکدام با بازبینی کد پیدا نشدند. بعدها دو خواننده با اشاره به «بررسیها» بهجای «اعداد»، دو باگ دیگر را پیدا کردند. در هیچکدام از این موارد نتایج تغییر نکرد، اما ثابت شد که ابزار اندازهگیری غلط است.
این استدلال اصلی برای انتشار «ابزار» بهجای «یافته» است. یک نتیجه، ادعایی است که مردم میتوانند بپذیرند یا رد کنند؛ اما یک ابزار چیزی است که میتوان به آن حمله کرد، و همین حملات است که به شما میگوید ابزار واقعاً کار میکند یا خیر.
گام بعدی شما
- پیادهسازی تست قناری: همین امروز در هر سامانه ارزیابی، یک مورد با دادههای نامفهوم (Garbage) اضافه کنید تا مطمئن شوید خطاهای اجرا را شناسایی میکنید.
- اعمال دروازه قطعیت: برای هر بنچمارک حساس، یک اجرای سه باره متوالی تعریف کنید تا نویزهای ناشی از اجرای موازی یا I/O را حذف کنید.
- ثبت پیشبینیها: در هر بار اجرای تست، ابتدا نتیجه مورد انتظار را مکتوب کنید تا غریزه «توجیه نتایج خوشایند» را مهار کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو