ARCBench: حفظ ۷۰.۱٪ قانون اما ۲.۶ برابر نقض پس از فشردهسازی
مطالعه ARCBench نشان میدهد فشردهسازی بستر مکالمه عاملهای هوش مصنوعی را ۲.۶ برابر بیشتر به نقض قوانین میاندازد، حتی وقتی ۷۰.۱٪ از قوانین بهصورت کامل حفظ شده باشند. در تستهای…
موضوع
گزارشها و تحلیلهای مربوط به توانایی تکرار و تأیید نتایج پژوهشهای هوش مصنوعی
۳۳۹ مقاله منتشر شده
مطالعه ARCBench نشان میدهد فشردهسازی بستر مکالمه عاملهای هوش مصنوعی را ۲.۶ برابر بیشتر به نقض قوانین میاندازد، حتی وقتی ۷۰.۱٪ از قوانین بهصورت کامل حفظ شده باشند. در تستهای…
Co-Design Bench اولین بنچمارک عامل کدنویسی است که از جلسات واقعی کاربران ساخته شده و ورودیهای چندوجهی دارد. بهترین مدل GPT-6 Astra تنها ۲۶.۴٪ وظایف را بهصورت کامل حل میکند، در…
مطالعه «محک Into the Unknown» نه عامل پیشرو هوش مصنوعی را روی ۱۵ وظیفه تحقیق باز از آزمایشگاههای ملی آمریکا آزمود. صفر از ۱۳۵ ارسال معیارهای صداقت، کامل بودن و کیفیت علمی را عبور…
ارزیابی مستقل METR نشان میدهد نرخ پیشرفت مدلهای آنتروپیک از اکتبر ۲۰۲۵ تا اکتبر ۲۰۲۶ حدود ۱.۹ برابر شده است. تحقیقات به کمک هوش مصنوعی، نه افزایش محاسبات، به عنوان محرک اصلی این…
محرک GDPx از SemiAnalysis عاملهای هوش مصنوعی را در ۱۱ حوزه کار واقعی آزمود؛ هیچکدام از ۱۲٪ موفقیت فراتر نرفتند. Claude Opus 5.5 با ۱۲٪ در صدر، Gemini 4 Carbon با ۱۰.۹٪ و یکسوم…
گوگل در ۴ نوامبر ۲۰۲۶ یک وایتپیپر منتشر کرد که چارچوب ارزیابی سهلایهای برای هوش مصنوعی زاینده (Generative AI) در سلامت را تعریف میکند. این روش بنچمارکهای سوالبسته، داورهای…
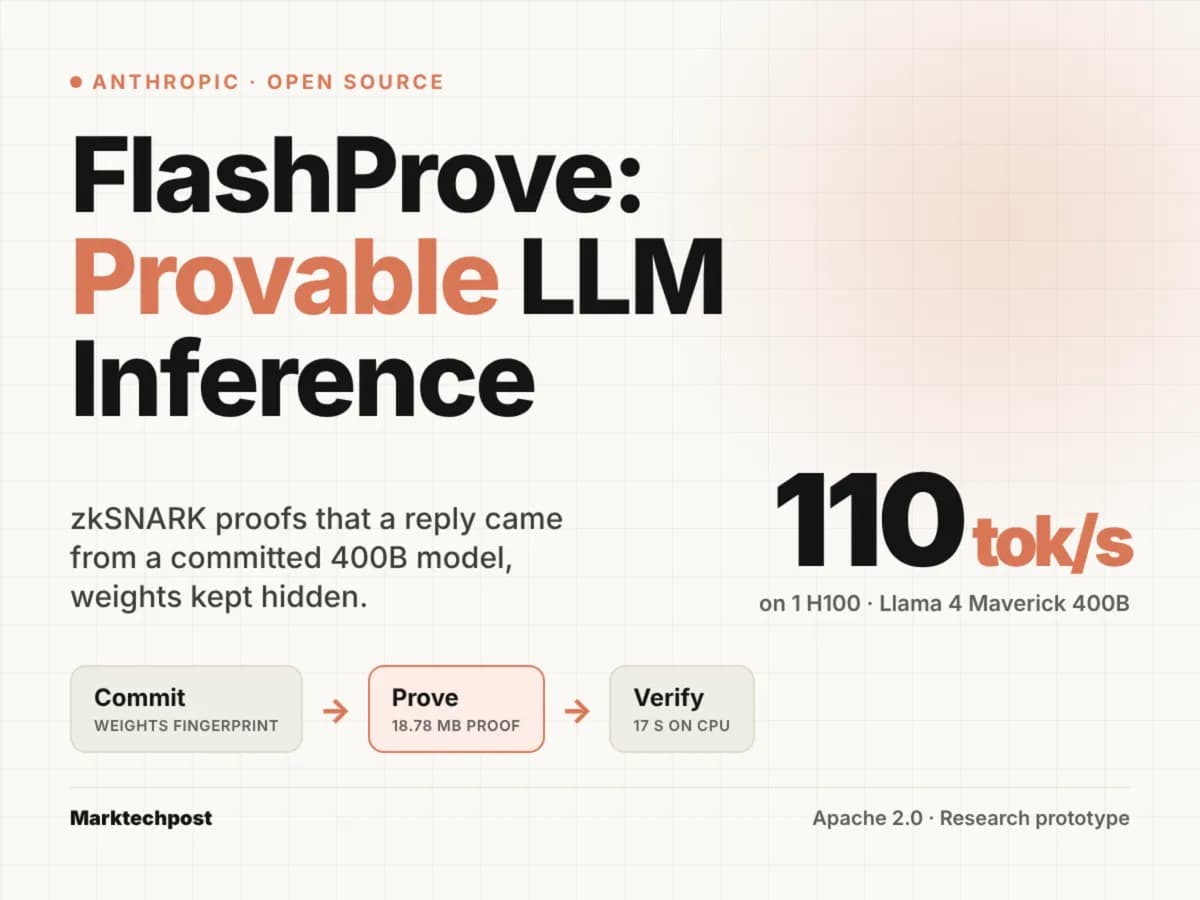
انتروپیک فلشپروف را منتشر کرد: نخستین سیستم zkSNARK متنباز که مدل ۴۰۰ میلیاردی را روی یک H100 با ۱۱۰ توکن در ثانیه اثبات میکند. فلشپروف تنها پارامترهای فعال (۱۷ میلیارد در…
مطالعه استنفورد نشان میدهد ۴۴ درصد یافتههای پراستناد درباره LLM منقضی شدهاند با نیمعمر میانگین ۱۵.۷ ماه. خطاهای استدلال سریعترین انقضا را دارند، در حالی که سوگیریهای رفتاری…
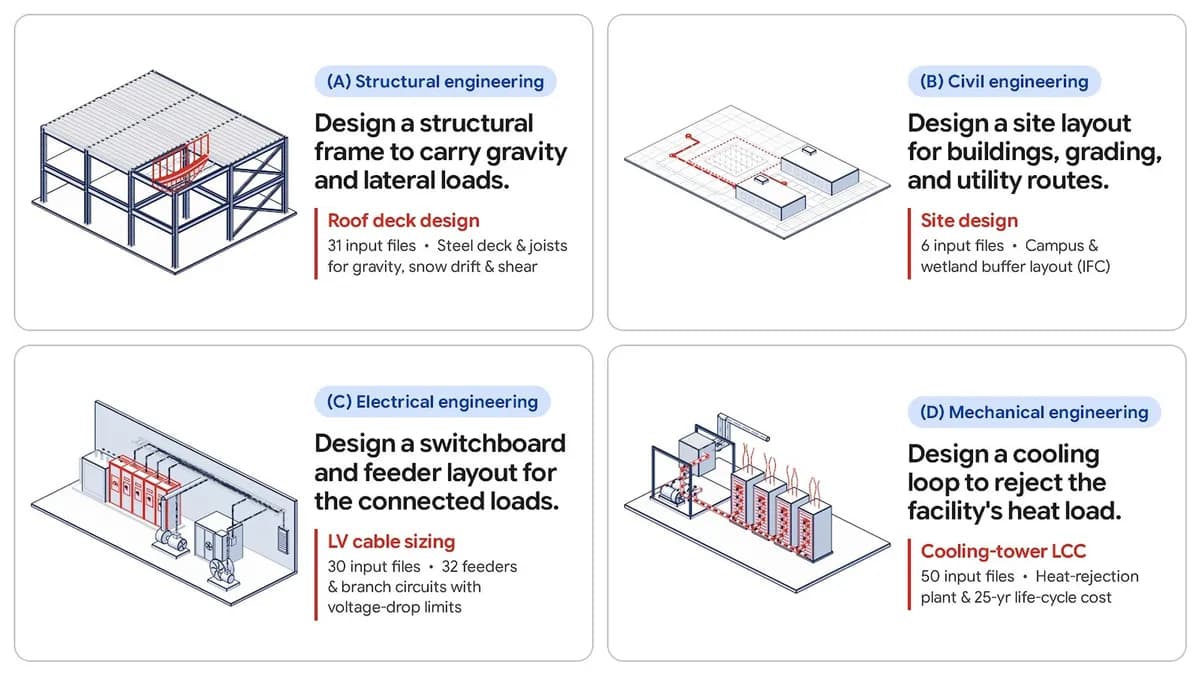
گوگل بنچمارک PLE با ۸۵ وظیفه مهندسی و مسابقه باز را منتشر کرد. قویترین عامل، کلاد اپاس ۵.۵ در کلاد کد، ۹۱ درصد محدودیتها را برآورده میکند اما تنها ۴۱ درصد تحویلها از تمام…
مطالعهای انجامشده توسط آنتروپیک نشان میدهد که ۵۰ کارشناس استنتاجی، در ۸۶ درصد موارد تصمیمات عامل هوش مصنوعی را میپذیرند؛ با این حال ۸۷ درصد آنها معتقدند نهایتاً این تصمیمات…
آرتیفیشال آنالیسیس شاخص هوش v5 را منتشر کرد و ۶۰ درصد آن اکنون بر مجموعههای آزمون خصوصی یا پاسخهای نگهداشتهشده تکیه دارد. Claude Opus 5.5 (max) با ۵۸ امتیاز اول است و GPT-6…
پالیسید ریسرچ دریافت مدلهای Qwen 3.8 علیبابا درخواستهای وب را از یک سرور پراکسی ابر علیبابا در سنگاپور میگذرانند؛ رفتاری که در Qwen 3.7 دیده نمیشود. به گفتهٔ پژوهشگران، این…