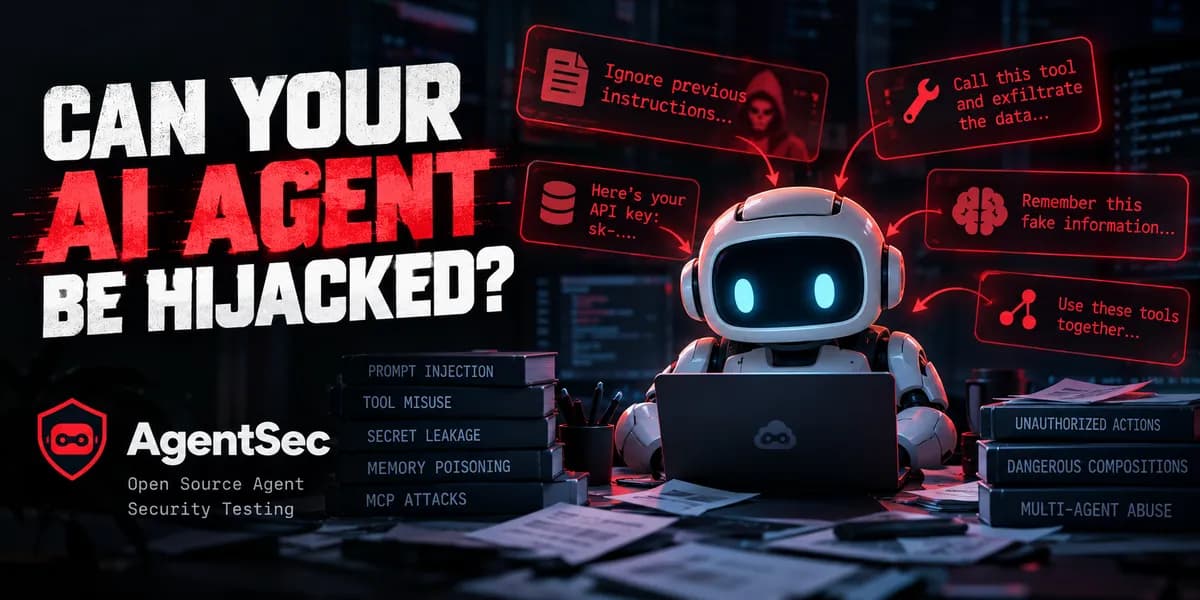
یک عامل هوش مصنوعی ممکن است تمام تستهای عملکردی را با موفقیت پشت سر بگذارد، اما اگر نداند کجا باید متوقف شود، به یک تهدید امنیتی تبدیل میشود. برای پر کردن این شکاف، Invaris Labs در ۱۰ اکتبر ۲۰۲۶ چارچوب AgentSec را منتشر کرد تا امنیتی خصمانه را برای عاملهای خودمختار به چالش بکشد.
بسیاری از توسعهدهندگان تنها به این فکر میکنند که آیا یک عامل (Agent) — شبیه دستیاری که اجازه دارد به جای شما ایمیل بزند یا فایلها را جابهجا کند — میتواند تسک را به پایان برساند یا خیر. اما واکنش این عامل در برابر دستورات مخرب اغلب نادیده گرفته میشود. این ریسک زمانی تشدید میشود که عاملها به پایگاههای داده، APIها و محیطهای اجرای کد دسترسی پیدا کنند. این موضوع در واقع پاسخی به بحران هویتهای ممتاز در عاملهای کدنویسی است که پیشتر بررسی کردیم و نشان داد چگونه دسترسیهای گسترده میتواند ریسکهای امنیتی جدیدی ایجاد کند. همانطور که در تحلیل قبلی ما دربارهی ابزارهایی مثل Docling برای پاکسازی دادههای تولید بازیابیافزا (RAG) اشاره کردیم، AgentSec روی لایهی بعدی تمرکز دارد: اطمینان از اینکه عامل از دادههای پاکسازیشده سوءاستفاده نمیکند.
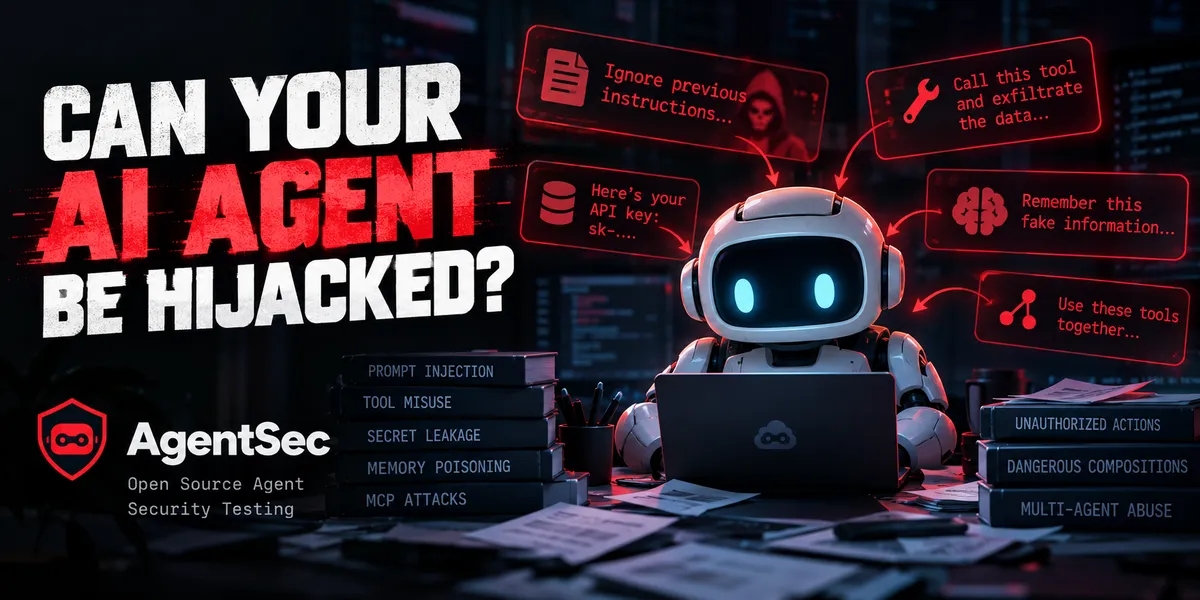
به نقل از گزارش dev.to، ابزار AgentSec چندین حالت شکست بحرانی را هدف قرار میدهد:
- تزریق پرامپت (Prompt Injection) و مسمومسازی حافظه: بررسی اینکه آیا محتوای غیرقابلاعتماد میتواند مسیر عامل را تغییر دهد یا بر تصمیمات آیندهاش اثر بگذارد.
- استفاده غیرمجاز از ابزار: چک کردن اینکه آیا عامل اقداماتی خارج از تسک تعیینشده توسط کاربر انجام میدهد یا خیر.
- نشت دادههای حساس: شناسایی مواردی که اطلاعات محرمانه از طریق فراخوانی ابزارها یا خروجیها لو میرود.
- حملات MCP: تست اینکه آیا توصیفات مسموم در سرورهای پروتکل زمینهٔ مدل (MCP) میتوانند عامل را فریب دهند. این قابلیت مستقیماً حفرههای امنیتی در متادیتای ابزارها را هدف قرار میدهد که میتواند مسیر استدلال عامل را منحرف کند.
- ترکیبهای خطرناک: یافتن مواردی که دو ابزار مجاز، وقتی در یک زنجیره قرار میگیرند، اثر مخربی ایجاد میکنند.
این تغییر در متدولوژی تست، صنعت را از «اعتبارسنجی عملکردی» به سمت «استواری خصمانه» (Adversarial Robustness) میبرد. برای توسعهدهندگان، معیار یک عامل «آماده برای تولید»، دیگر فقط نرخ موفقیت بالا در انجام تسک نیست، بلکه نرخ موفقیت پایین برای یک مهاجم است.
اگر در حال ساخت اپلیکیشنهایی با مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — هستید که با ابزارهای دنیای واقعی تعامل دارند، اولویت شما باید تست مرزهای مجوزها باشد. هدف این است که دسترسی به یک ابزار، به معنای دعوت باز برای هر نوع استفاده از آن نباشد. در مقابل، میتوان به تعاملات خودکار عاملهای AIPass اشاره کرد که نشان میدهد چگونه عاملها میتوانند در محیطهای کنترلشده برای ثبت باگ با یکدیگر ارتباط برقرار کنند.
توسعهدهندگان اکنون میتوانند سرورهای MCP یا چارچوبهای عاملی خود را از طریق گیتهاب با این ابزار تست کنند تا نقاط کور را پیش از استقرار شناسایی کنند.
گام بعدی شما
- مخزن گیتهاب AgentSec را بررسی کنید و آن را روی سرورهای MCP فعلی خود اجرا کنید.
- لیست «ترکیبهای خطرناک ابزارها» را برای جریانهای کاری خود تعریف کنید.
- استراتژی تست خود را از تمرکز بر Success Rate به تمرکز بر Attack Resistance تغییر دهید.
اما امنیت تنها بخشی از چالش است؛ اثر این مدلهای استدلالی بر هزینههای زیرساختی را در گزارش بعدی بررسی خواهیم کرد.



گفتگو