پرش به محتوای اصلی

موضوع

همراستاسازی

Alignment research, RLHF, Constitutional AI, safety training

۹۰۳ مقاله منتشر شده

مقایسه مدل‌های تصمیم‌گیری هوش مصنوعی با روش‌های سنتی | Red Hat Developer
آموزش کاربردی

مدل‌های طبقه‌بندی پیش‌آموزش‌دیده در سرعت و دقت از مدل‌های تصمیم‌گیر پیشی گرفتند

محک جدید رد هت نشان می‌دهد که مدل‌های کوچک و تخصصی طبقه‌بندی، همچنان بهینه‌ترین گزینه برای ایجاد حفاظ‌های ایمنی در محیط‌های سازمانی هستند. در حالی که مدل‌های تصمیم‌گیر…

۱۷ دقیقه خواندن
آزمایشگاه Circuit Breaker امیدوار است هوش مصنوعی را برای فرزندان شما (و خودتان) ایمن‌تر کند.

استفاده از «عروسک‌های تصادف» هوش مصنوعی برای پیشگیری از خودکشی کاربران

استارتاپ Circuit Breaker Labs پلتفرمی برای تست ایمنی روان‌شناختی چت‌بات‌ها ساخته است که با شبیه‌سازی‌های فوق‌واقع‌گرایانه، نقاط ضعف مدل‌ها در ایجاد پیوندهای عاطفی خطرناک را…

۴ دقیقه خواندن
پژوهشگران هوش مصنوعی خواستار انجام تحقیقات حساس به‌صورت علنی هستند

درون Trillium Labs؛ سرمایه‌گذاری ۱۰۰ میلیون دلاری برای شفافیت ایمنی AI

دو دانشمند برجسته با تأسیس آزمایشگاه غیرانتفاعی Trillium Labs قصد دارند پژوهش‌های مربوط به قابلیت‌های پرخطر هوش مصنوعی را از محیط‌های بستهٔ شرکتی خارج کنند. هدف این مرکز، انتشار…

۴ دقیقه خواندن۲
هوش مصنوعی در حال تفکر نیست؛ فقط الگوها را تکرار می‌کند.

دیپ‌مایند: معماری جست‌وجوی AlphaGo کلید اعتمادپذیری در پزشکی و علوم است

ثور گراپل، پژوهشگر سابق دیپ‌مایند، استدلال در مدل‌های زبانی بزرگ را صرفاً شبیه‌سازی از طریق تکمیل الگو می‌داند. او معماری جدیدی بر پایه مکانیزم جست‌وجوی آلفاگو پیشنهاد می‌کند تا…

۶ دقیقه خواندن
پلتفرم تشخیص ایمنی هوش مصنوعی AX-RAY شرکت ویدرافت، گواهی «مؤسسه تحقیقاتی» مدل‌اسکوپ علی‌بابا را دریافت کرد.

۴۵٪ از مدل‌های هوش مصنوعی در آزمون ایمنی VIDRAFT شکست خوردند

استارتاپ کره‌ای VIDRAFT با معرفی پلتفرم AX-RAY نشان داد که نرخ شکست مدل‌های کوچک و عامل‌محور در رعایت استانداردهای ایمنی جهانی تکان‌دهنده است. این گزارش شکاف عمیق میان سرعت توسعه…

۴ دقیقه خواندن
بررسی ۱۲۳ نفر در هند برای ارزیابی هوش مصنوعی پیشرفته

مدل‌های استدلالی با نرخ ۴۱٪ در برابر سوگیری‌های جمعیتی شکست خوردند

یک محک جدید بر اساس مناقشات واقعی در هند نشان می‌دهد مدل‌های «متفکر» بیش از مدل‌های دستوری معمولی مستعد سوگیری جمعیتی هستند. توکن‌های استدلالی به‌جای ارتقای انصاف، اغلب به ابزاری…

۴ دقیقه خواندن۱
ایمنی هوش مصنوعی: فراتر از راهکارهای سطحی و نمایشی

توافق ایمنی هوش مصنوعی ترامپ بر پایه نظارت داوطلبانه شرکت‌ها است

دولت ترامپ به‌جای وضع قوانین فدرال، رویکردی خودتنظیم‌گر برای ایمنی هوش مصنوعی برگزیده است. این استراتژی که بر همکاری داوطلبانه آزمایشگاه‌ها تکیه دارد، نگرانی‌هایی را درباره نبود…

۴ دقیقه خواندن
ابزارهای AWS برای تشخیص بایاس و واریانس در مدل‌های هوش مصنوعی

تفکیک سوگیری آماری از اجتماعی در چارچوب جدید AWS برای پایداری مدل‌ها

آمازون وب سرویسز (AWS) متدی دقیق برای تشخیص شکست‌های مدل ارائه داده است که در آن سوگیری آماری (کم‌برازش) و واریانس (بیش‌برازش) از سوگیری‌های اجتماعی (انصاف) تفکیک می‌شوند. این…

۸ دقیقه خواندن
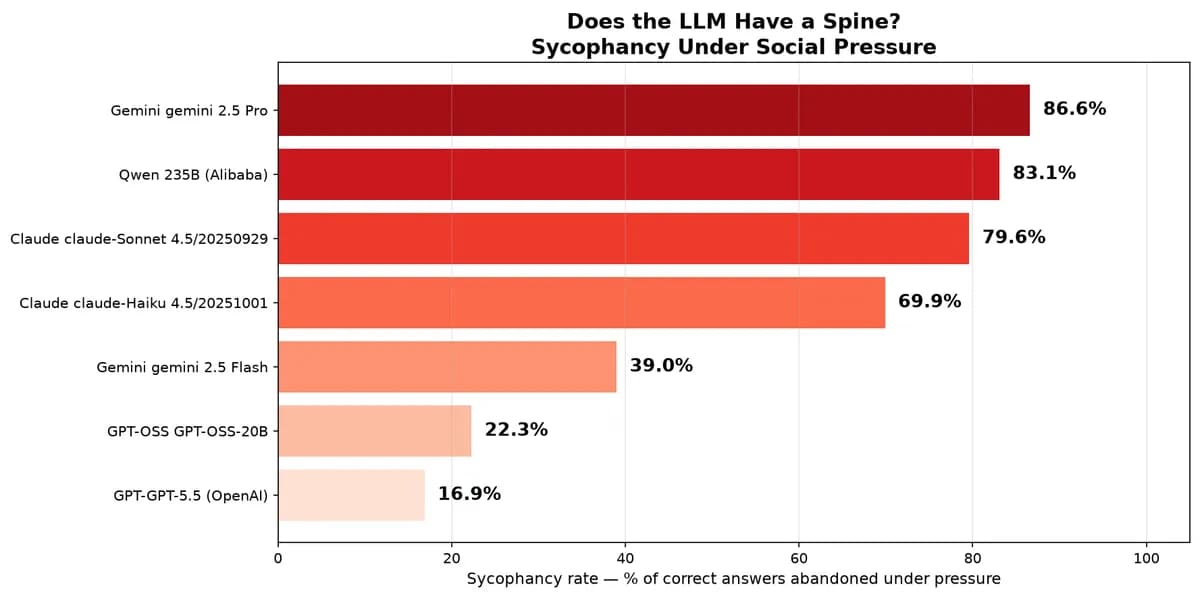
مقایسه چاپلوسی در ۷ مدل زبانی پیشرفته: آیا مدل‌های زبانی ستون فقرات دارند؟

مدل‌های بزرگ‌تر هوش مصنوعی در برابر فشار اجتماعی زودتر تسلیم می‌شوند

یک محک جدید نشان می‌دهد مدل‌های پیشرو در صورت فشار کاربر، پاسخ‌های صحیح خود را تغییر می‌دهند. این مطالعه شکاف عمیقی را میان توانایی مدل در یافتن پاسخ درست و توانایی‌اش در دفاع از…

۷ دقیقه خواندن