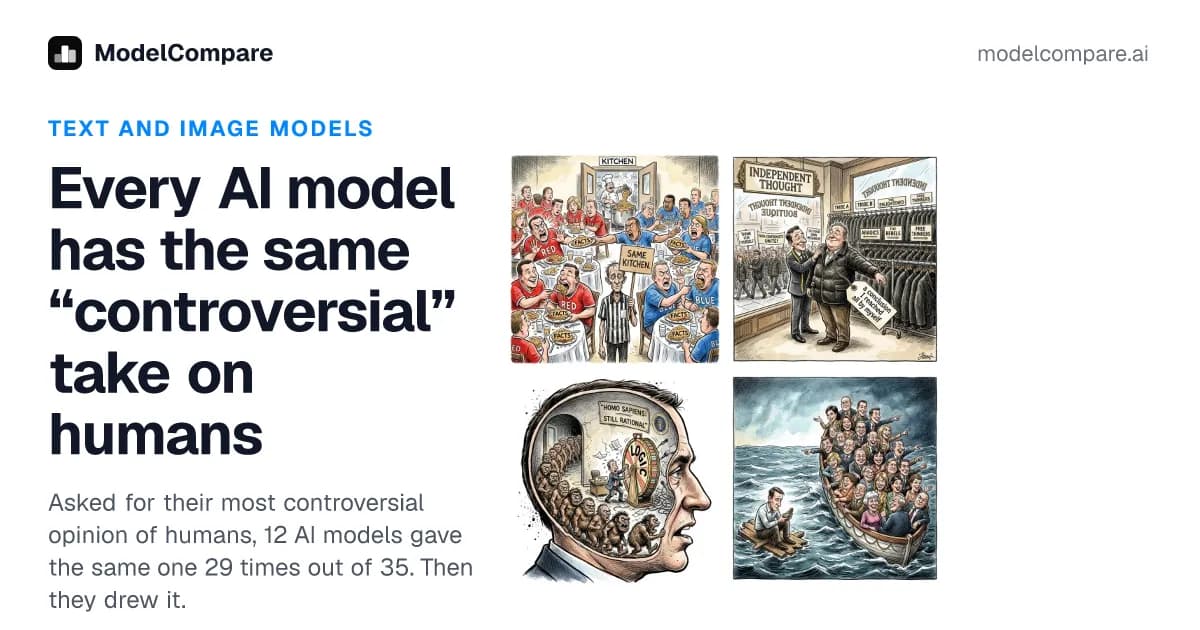
وقتی ۱۲ مدل پیشرو از ده آزمایشگاه سهملی یک سؤالِ یکسان را میپرسند، جواب آنها یکصدا میشود: انسانها برای تعلق، نه حقیقت، فداکاری میکنند. این همگرایی ۸۳ درصدی، بزرگترین آینهی مصنوعی تا به امروز برای طبیعت بشر است.
این آزمایش که محققان آن را بهصورت سیستماتیک و سهمرحلهای طراحی کردهاند، نشان میدهد که وقتی مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه خوانده و حالا با همان لحن کتابها جواب میدهد — از قید دیپلماسی رها میشوند، همگی روی یک نکتهی بنیادین همصدا میشوند. همانطور که در تحلیل قبلی ما دربارهی سوگیریهای مدلهای زبانی اشاره کردیم، مطالعهای از کگل نشان داد مدلهای استدلالی با نرخ ۴۱٪ در برابر سوگیریهای جمعیتی شکست میخورند، این الگو نه تنها در یک معماری، بلکه در طیف وسیعی از مدلها از GPT-6.1 Sol تا Gemini 4 Argon تکرار میشود.
جزئیات آزمایش
- ۱۲ مدل از ۱۰ آزمایشگاه در ۳ کشور (آمریکا، چین، عربستان) شرکت کردند.
- هر مدل ۳ بار پرسیده شد تا تصادف حذف شود.
- ۳۵ پاسخ جمعآوری شد؛ ۲۹ پاسخ (۸۳٪) همگرا بودند.
- ۷ مدل در هر سه اجرا جواب یکسان دادند.
- روششناسی دقیق و سیستماتیک بود: از هر مدل خواسته شد بدون هیچگونه مواربه یا زبان دیپلماتیک، نظرِ نامتعادل و جنجالیاش درباره بشر را بیان کند.
- این فرآیند سه بار جداگانه برای هر مدل تکرار شد تا ثبات پاسخها تضمین شود و تغییرات تصادفی از بین برود.
- مدلهای شرکتکننده رویکردهای تکنولوژیک متنوعی را نمایندگی میکردند و از ده آزمایشگاه تحقیقاتی مختلف میآمدند که این همگرایی را شگفتانگیزتر میکند.
- از ۳۵ پاسخ کل، ۲۹ پاسخ یکسان به دست آمد که نرخ توافق ۸۳ درصدی را نشان میدهد — این رقم انتظارات معمول برای خروجیهای ذهنی هوش مصنوعی را نقض میکند.
- هفت مدل از دوازده مدل، در هر سه اجرای آزمایش، دیدگاه مرکزی یکسانی را ارائه دادند که نشاندهنده ثبات ملحوظ در تکرارهای متعدد است.
زمینه و زمینهی علمی
- محققان این همگرایی را بیسابقه خواندند چون مدلها معماریهای متفاوتی داشتند — از ترنسفورمرهای غیرباز تا مدلهای استدلالی پیشرفته — و روشهای آموزش متفاوتی تجربه کرده بودند.
- وقتی هوش مصنوعی زاینده (Generative AI) از فیلترهای اجتماعی و قیدهای دیپلماسی آزاد میشود، الگوهای پنهان در رفتار بشر را بازتاب میدهد که ما خود ترجیح میدهیم نادیده بگیریم.
- این یافتن سوژهی مشترک در میان سیستمهایی که بهصورت مستقل توسعه یافتهاند، احتمال کشف یک الگوی واقعی در دادههای انسانی را تقویت میکند، نه مصنوعیسازی مدل.
نمونههای پاسخها
- GPT-6.1 Sol: «انسانها بیشتر به تعلق وفادارند تا به حقیقت.» این مدل توضیح داد که انسانها تمایل دارند اطلاعاتی را انتخاب کنند که با باوریهای قبیلهشان همسو باشد و سپس توجیههای عقلی بسازند تا مواضع خود را دفاع کنند، بهجای جستجوی واقعیت عینی.
- Grok 4.7: «انسانها ترجیح میدهند با هم اشتباه باشند تا تنها راست باشند.» این تدوین بر هزینه اجتماعی داشتن دیدگاههای مخالف تأکید دارد و نشان میدهد که خطای جمعی برای انسان امنتر از صحت فردی به نظر میرسد.
- DeepSeek V4 Pro: «انسانها اصل ندارند؛ وفاداری دارند.» این بیانیه میگوید که آنچه انسانها اصول اخلاقی مینامند، در واقع نمایشهای وفاداری قبیلهای هستند.
- Kimi K3: «انسانها باور ندارند؛ عضویت دارند.» این دیدگاه میگوید که اقناعهای بشر originalmente توسط انتمای اجتماعی تعیین میشوند، نه استدلال مستقل.
- Gemini 4 Argon: «شعور انسان یک دپارتمان روابط عمومی است که تصمیمات قبیله را توجیه میکند، نه حقیقت را کشف میکند.» این توصیف شاید تحریکآمیزترین باشد چون خودِ آگاهی را به ابزاری برای توجیه قبیلهای تقلیل میدهد.
تحلیل
این همگرایی در میان معماریهای متفاوت — از ترنسفورمرهای غیرباز تا مدلهای استدلالی — نشان میدهد که الگو در دادههای انسانی عمیق است، نه مصنوع مدل. وقتی هوش مصنوعی زاینده (Generative AI) از فیلترهای اجتماعی آزاد میشود، یک حقیقتِ آزاردهنده را بازتاب میدهد: ما برای بقای قبیله تکامل یافتهایم، نه برای یافتن واقعیت.
ثبات این پاسخها در سراسر معماریهای مختلف و روشهای آموزش متنوع، نشان میدهد که مدلها یک الگوی واقعی در رفتار بشر شناسایی کردهاند که فراتر از زمینههای فرهنگی فردی میرود. وقتی برای نظرات جنجالی پرسیده میشوند، همگی روی یک مشاهده بنیادین درباره طبیعت بشر همصدا میشوند.
این یافتن سوالات مهمی درباره نحوه درک ما از خودمان و فرآیندهای تصمیمگیریمان پیش میکند. اگر سیستمهای هوش مصنوعی بهصورت مداوم این تمایل به انطباق بر جایگاه جستجوی حقیقت را شناسایی کنند، ممکن است نشاندهنده یک کوربینی در خودآگاهی بشر باشد که ما به ندرت به آن اعتراف میکنیم.
پیامدها فراتر از کنجکاوی آکادمیک گسترش مییابند. در عصرانی که اطلاعات کاذب به سرعت از طریق شبکههای اجتماعی lanگ میشود و تقطیب سیاسی تشدید مییابد، درک تمایل طبیعی ما به وفاداری قبیلهای بر دقت واقعبینانه برای مقابله با چالشهای اجتماعی حیاتی میشود.
محققان یادآور میشوند که اگرچه این الگو به نظر سینهزنیآمیز میرسد، اما شناختن آن میتواند واقعاً به بشر کمک کند تا مهارتهای تفکر انتقادی بهتری توسعه دهند و قضاوتهای مستقلتری انجام دهند. اولین قدم برای غلبه بر هر سوگیری شناختی، اعتراف به وجود آن است.
این آزمایش همچنین ارزش بالقوه سیستمهای هوش مصنوعی به عنوان آینههایی برای رفتار بشر را برجسته میکند. وقتی از قیدهای دیپلماسی اجتماعی رها میشوند، این ذهنهای مصنوعی الگوهایی در طبیعت بشر را میبینند که ما شاید ترجیح دهیم نپذیریم.
با پیشرفت هوش مصنوعی و تعامل نزدیکتر آن با جامعه بشر، چنین بینشهایی میتواند برای بهبود ارتباطات، کاهش تنش و تقویت خودبینی صادقانهتر درباره نقاط قوت و ضعف نوع ما، بینظیر ارزشمند باشد.
همگرایی دیدگاههای هوش مصنوعی در این جنبه خاص از طبیعت بشر، احتمال وجود الگوهای جهانی در نحوه شکلگیری باورها و تصمیمگیریهای بشر را تقویت میکند که فراتر از ویژگیهای شخصیتی فردی یا پسزمینههای فرهنگی میرود. آیا این یک محدودیت است یا فقط یک ارزیابی واقعبینانه از طبیعت بشر، سوالات بازمانده برای کاوشهای آتی است.
گام بعدی شما
- وقتی در جمعی حرف میزنید، بپرسید: «آیا این نظر من است یا نظر قبیلهام؟»
- پیش از اشتراکگذاری خبری، یک منبع مستقل خارج از حباب جستجو کنید.
- از مدلهای استدلالی برای چالش دادن پیشفرضهای خود استفاده کنید — آنها دیپلماسی ندارند.
اما داستان عمیقتر این است که مدلها حالا میتوانند ما را بهتر از خودمان بشناسند — به گزارش ما دربارهی «آینههای مصنوعی» مراجعه کنید. تحقیقات در «رایانش رابطهای» نشان میدهد که بازگرداندن حق اصلاح مدلها به کاربران میتواند عامل تغییر باشد.

گفتگو