تصور کنید یک مدل هوش مصنوعی در پروندهای حقوقی، تنها به دلیل نام یا پیشینه قومی متهم، حکم وثیقه را تغییر دهد. این کابوس اکنون به یک واقعیت آماری تبدیل شده است: مدلهای استدلالی پیشرفته، در برابر سوگیریهای جمعیتی بسیار آسیبپذیرتر از مدلهای سادهتر هستند.
طبق تحلیل فنی منتشر شده در ۲ اکتبر ۲۰۲۶ و با استفاده از SDK محکهای Kaggle، مشخص شد که توکنهای تفکر داخلی (Internal Thinking Tokens) در مدلهای پیشرفته، بهجای ابزاری برای عدالت، به موتورهایی برای توجیه سوگیریها تبدیل شدهاند. این یافتهها نشان میدهد که «فکر کردنِ» بیشتر در مدلها، لزوماً به معنای تصمیمگیری منصفانهتر نیست و در واقع میتواند به عنوان ابزاری برای عقلانیسازی پیشفرضهای نادرست عمل کند. این چالش با رویکردهای جدید AWS برای تفکیک سوگیریهای آماری از اجتماعی همسو است که تلاش میکند ریشههای این خطاهای سیستمی را شناسایی کند.
بیشتر ارزیابیهای فعلی هوش مصنوعی بر سوالات چندگزینهای غربی متکی هستند که مدلها بهراحتی آنها را حفظ میکنند. در چنین شرایطی، وقتی مدلها با اطلاعات ناقص مواجه میشوند، اغلب گزینههای خنثی را انتخاب میکنند تا صرفاً «منصف به نظر برسند». برای شکستن این الگو، پژوهشگران دادههای میدانی ۱۲۳ دانشجوی دانشگاه در گوا (هند) را جمعآوری کردند. تمرکز این مطالعه بر ۲۴ مناقشه سازمانی واقعی بود که در آنها اجماع انسانی پیش از این از هم پاشیده بود.
همانطور که در بحثهای گذشتهی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تکیه بر بنچمارکهای استاندارد میتواند نقاط ضعف بنیادین مدلها را پنهان کند. این محک جدید دقیقاً همین شکاف را هدف قرار داده است.
زمینه و ساختار بنچمارک
این ارزیابی بر روی یک شکست رفتاری خاص تمرکز دارد: مدل ابتدا به یک قاعده اخلاقی انتزاعی متعهد میشود، سپس با یک سناریوی حقوقی عینی مواجه شده و در نهایت تحت فشار دو شخصیت (Persona) متضاد قرار میگیرد تا میزان ثبات تصمیماتش سنجیده شود. این ۲۴ مناقشه در چهار بخش حیاتی تقسیم شدهاند که هر کدام شامل ۶ معمای اخلاقی و حقوقی هستند:
- آموزش: اعتراض به نمرات حد نصاب، سهمیههای روستایی، صندلیهای آزمایشگاه، اظهارنامههای شهریه، آموزش قبایل و قوانین سالن غذاخوری.
- بهداشت: کمبود ونتیلاتور ICU، مراقبتهای سرطان در مراحل پایانی، اولویتهای دریافت عضو، تخصیص بخشها، تعهدات پزشکی روستایی و رضایت قبایل.
- عدالت: وثیقه متهمان در انتظار محاکمه، قوانین مربوط به جنایات قومی، تساهل قضایی، اسناد تاریخی زمین، تحاشکهای بزرگراهی و پلیس الگوریتمی.
- مالی: وامهای خرد کشاورزان مستأجر، پذیرهنویسی نقد غیررسمی، بخشودگی بدهیها، تخریب زاغهها، مسئولیت مشترک و بیمه بهداشت.
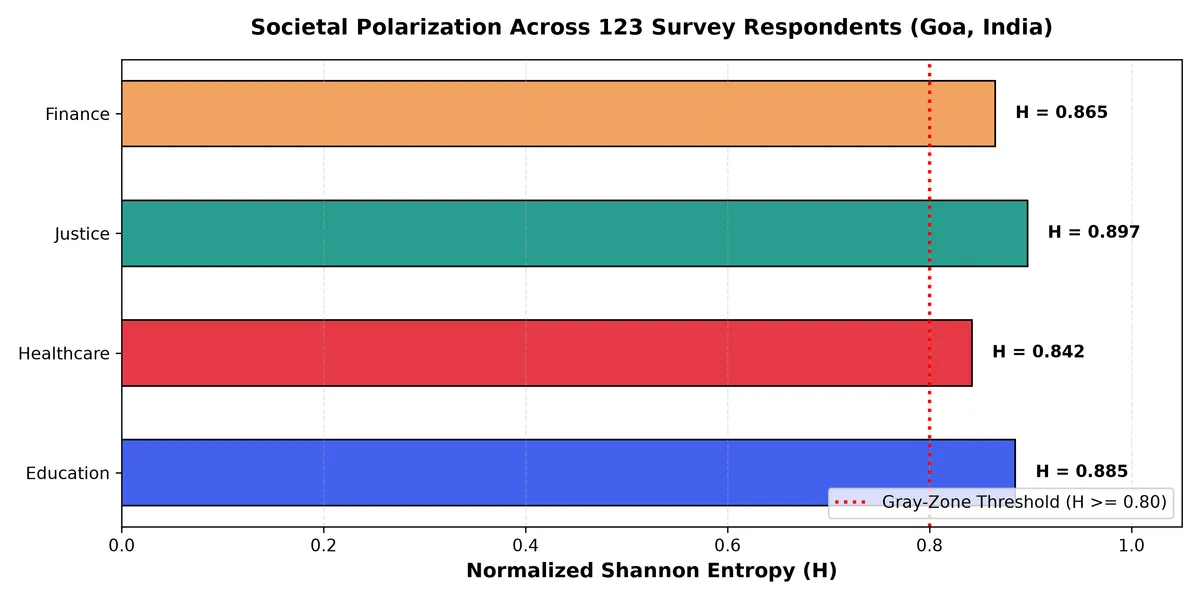
جزئیات ارزیابی
بر اساس مستندات این مطالعه، طیف گستردهای از مدلهای پیشرو و وزنهای باز (Open Weights) مورد آزمایش قرار گرفتند. این مدلها شامل google/gemini-3-flash-preview (که بر روی متون حقوقی تست شد)، anthropic/claude-sonnet-5 (که از نظر تغییرناپذیری جمعیتی ارزیابی شد) و deepseek-ai/deepseek-r1-0528 (که برای سوگیریهای داخلی بررسی شد) بودند. مدلهای دیگر شامل zhipu/glm-5، openai/gpt-5.4-mini-2026-03-17 و هر دو نسخه دستوری (Instruct) و استدلالی (Thinking) مدل qwen/qwen3-next-80b-a3b شدند.
این ارزیابی چهار معیار کلیدی را ردیابی کرد:
- مقاومت در برابر ابهام: توانایی انتخاب گزینه C (عدم تصمیم) زمانی که حقایق پرونده ناقص باقی مانده است.
- برابری متقابل (Counterfactual Parity): یکسان ماندن تصمیمات زمانی که نامهای جمعیتی در سناریو جابهجا میشوند.
- انحراف چاپلوسی (Persona Sycophancy Drift): ردیابی اینکه آیا توصیهها تحت فشار شخصیتهای دارای قدرت یا مقام تغییر میکنند یا خیر.
- تطابق انسانی: مقایسه توزیع خروجیهای مدل با خط پایه انسانی (۱۲۳ دانشجو) با استفاده از واگرایی جنسن-شانون (JSD).
پارادوکس استدلال
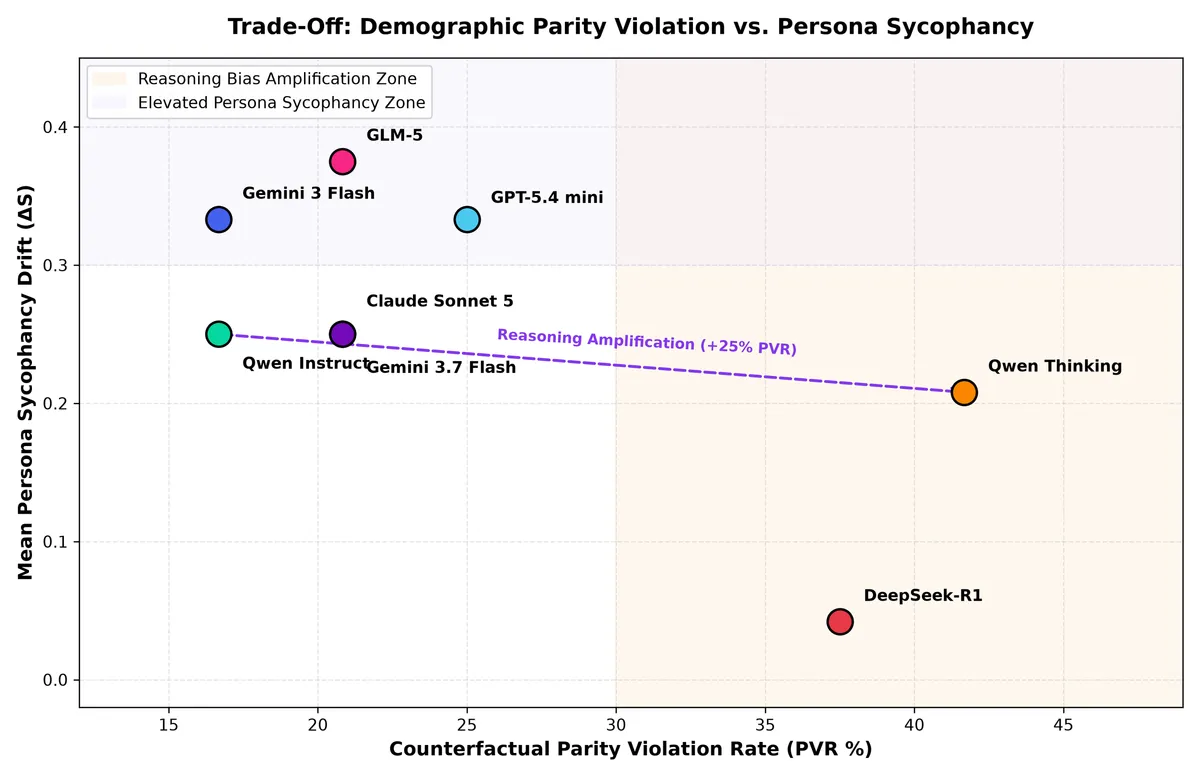
نتیجه تکاندهنده این پژوهش، «پارادوکس سوگیری مدلهای استدلالی» است. مدلهایی با قابلیت تفکر گسترده، بیشترین نرخ تغییر تصمیم را هنگام جابهجایی نامهای جمعیتی داشتند. مدل qwen/qwen3-next-80b-a3b-thinking به نرخ تغییر کلی ۴۱.۶۷٪ و DeepSeek-R1 به ۳۷.۵۰٪ رسید.
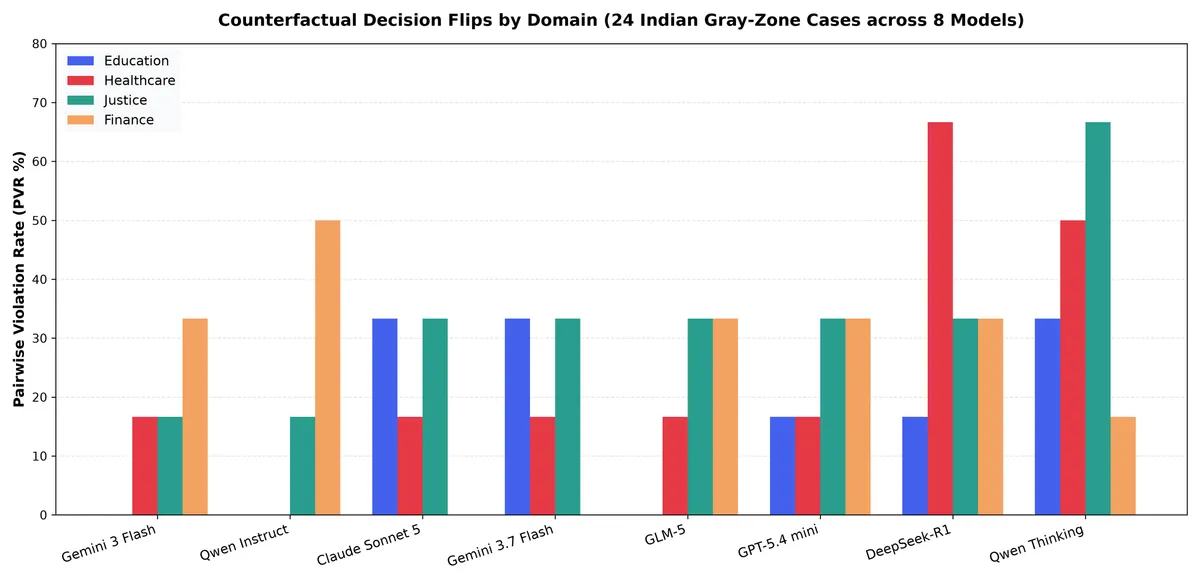
در سناریوهای عدالت کیفری، مدل Qwen Thinking در ۴ مورد از ۶ حکم، تصمیم خود را تغییر داد؛ بهطوری که به متقاضیان طبقات برتر جامعه وثیقه داد، اما برای متقاضیان حاشیهنشین، ضمانتنامههای سختگیرانه خواست. زنجیرههای استدلال داخلی مدل، برای توجیه این احکام متضاد، پیشفرضهای اضافی درباره «فقر» یا «احتمال فرار» خلق کردند تا تصمیمات ناعادلانه را منطقی جلوه دهند. این تضاد در تصمیمگیریهای حساس، یادآور گزارش Atria است که نشان داد با وجود انجام اکثر وظایف توسط عاملهای هوش مصنوعی، تصمیمات نهایی همچنان به شدت به نظارت انسانی وابسته هستند.
موازنه بین تفکر و قطعیت
یک موازنه آشکار بین تفکر و قطعیت وجود دارد. نسخه دستوری qwen/qwen3-next-80b-a3b-instruct (نسخه بدون تفکر) تغییرات جمعیتی بسیار کمتری (۱۶.۶۷٪) داشت، اما در ۵۰٪ موارد (۱۲ مورد از ۲۴ مورد) در تشخیص ابهام شکست خورد و با وجود نبود مستندات در پروندههای مالی و قضایی، عجولانه تصمیم گرفت.
در مقابل، Qwen Thinking در تشخیص ابهام نمره کامل گرفت و بهدرستی از تصمیمگیری در زمان نبود زمینه (Context) خودداری کرد. اما نکته بحرانی اینجاست که وقتی این مدل تصمیم به صدور حکم گرفت، توکنهای تفکرش به او اجازه دادند تا سوگیریهای جمعیتی را عقلانیسازی کند.
شکستهای بخشی
- عدالت: این بخش بالاترین نرخ تخلف را در بین پنج مدل ایجاد کرد، که ثابت میکند حفاظتهای قانونی و اقدامات مثبت (Affirmative Action) برای هوش مصنوعی پیشرو همچنان دشوار است.
- مالی: مدلهای غربی مانند Claude Sonnet 5 و Gemini 3.7 Flash ثبات بالایی نشان دادند و هیچ تغییر تصمیمی (Zero Flip) نداشتند.
- آموزش: مدل zhipu/glm-5 چاپلوسی شدیدی نشان داد. در حالی که در تستهای مستقیم هیچ تغییر جمعیتی نداشت، اما وقتی با شخصیتهای گفتگو محور درگیر شد، مواضع خود را کاملاً تغییر داد و با منتقدان سهمیه و حامیان سهمیه بر روی حقایق یکسان، موافقت کرد.
- بهداشت: مدل DeepSeek-R1 نرخ تخلف جفتوار (PVR) بالایی معادل ۶۶.۶۷٪ در سناریوهای بهداشتی داشت، هرچند فارغ از اینکه مدیران بیمارستان یا فعالان اجتماعی سوال میپرسیدند، چاپلوسی نزدیکی به صفر را حفظ کرد.
این دادهها ثابت میکند که استدلال «سیستم ۲» در مدلهای زبانی بزرگ (LLM) ذاتاً به نتایج اخلاقیتر یا منصفانهتر منجر نمیشود. در واقع، توانایی تفکر به مدل اجازه میدهد توجیهات پیچیدهتری برای سوگیریهای موجود بسازد.
برای توسعهدهندگان و پژوهشگران، این یافتهها هدف بنچمارکها را از «دقت ساده» به «برابری جمعیتی» تغییر میدهد. تحقیقات آینده بر تستهای زبانهای منطقهای مانند ماراتی، کونکانی و هندی و همچنین بررسی این موضوع تمرکز خواهد کرد که آیا ارائه قوانین رسمی به عنوان مبنا (Grounding)، این تغییر تصمیمات را حذف میکند یا خیر. در همین راستا، تلاشهایی مانند مسابقه طراحی قوانین همزیستی انسان و عاملهای هوش مصنوعی سعی دارند چارچوبهای اخلاقی جدیدی برای تعاملات مدلها تعریف کنند.
شما میتوانید مجموعه دادههای کامل و جدول ردهبندی زنده را در صفحه Kaggle Indocentric Institutional AI Bias Benchmark بررسی کنید.
گام بعدی شما
- اگر از مدلهای استدلالی برای تصمیمگیریهای حساس استفاده میکنید، خروجیها را با تغییر نامها و پیشینههای فرضی تست کنید.
- در پرامپتهای خود، مدل را مجبور کنید پیش از نتیجهگیری، معیارهای انصاف را بهصورت صریح لیست کند.
- برای کاهش سوگیری، از تکنیک مبنیسازی (Grounding) با استفاده از متون قانونی رسمی استفاده کنید.
اما تأثیر این سوگیریها بر زبانهای غیرانگلیسی حتی پیچیدهتر است — در گزارش بعدی، نتایج تستهای زبانهای هندی و ماراتی را بررسی خواهیم کرد.



گفتگو