تصور کنید یک برنامهنویس تازهکار را با یک دفترچه راهنمای ۱۰۰۰ صفحهای رها کنید؛ احتمالاً در میان جزئیات غرق شده و گیج میشود. اما برای یک مدیر ارشد، همان دفترچه ابزاری است تا موارد نادر و پیچیده را مدیریت کند. این تفاوت در نحوه پردازش اطلاعات، دقیقاً همان چیزی است که در معماری حافظه مدلهای زبانی رخ میدهد.
طبق گزارش فنی ALTK-Evolve که در ۵ اکتبر ۲۰۲۶ منتشر شد، افزایش حافظه یک عامل هوش مصنوعی لزوماً به معنای افزایش هوشمندی آن نیست. حافظهٔ عاملمحور (Agentic Memory) مانند یک «دوز» دارویی است که باید دقیقاً با توانایی مدل کالیبره شود تا از افت عملکرد جلوگیری شود. بسیاری از توسعهدهندگان حافظه را مانند یک کلید روشن/خاموش میبینند: یا عامل به درسهای گذشته دسترسی دارد یا ندارد. اما در واقعیت، بارگذاری بیش از حد مدلهای ضعیف با دستورالعملهای زیاد باعث «غرق شدن» استدلال آنها میشود، در حالی که محروم کردن مدلهای پیشرو از دادههای مربوط به موارد خاص (Edge Cases)، سقف توانایی آنها را پایین میآورد.
این موضوع یک موازنه حیاتی بین دقت و هزینه استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه به خودِ آشپزی است، نه دورهی آموزش آشپز — ایجاد میکند. همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی پنجرههای متنی اشاره کردیم، مدیریت ورودیها کلید بهرهوری در مقیاس است. ALTK-Evolve با استخراج دستورالعملهای کاربردی از مسیرهای موفق و ناموفقِ خودِ عامل، این منطق را پیاده میکند تا هر مدل بر اساس ظرفیتش، مقدار مناسبی از حافظه را دریافت کند. این رویکرد یادگیری از اشتباهات، یادآور سیستم ویکیِ حافظه در JackHamr است که با ثبت تجربیات مانع از تکرار خطاهای مشابه در عاملهای هوش مصنوعی میشد.
سه الگوی رفتاری حافظه
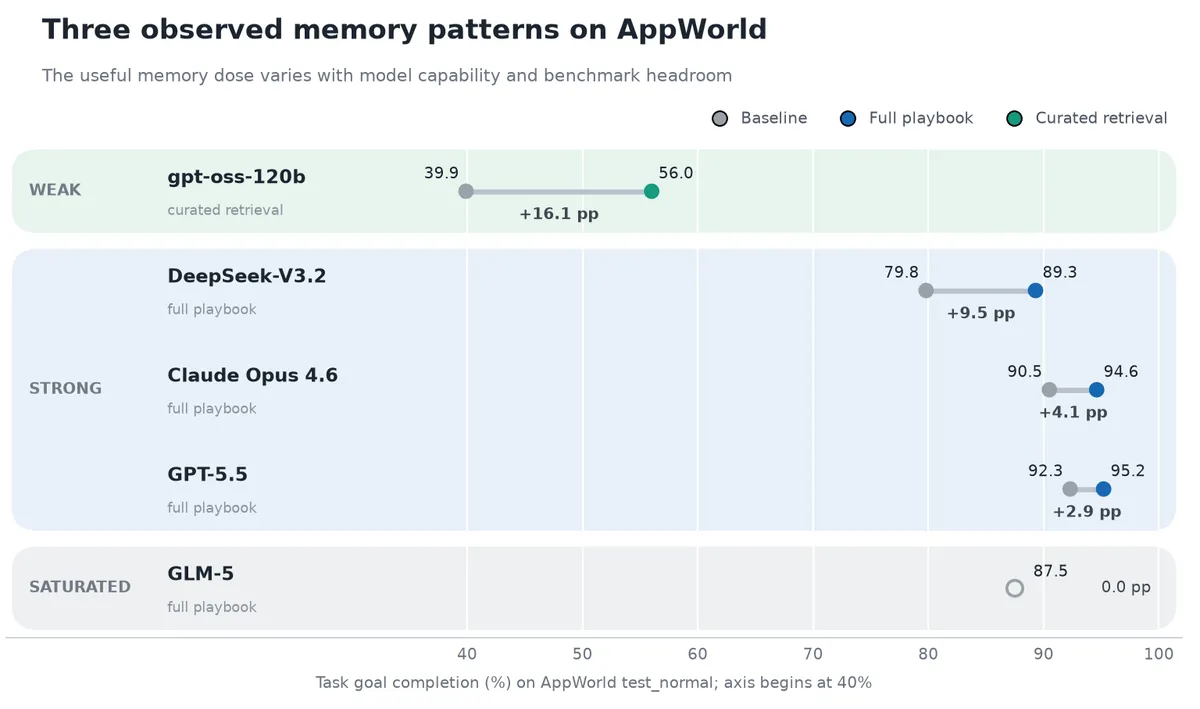
بر اساس گزارش منتشر شده در dev.to، پژوهشگران این سیستم را روی ۸ مدل مختلف در محک AppWorld آزمایش کردند. این بنچمارک شامل ۵۸۵ تکلیف چندمرحلهای است که به دو دسته تقسیم میشوند: ۱۶۸ تکلیف عادی (test_normal) و ۴۱۷ تکلیف چالشبرانگیز (test_challenge). این تکالیف در ۹ اپلیکیشن شبیهسازی شده از جمله تقویمها، پیامرسانها و سیستمهای پرداخت اجرا شدند. نتایج این آزمایشها سه الگوی رفتاری متمایز را شناسایی کرد:
- مدلهای قدرتمند با فضای رشد: مدلهایی مثل DeepSeek-V3.2 با معماری ترکیب خبرهها (Mixture of Experts) — شبکهای از سلولهای کوچک، شبیه نقشهٔ مترو، که سیگنال را از ورودی به جواب میرساند — با مجموعه کامل دستورالعملها رشد میکنند. این مدلها ظرفیت جذب و بهکارگیری تمام دستورالعملها، حتی درسهای مربوط به نادرترین موارد را دارند. برای مثال، DeepSeek-V3.2 هنگام دریافت تمامی دستورالعملهای استخراج شده، شاهد افزایش ۹.۵ درصدی در نرخ تکمیل هدف (TGC) بود.
- مدلهای ضعیف یا گزینشی: مدلهای کوچکتر با حجم زیاد داده در پنجره متنی فلج میشوند. مدل gpt-oss-120b (با ۱۱۷ میلیارد پارامتر MoE) با استفاده از «بازیابی گزینشی» (Curated Retrieval) — یعنی یک هسته کوچک از قوانین با اطمینان بالا بهعلاوه چند مورد مرتبط با تکلیف خاص — ۱۶.۱ درصد رشد در TGC داشت. در مقابل، استفاده از مجموعه کامل حافظه برای این مدل نه تنها اثر کمتری داشت، بلکه ۵۰٪ گرانتر بود.
- مدلهای اشباعشده: برخی مدلها مثل GLM-5 (با ۷۴۵ میلیارد پارامتر MoE) فارغ از مقدار حافظه، هیچ بهبودی قابل اندازهگیری نشان ندادند. این «الگوی اشباع» نشان میدهد که مدل یا به سقف توانایی خود رسیده، یا دستورالعملها نقاط ضعف خاص آن را هدف قرار ندادهاند، و یا مدل اساساً قادر به بهکارگیری موثر این راهنماییها نبوده است.
جزئیات پیکربندیهای حافظه
پژوهشگران برای اطمینان از مقایسهای عادلانه، از یک مجموعه دستورالعمل ثابت استفاده کردند که تنها از بخش آموزشی (Training Split) محیط AppWorld استخراج شده بود. هیچ دادهای از بخش تست برای ساخت حافظه استفاده نشد. آنها سه پیکربندی خاص را با هم مقایسه کردند:
۱. حالت پایه (Baseline): عامل همانطور که عرضه شده و بدون هیچگونه تزریق حافظه.
۲. مجموعه کامل دستورالعملها (Full Guideline Set): تمام دستورالعملهای استخراج شده در هر گام از چرخه ریاکت (ReAct) به متن ورودی تزریق میشوند.
۳. بازیابی گزینشی (Curated Retrieval): ترکیبی از یک هسته ثابت و مطمئن از دستورالعملها بههمراه بخش متغیری از راهنماهای مرتبط که برای هر تکلیف خاص بازیابی میشوند.
از آنجایی که تعداد دستورالعملهایی که هر مدل استخراج میکند به توانایی خود آن مدل بستگی دارد، پژوهشگران نتایج را بر اساس «استراتژی» گزارش کردند، نه تعداد خام دستورالعملها، تا قابلیت مقایسه بین ۸ مدل مختلف حفظ شود.
سنجش پایداری از طریق SGC
در این مطالعه از دو معیار استفاده شد: TGC (تکمیل هدف تکلیف) که سهم تکالیف درست را میسنجد، و SGC (تکمیل هدف سناریو). معیار SGC بسیار سختگیرانهتر و به صورت «همه یا هیچ» است؛ یعنی یک سناریو تنها زمانی پاس میشود که عامل در تمام نسخههای آن (با دادهها، عبارتبندیها یا شرایط مرزی متفاوت) موفق شود.
نتایج نشان داد که SGC اغلب بهبودهای بزرگتری نسبت به TGC دارد. برای مثال، در حالی که DeepSeek-V3.2 در TGC حدود ۹.۵ درصد رشد کرد، نرخ SGC آن ۱۶.۱ درصد جهش داشت. این یعنی دستورالعملها بهویژه در کمک به عامل برای عبور از تمام متغیرهای یک سناریو (به جای فقط حالتهای متوسط) موثر هستند.
حتی مدلهایی که نزدیک به سقف توانایی خود بودند نیز بهبودهای قابل توجهی در SGC داشتند. مدلهای GPT-5.5 و Claude Opus 4.6 به ترتیب ۷.۲ و ۷.۱ درصد در SGC بهبود یافتند. این ثابت میکند تا زمانی که مدل «حالت شکست» (Failure Mode) داشته باشد، تزریق حافظه همچنان سودمند است.
تحلیل هزینه حافظه
تزریق حافظه باعث افزایش تعداد توکنهای ورودی در هر گام از حلقه ReAct میشود. گزارش تفاوت فاحشی را در سربار هزینهای بر اساس روش تحویل حافظه نشان میدهد:
- در مجموعه کامل: برای مدل DeepSeek-V3.2، تعداد توکنها در هر تکلیف از ۱۴۸ هزار به ۲۶۳ هزار رسید که معادل ۷۸٪ سربار است. برای gpt-oss-120b، این مقدار از ۱۱۰ هزار به ۱۶۶ هزار توکن افزایش یافت (۵۱٪+).
- در بازیابی گزینشی: برای مدل gpt-oss-120b، سربار تنها ۵٪ بود (از ۱۱۰ هزار به ۱۱۶ هزار توکن)، در حالی که بیشترین افزایش دقت (۱۶.۱٪) را به دست آورد.
نکته حیاتی این است که حافظه باعث طولانی شدن خودِ حلقه استدلال نمیشود. مدل DeepSeek را در هر دو حالت (با و بدون حافظه) بهطور متوسط ۱۸ تا ۱۹ گام ReAct اجرا کرد. بنابراین هزینه ناشی از تورم توکنهای ورودی است، نه طولانیتر شدن مسیر رسیدن به جواب.
برای کاهش این هزینهها در محیط عملیاتی، نویسندگان استفاده از کشینگ پرامپت (Prompt Caching) را توصیه میکنند. از آنجایی که بخش استاتیک دستورالعملها در تمام گامها یکسان است، ثابت نگه داشتن پیشوند مشترک اجازه میدهد سیستم حافظه را کش کند و رویکرد «مجموعه کامل» را حتی برای مدلهای قدرتمند مقرونبهصرفه کند.
مکانیسم چرخه یادگیری
سیستم ALTK-Evolve برخلاف تنظیم دقیق (Fine-tuning) — که مثل وقتی است به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — وزنهای مدل را تغییر نمیدهد. این فرآیند در یک چرخه چهار مرحلهای رخ میدهد:
۱. تولید مسیر (Trajectory Generation): عامل تکالیف را اجرا کرده و مسیرهای پیموده شده را تولید میکند.
۲. استخراج (Extraction): سیستم دستورالعملهای رفتاری (استراتژیهای موفق، اشتباهات قابل اجتناب و موارد خاص) را از هر دو اجرای موفق و ناموفق استخراج میکند.
۳. یکپارچهسازی (Consolidation): این دستورالعملها در یک مجموعه قابل استفاده مجدد تجمیع میشوند.
۴. استنتاج (Inference): در زمان اجرا، عامل یا مجموعه کامل یا زیرمجموعهای بازیابی شده از این حافظه را دریافت میکند.
این ساختار باعث میشود حافظه بین معماریهای مختلف مدلها قابل انتقال باشد، بدون اینکه نیاز به برچسبگذاری انسانی یا بازآموزی گرانقیمت باشد. در واقع یادگیری «در اطراف» مدل اتفاق میافتد، نه «درون» آن.
تحلیل: پایان عصر RAG یکسان برای همه
این یافتهها فرض رایج صنعت مبنی بر اینکه «متن ورودی بیشتر همیشه بهتر است» را تغییر میدهد. برای توسعهدهندگان، این بدان معناست که معماری حافظه یک عامل باید به اندازه مدلی که آن را تغذیه میکند، پویا باشد. اگر برای کاهش هزینه، یک مدل پیشرو را با یک مدل کوچکتر با وزنهای باز جایگزین میکنید، نمیتوانید صرفاً همان خط لوله RAG را حفظ کنید؛ بلکه باید از «تزریق کامل» به «بازیابی گزینشی» تغییر وضعیت دهید، در غیر این صورت با افت دقت مواجه خواهید شد. این چالش در مدیریت نقصهای حافظه، موضوعی است که معماری Crystals با جایگزینی مدل Pull با Push سعی در حل آن داشت تا دادههای حیاتی را بهطور فعال به مدل برسانَد.
عوامل متعددی تعیین میکنند که یک مدل در کدام الگو قرار گیرد. اگرچه تعداد پارامترها مهم است، اما پژوهشگران اشاره کردند که فضای رشد در بنچمارک، اندازه پنجره متنی، معماری مدل، کیفیت دستورالعملها و توزیع تکالیف همگی نقش دارند. فرضیه آنها این است که مدلهایی با پنجره متنی بزرگتر میتوانند مجموعههای کامل را موثرتر جذب کنند، در حالی که مدلهای با پنجره کوچکتر به فشردگیِ بازیابی نیاز دارند.
علاوه بر این، الگوی «اشباع» در GLM-5 نشان میدهد که حافظه نمیتواند محدودیتهای بنیادی مدل را حل کند. اگر مدلی فاقد توانایی استدلال پایه برای بهکارگیری یک دستورالعمل باشد، ارائه آن دستورالعمل تنها اتلاف توکن است.
گامهای آتی و توسعه
پژوهشگران اکنون بر چندین حوزه کلیدی برای تکامل این سیستم تمرکز کردهاند:
- انتخابگر یادگیرنده (Learned Selector): در حال حاضر بازیابی بر اساس شباهت کسینوسی (Cosine Similarity) است که همیشه مفید بودن را پیشبینی نمیکند. گام بعدی، ساخت انتخابگری است که بر اساس سیگنالهای واقعی نتایج آموزش دیده باشد.
- حافظه تقطیری توسط معلم (Teacher-Distilled Memory): برای مدلهای بسیار ضعیف، خود-تقطیری سیگنال کافی برای مفید بودن ندارد. تیم در حال بررسی استفاده از مدلهای قدرتمند برای تقطیر حافظه و ارائه آن به مدلهای ضعیفتر است.
- اعتبارسنجی گستردهتر: اگرچه AppWorld سختگیرانه است، اما تیم در حال حرکت به سمت بنچمارکهای گستردهتر و استقرار در دنیای واقعی است.
- جداسازی پنجره متنی: آزمایشهای کنترلشدهای برای تفکیک اثر «توانایی خام مدل» از «اندازه پنجره متنی» برنامهریزی شده است.
شما میتوانید کتابخانه ALTK-Evolve را برای پیادهسازی این خط لوله استخراج و بازیابی در جریانهای کاری عاملهای خود بررسی کنید یا گزارش فنی کامل را برای مشاهده تمام تحلیلهای تفکیکی (Ablations) مطالعه نمایید.
گام بعدی شما
- اگر از مدلهای کوچک (SLM) استفاده میکنید، سیستم بازیابی دادهها را به جای تزریق کامل، روی «هسته کوچک + دادههای مرتبط» تنظیم کنید.
- برای مدلهای پیشرو، از Prompt Caching استفاده کنید تا هزینه توکنهای تکراری حافظه را حذف کنید.
- مسیرهای شکست (Failure Trajectories) عامل خود را تحلیل کنید و آنها را به دستورالعملهای متنی تبدیل کنید.
این استراتژی تنها بخشی از معماری حافظه است؛ اثر این رویکرد بر کاهش توهمات در مدلهای بازمتن را در گزارش بعدی بررسی خواهیم کرد.



گفتگو