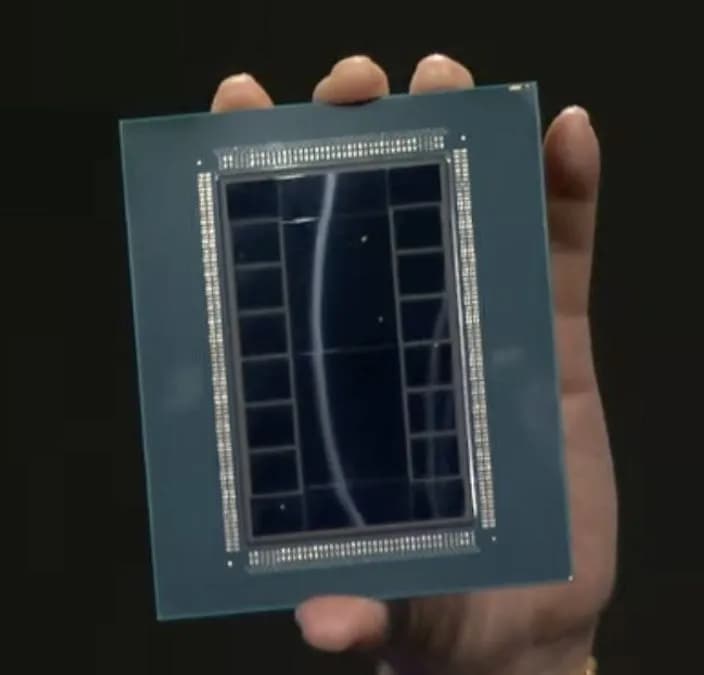
اگر توسعهدهندهٔ مدلهای زبانی بزرگ هستید، گلوگاه اصلی شما دیگر نه فقط پهنای باند حافظه، بلکه فشار روی رجیسترها است. AMD با معرفی معماری جدید خود، دقیقاً همین نقطهٔ ضعف را هدف قرار داده تا بازی را در بازار شتابدهندهها تغییر دهد.
طبق تحلیل فنی وبسایت chipsandcheese.com در ۱۹ ژوئیه ۲۰۲۶، کدهای منتشر شده در LLVM نشان میدهند که مدل MI455X (با نام رمز GFX1250) اکنون میتواند ۱۰۲۴ رجیستر عمومی برداری (Vector General Purpose Registers یا VGPRs) را به ازای هر Wave تخصیص دهد. این تغییر ساختاری، تلاشی است تا خط تولید Instinct را از نظر کارایی برنامهنویسی به معماری Blackwell انویدیا نزدیک کند.
این تحولات در حالی رخ میدهد که AMD برای رویداد «Advancing AI» آماده میشود تا سری MI400 را بهطور رسمی معرفی کند. صنعت در حال حاضر درگیر نبردی بر سر پهنای باند حافظه و فشار رجیستری است؛ هر کس بتواند دادههای بیشتری را در نزدیکترین فاصله ممکن به واحد اجرای هسته نگه دارد و از توقف (Stall) پردازنده جلوگیری کند، پیروز این جنگ عملکرد خواهد بود. این رقابت سختافزاری تنها میان غولهای سنتی نیست و حتی شرکتهای نرمافزاری نیز برای کاهش وابستگی به تامینکنندگان فعلی، مسیر توسعه تراشههای اختصاصی خود را در پیش گرفتهاند. برای توسعهدهندگان، این بدان معناست که شکاف بین فریمورکهای سطح بالای AI و بهرهوری سختافزاری سطح پایین در حال کاهش است.
نامهای رمز و دستهبندی سختافزاری
در حال حاضر LLVM پشتیبانی اولیه از دو شتابدهنده متمایز را در این نسل جدید دنبال میکند. مدل GFX1250 که با نام تجاری MI455X شناخته میشود، بهطور خاص برای بازار یادگیری ماشین طراحی شده و قلب تپنده رکسهای Helios خواهد بود.
به موازات آن، مدل GFX1251 با نام رمز MI430X برای بازار رایانش با عملکرد بالا (HPC) هدفگذاری شده است. AMD پیشبینی میکند که MI430X بیش از ۲۰۰ ترافلاپس (TFLOPs) توان محاسباتی بومی با دقت مضاعف (Double-precision) ارائه دهد. در حالی که تمرکز فعلی روی GFX1250 است، اما هر دو تراشه نشاندهنده یک جهش در استراتژی مرکز داده AMD هستند.
نکته جالب این است که هر دو مدل در کدهای کامپایلر به عنوان APU لیست شدهاند، هرچند در واقعیت شتابدهنده هستند و نه پردازنده گرافیکی یکپارچه؛ این احتمالاً به نحوه مدیریت مدل حافظه و اجرای مدل در معماری جدید توسط کامپایلر بازمیگردد.
بازنگری در حافظه و رجیسترها
بزرگترین ارتقای GFX1250، گسترش فایل رجیستر است. هر Wave در یک SIMD اکنون میتواند تا ۱۰۲۴ رجیستر VGPR را آدرسدهی کند. برای درک ابعاد این تغییر، مقایسه زیر را بررسی کنید:
- نسلهای قبلی CDNA: از تخصیص شکافته ۲۵۶ VGPR و ۲۵۶ رجیستر Accumulation استفاده میکردند (که فقط توسط واحدهای ماتریسی استفاده میشدند) و در مجموع ۵۱۲ رجیستر به یک Wave تخصیص مییافت.
- پردازندههای گرافیکی RDNA: محدود به ۲۵۶ رجیستر در هر Wave بدون هیچگونه تفکیک در تخصیص بودند.
این ظرفیت ۱۰۲۴-VGPR برای بارهای کاری یادگیری ماشین حیاتی است. تانسورها (Tensors) فشار بسیار بیشتری نسبت به تکبردارها یا ماتریسهای ساده به رجیسترها وارد میکنند. AMD با دو برابر کردن و سپس گسترش تخصیص مؤثر، نیاز به «ریزشی» (Spilling) دادهها به حافظههای کندتر را کاهش داده است؛ پدیدهای که بهطور سنتی سرعت استنتاج (Inference) را بهشدت تخریب میکرد.
نکته عجیب این است که در حالی که RDNA4 ادعای تخصیص پویای VGPR را داشت، این ویژگی در GFX1250 دیده نمیشود. با توجه به فشار بالای رجیستری تانسورها، این موضوع غافلگیرکننده است، اما حالت تغییر-مود (mode-switch) همچنان وجود دارد؛ فقط دستورالعمل خاص برای تخصیص رجیسترهای جدید به عنوان یک عملیات بیاثر (no-op) مستند شده است.

کش یکپارچه WGP
سرانجام AMD تفکیک بین اشتراک دادههای محلی (LDS) و کشهای برداری L0 را کنار گذاشت و یک «کش WGP» یکپارچه (WGP$) معرفی کرد. این یک تغییر ساختاری در پردازنده گروه کاری (WGP) است.
WGP از دو جفت آرایه SIMD32 ساخته شده است، بهطوری که چهار SIMD در هر واحد محاسبه (CU) قرار میگیرند. به دلیل وجود کش مشترک برداری L0 برای کل WGP، نرمافزار دیگر نیازی به تفکیک دو CU ندارد و AMD اکنون از این دو اصطلاح بهصورت جایگزین استفاده میکند. این عدم تفکیک ساختاری احتمالاً یک تغییر در سطح کامپایلر است که توسط سلسلهمراتب جدید کش فعال شده است.
جزئیات کلیدی این سلسلهمراتب حافظه:
- اندازه کل ساختار: ۴۴۸ کیلوبایت، که میتواند بهصورت پویا بسته به نیاز برنامهنویس یا کامپایلر به بخشهای مختلف تقسیم شود.
- ظرفیت LDS: حداکثر حافظه محلی قابل آدرسدهی (LDS) اکنون ۳۲۰ کیلوبایت به ازای هر Wavefront است.
- مقایسه: این ظرفیت دو برابر نسل CDNA4 و بهمراتب بیشتر از ۶۴ کیلوبایت قابل آدرسدهی در RDNA است.
این حرکت بازتابدهنده انتخابهای طراحی دیرینه در انویدیا و اینتل است که اجازه مدیریت منعطفتر حافظه را در داخل پردازنده گروه کاری میدهد.
تمرکز خالص بر محاسبات
مدل GFX1250 برای بهینهسازی فضای تراشه (die space) و به حداکثر رساندن تراکم محاسباتی، «خالصترین» شتابدهنده تاریخ CDNA است. AMD تقریباً تمام آثار سختافزاری گرافیکی را حذف کرده تا تراشه را سبکتر از هر دو رقیبش (انویدیا و اینتل) کند.
قابلیتهای گرافیکی حذف شده:
- رستریزیشن (Rasterization): حذف دستورات Export و رستریزرهای سختافزاری (مطابق با استانداردهای CDNA).
- بافتگذاری (Texturing): حذف دستورات Image و Texture (مطابق با CDNA).
- رهگیری پرتو (Raytracing): حذف دستورات BVH یا سلسلهمراتب حجم محدود (مطابق با CDNA).
- سایهزنی پیکسل (Pixel Shading): حذف دستورات درونیابی پارامتر برداری که برای دسترسی به دادههای ورتکس استفاده میشدند.
- پشتیبانی از بافر: حذف دستورات MTBUF (بافر تایپشده) و MUBUF (بافر بدون تایپ) که در CDNA و RDNA3/RDNA حضور داشتند.
- بارگذاری پارامتر: حذف بارگذاریهای مستقیم پارامتر و پارامترهای LDS.
با حذف این ویژگیهایی که برای بارهای کاری AI بیفایده هستند، AMD کارایی تراشه و فضای آن را برای محاسبات تانسوری و برداری به حداکثر رسانده است.
تکامل هستههای تانسور
مدل MI455X مدل برنامهنویسی RDNA4 را با قدرت خام CDNA4 ترکیب کرده و بهجای سیستم قدیمی MFMA، از عملیات WMMA (ضرب-تجمع ماتریس موج) استفاده میکند.

مشخصات تانسوری GFX1250 عبارتند از:
- اندازه ماتریس: M = N = 16.
- مقادیر K (ابعاد):
- K = 4 برای عناصر اعشاری ۶۴-بیت و ۳۲-بیت.
- K = 32 برای عناصر اعشاری ۱۶-بیت.
- K = 64 برای عناصر اعداد صحیح ۸-بیت.
- K = 128 برای عناصر اعشاری ۸-بیت.
- عملیات i4: این موارد در سطح RDNA4 باقی ماندهاند (K=32). این فرمت به دلیل پذیرش عملیات اعشاری MX در استنتاجهای AI بزرگ، محبوبیت کمتری دارد.
- مقیاسبندی: پشتیبانی از مقیاسبندی سبک OCP MX که پیشتر تنها در CDNA4 در دسترس بود.
برخلاف نسخههای پراکنده (sparse) از WMMA در RDNA4، به نظر میرسد نسخههای sparse در GFX1250 با ثابت نگه داشتن K مشابه عملیات متراکم (dense)، کار کمتری در هر دستورالعمل انجام میدهند. تراشه تقریباً از تمام انواع دادههای موجود در CDNA4 و RDNA4 پشتیبانی میکند، بهجز fp64 که ظاهراً محدود به GFX1251 (MI430X) شده است.
حالت Wave و اجرا
GFX1250 منحصراً در حالت Wave32 عمل میکند. این یک تغییر مسیر نسبت به RDNA است که میتواند در هر دو حالت Wave32 و Wave64 اجرا شود، و همچنین نسبت به GPUهای قبلی CDNA که فقط در Wave64 کار میکردند. این تغییر احتمالاً باعث چالشهای مهندسی عملکرد در هنگام پورت کردن کرنلها میشود، زیرا بسیاری از آنها نیاز به بازنگری کامل برای معماری جدید دارند.
علاوه بر این، GFX1250 میتواند ۲۰ Wave را در هر SIMD اجرا کند که چهار واحد بیشتر از ظرفیت RDNA4 است. اگرچه تأیید نشده است که آیا این سیگنالی برای آینده GPUهای Radeon است یا خیر، اما نشاندهنده حرکتی به سمت قفل کردن نسلهای آینده روی Wave32 و بازنشست کردن تعریف فعلی WGP است.
ارتباطات در سطح خوشه
ایامدی با معرفی «خوشههای بلوک رشته» (Thread Block Clusters)، پاسخ مستقیم خود را به معماری Hopper انویدیا داده است. این قابلیت به زمانبند اجازه میدهد خوشهها را به موتورهای سایه خاص اختصاص دهد و بارگذاریهای سطح خوشه را معرفی کند.
این بدان معناست که یک Wavefront اکنون میتواند به LDS سایر گروههای کاری در یک خوشه دسترسی داشته باشد. در واقع، AMD نسخه خود از «حافظه مشترک توزیع شده» (DSMEM) یا «حافظه مشترک خوشه» انویدیا را پیاده کرده است. برای پشتیبانی از این قابلیت، GFX1250 موارد زیر را اضافه کرده است:
- موانع سطح خوشه (Cluster-level barriers): برای همگامسازی خوشهها.
- توابع داخلی ورود به مانع (Barrier Arrival Intrinsics): معادل
mbarrier.arriveدر PTX انویدیا. - ناظران کش L2: ناظران کاملی که به Wave اطلاع میدهند چه زمانی یک خط کش خاص از L2 خارج شده است؛ قابلیتی که حتی از معادلهای فعلی انویدیا پیشرفتهتر است.
- اشیای مانع نامگذاری شده: پشتیبانی از ۱۶ شیء مانع نامگذاری شده، احتمالاً برای سازگاری با استانداردهایی که به معماری Tesla سال ۲۰۰۶ انویدیا بازمیگردد.
شتابدهندههای سختافزاری تخصصی
علاوه بر تانسورها، GFX1250 پشتیبانی سختافزاری از تابع فعالساز tanh را اضافه کرده است که در شبکههای عصبی و حل معادلات دیفرانسیل بسیار رایج است. این واحد با پشتیبانی از bf16 بهبود یافته و تأخیر (latency) برای عملیات FP32 از ۹ سیکل (در RDNA4) به ۸ سیکل کاهش یافته است.
برای تسریع کتابخانه ارتباطات جمعی ROCm (معادل NCCL انویدیا)، تراشه از بارگذاری و ذخیرهسازی اتمیک ۱۲۸-بایتی پشتیبانی میکند. اینها بهصورت عملیات اتمیک ۳۲x۴بایت، ۱۶x۸بایت و ۸x۱۶بایت پیاده شدهاند. در سطح سختافزاری، اینها توالیهایی از بارگذاری/ذخیرهسازی معمولی هستند که توسط باس مدیریت میشوند. این عملیات روی PCIe در دسترس نیستند اما انتظار میرود روی CXL و UALink کار کنند، مشابه محدودیت NVLink در انویدیا.
تراشه همچنین شامل یک «شتابدهنده حافظه تانسور» است که اجازه میدهد دادهها بدون استفاده از VGPRها، مستقیماً از حافظه جهانی به LDS منتقل شوند؛ مشابه عملیات tcgen05.cp در انویدیا. در نهایت، AMD پیشخوانی (prefetching) صریح حافظه برداری را اضافه کرده است، ویژگیای که از زمان Fermi در CPUها و GPUهای انویدیا استاندارد بوده و ممکن است بهبودهای جزئی در عملکرد کرنلهای استنتاج ایجاد کند.
ردیابی دقیق وابستگیها
AMD نحوه ردیابی وابستگیهای داده توسط سختافزار را بازنگری کرده است. پیش از این، GCN و CDNA از سه شمارنده کلی (coarse) استفاده میکردند که اغلب باعث بروز مشکلاتی در بازگشت خارج از ترتیب (out-of-order return)، بهویژه در بارگذاریهای اسکالر میشد و منجر به توقفهای غیرضروری هسته میگشت.
سیستم قدیمی (GCN/CDNA):
VM_CNT: ردیابی بارگذاریهای حافظه برداری (به VGPRها)، ذخیرهها (به L2) و دستورات نمونه/تصویر.LGKM_CNT: ردیابی LDS، GDS، خواندنهای حافظه اسکالر (SMEM) و دستورات پیام.EXP_CNT: ردیابی خروجیهای VGPR (ویژگی گرافیکی).
GFX125x این سیستم را با یک مدل دانهریز بر اساس طراحی RDNA4 جایگزین کرده است:
LOADcnt: بهطور خاص برای بارگذاریهای برداری.STOREcnt: بهطور خاص برای ذخیرهسازیهای برداری.DScnt: برای دستورات LDS.KMcnt: برای بارگذاریهای اسکالر و ارسال پیام.EXPcnt: (در GFX125x حذف شده چون رستریزری وجود ندارد).BVHcnt: (در GFX125x حذف شده چون رهگیری پرتو وجود ندارد).
برای جبران شمارندههای گرافیکی حذف شده، GFX125x ردیابهای جدید مختص محاسبات را معرفی کرده است:
ASYNCcnt: شمارش دستورات بارگذاری/ذخیرهسازی LDS نامتقارن (asynchronous) معلق.TENSORcnt: شمارش دستورات بارگذاری/ذخیرهسازی تانسوری معلق.Xcnt: ردیابی عملیات حافظهای که منتظر ترجمه آدرس هستند. این مورد پیش از دستوراتی که نباید در حین Page Fault مجدداً تلاش شوند ضروری است و اتمیسیته را در بازپخش XNACK ساده میکند.
تحلیل: تأثیر عملی
این معماری نشاندهنده یک جدایی قطعی بین استراتژیهای مصرفکننده و مرکز داده AMD است. با قفل کردن GFX1250 در حالت Wave32 و حذف تهاجمی ویژگیهای گرافیکی، AMD توان پردازشی کل (throughput) را بر تطبیقپذیری ترجیح داده است.
برای متخصصان این حوزه، مهمترین تغییر، پذیرش کش یکپارچه WGP و افزایش عظیم VGPRها است. این تغییرات دقیقاً گلوگاه استنتاج LLM را هدف قرار دادهاند: توانایی نگه داشتن قطعات بزرگ از وزنها و فعالسازهای یک مدل در سریعترین لایه حافظه ممکن.
علاوه بر این، دستورالعملهای جدیدی که اجازه ترانهاده کردن (transposition) زیر-ماتریسها در LDS را میدهند، ویژگیهای موجود در RDNA4 را تکمیل میکنند. نسخههای fp4/fp6 این دستورات پرچمهای ویژگی (feature flags) مخصوص خود دارند که احتمالاً به حضور آینده آنها در GPUهای مصرفکننده اشاره دارد.
اگر این ویژگیها به وعده ۲۰۰+ ترافلاپس محاسبات با دقت مضاعف برای MI430X (GFX1251) تبدیل شوند، AMD ممکن است سرانجام شکاف «عملکرد عملی» با Blackwell انویدیا را پر کند. چشم خود را به رویداد Advancing AI و بنچمارکهای رسمی MI455X بدوزید تا ببینید آیا این تغییرات در سطح LLVM منجر به برتری ملموس در تعداد توکن-در-ثانیه برای مدلهای غولپیکر شده است یا خیر.



گفتگو