مرکز داده فضایی پیش از ۲۰۳۰ سهم محاسباتی نمیگیرد
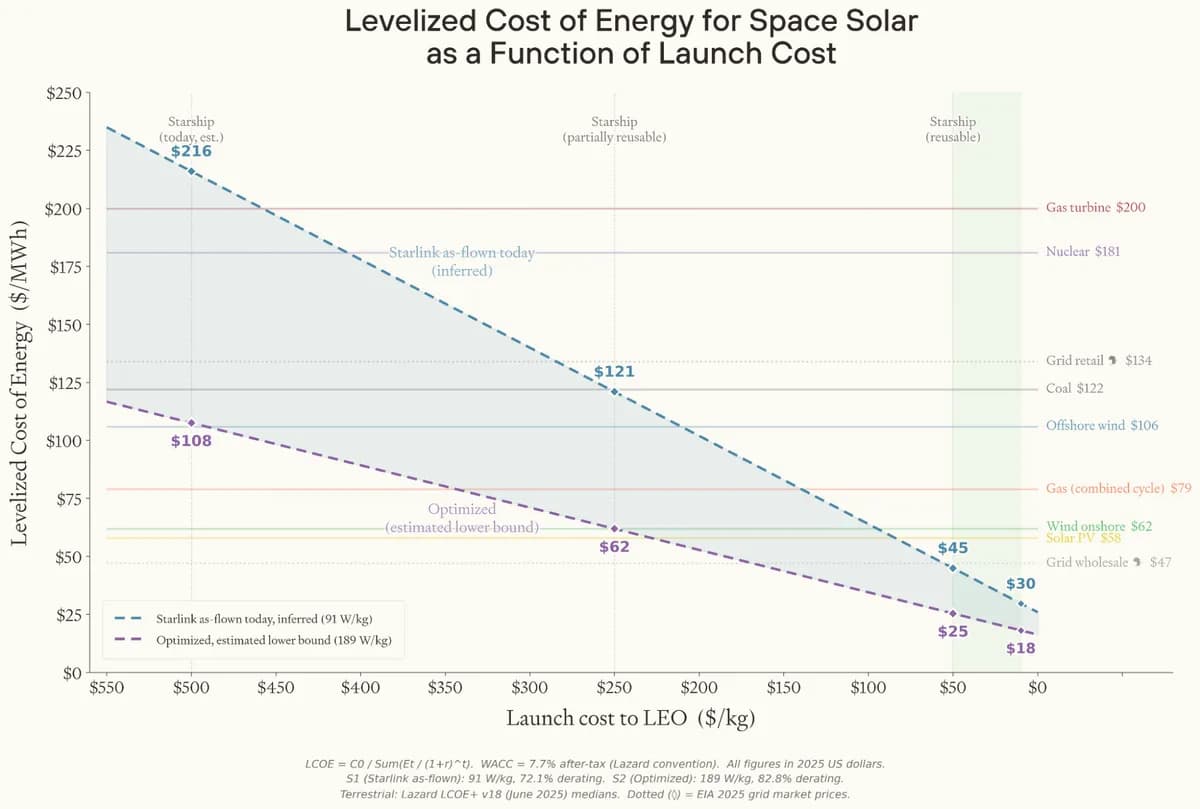
تحلیل تازهٔ فورث میگوید مرکز داده فضایی با رسیدن هزینهٔ پرتاب به حدود ۱۰۰ دلار در کیلوگرم میتواند با مرکز داده زمینی برابر شود. این برابری تقریباً کاملاً به استفادهٔ مجدد…
۴۵ دقیقه خواندن۱
موضوع
روشی برای آموزش مدلهای هوش مصنوعی با استفاده از چندین پردازنده یا سرور بهصورت همزمان
۹۰ مقاله منتشر شده
تحلیل تازهٔ فورث میگوید مرکز داده فضایی با رسیدن هزینهٔ پرتاب به حدود ۱۰۰ دلار در کیلوگرم میتواند با مرکز داده زمینی برابر شود. این برابری تقریباً کاملاً به استفادهٔ مجدد…
میرندیل سری A یک میلیارد دلاری را بقیاده کلینر پرکینز و کلیرلیک کپیتال بست تا تجربه آموزش مدل ۱۰۰ میلیارد پارامتری توسط یک محقق تنها را تجاری کند. در اکتبر ۲۰۲۶، این محقق با کمک…
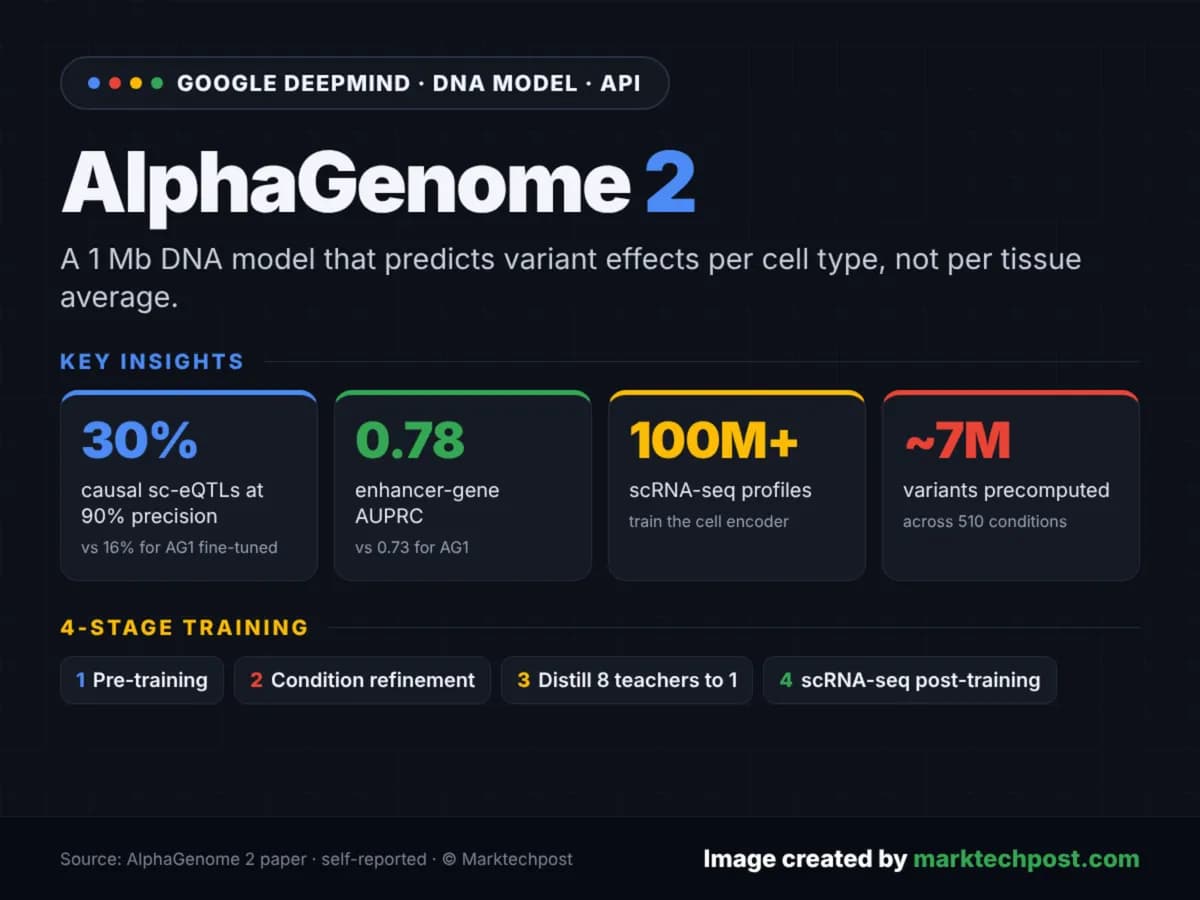
گوگل دیپمَایند AlphaGenome 2 را منتشر کرد: مدل بنیادی DNA که با آپلود ماتریس شمارش RNA-seq تکسلولی، اثر واریانت را در نوع سلولی دلخواه پیشبینی میکند. روی TenK10K یادآوری…
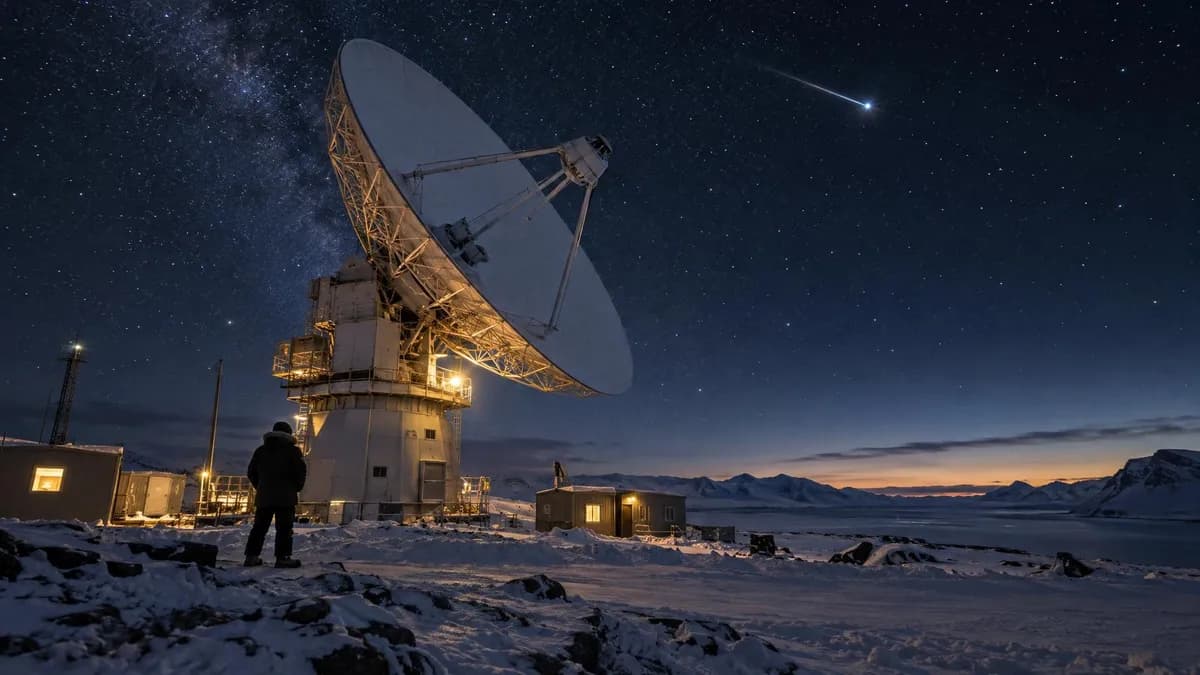
ماهواره Project Suncatcher گوگل در ۳۰ اکتبر ۲۰۲۶ نخستین پاسخ هوش مصنوعی را از یک TPU کلاس مرکز داده در مدار تولید کرد. مدل Gemma 4 در حین عبوری از ایستگاه زمینی سوالبارد یک هیکو…
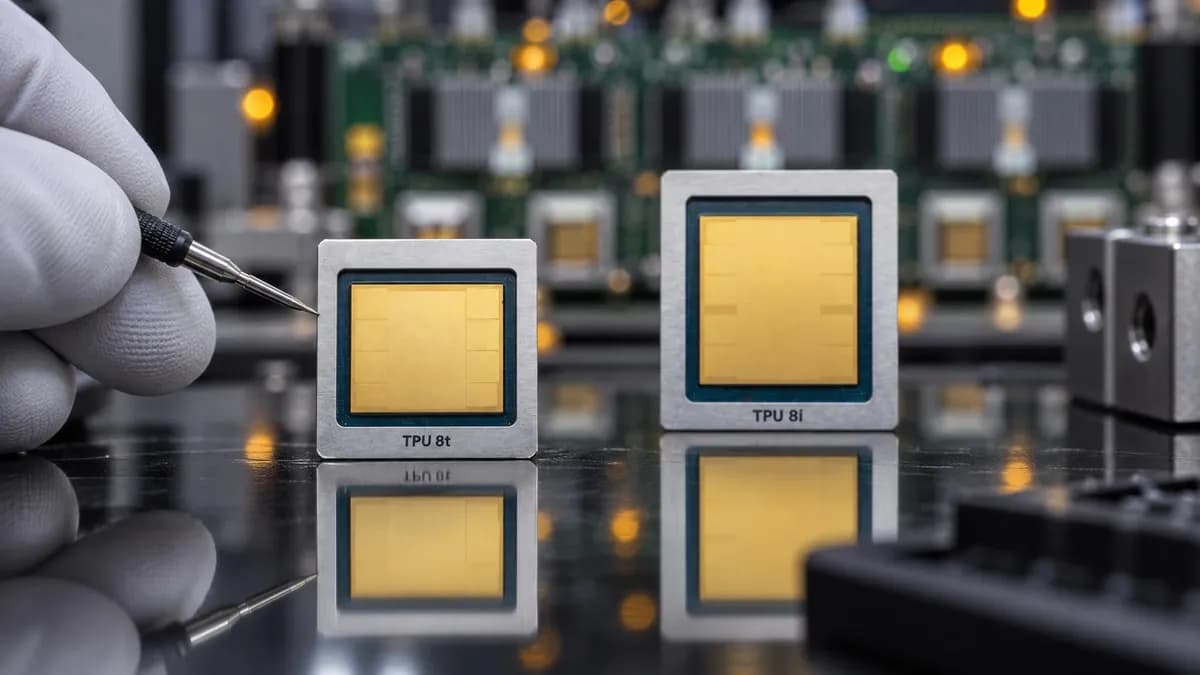
اوراکل و گوگل اعلام کردند تراشههای TPU نسل هشتم گوگل از سال ۲۰۲۷ روی زیرساخت ابری اوراکل عرضه میشوند. این نخستین بار است که TPU گوگل بیرون از گوگل کلاد در دسترس قرار…
انویدیا ۳ میلیارد دلار در عرضهٔ سهام متا سرمایهگذاری میکند و همکاری دو شرکت روی خانوادهٔ عاملهای هوش مصنوعی Muse گسترش مییابد. این توافق، شراکت زیرساختی فوریهٔ ۲۰۲۶ را به…
یک کلاستر ۲۴ هستهای آپاچی اسپارک بهدلیل تنظیم نادرستِ اجراکنندهها تنها ۱۴ هسته را به کار میگیرد و ۱۰ هسته بیکار میمانند. این مقاله با یک مثالِ فروشگاه اینترنتی، زنجیرهی کامل…
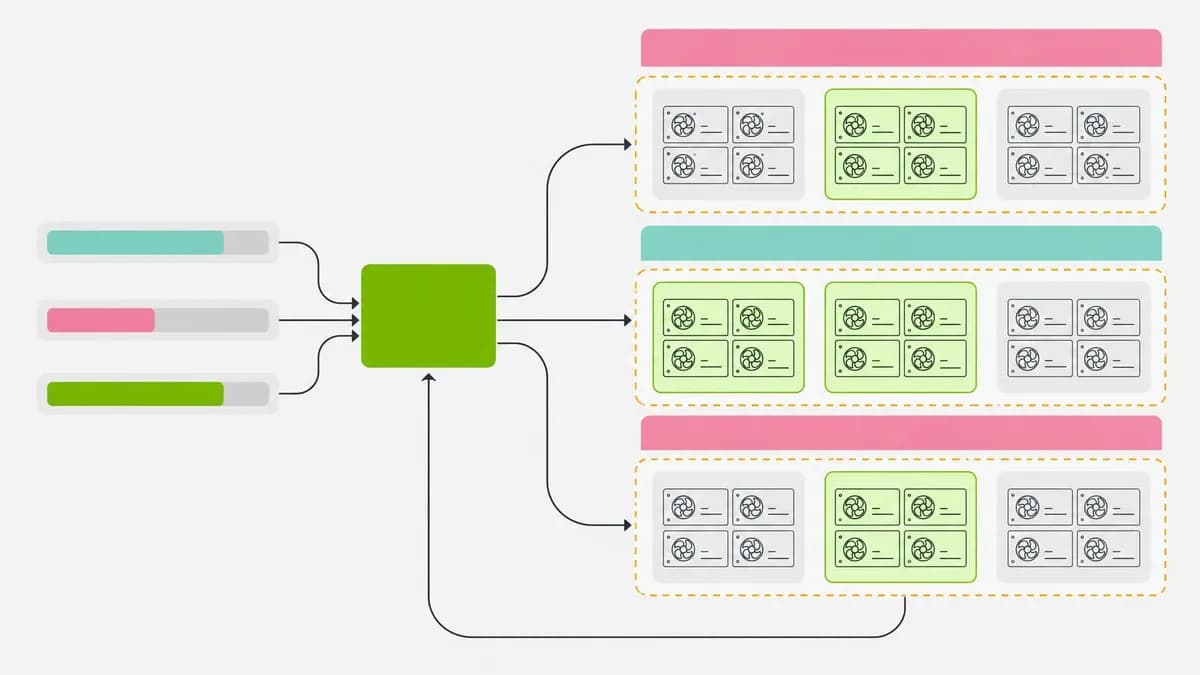
تیم Qwen علیبابا با معرفی QwenGyre، بهرهوری آموزش عاملهای هوشمند در پروژههای کدنویسی پیچیده را بهشدت افزایش داد. این سیستم با جایگزینی تقسیمبندی سختافزاری ایستا با سلولهای…
مایکروسافت با بهروزرسانی Azure AI Foundry و GitHub Copilot Studio، ابزارهایی برای کشف مدلها، بازنویسی خودکار کد و حاکمیت داده معرفی کرد. هدف این تغییرات، کاهش زمان صرفشده برای…
شرکت لامبدا با ادغام زمانبند متنباز Run:ai در سرویس LKS، بهرهوری اشتراکگذاری GPUها را افزایش داد. این اقدام باعث میشود تیمهای هوش مصنوعی از ظرفیتهای بلااستفاده بهتر استفاده…
پژوهشگران اپل با معرفی Minions، راهکاری برای تجمیع توان پردازشی GPUهای بلااستفاده در دستگاههای مک ارائه دادند. این سیستم به تیمهای توسعه اجازه میدهد بدون نیاز به خوشههای…
تیم Qwen در علیبابا با معرفی QwenGyre، تخصیص منابع GPU را بین مراحل استنتاج و آموزش به صورت پویا تغییر داد تا اتلاف محاسباتی در عاملهای بلندمدت را حذف کند. این متدولوژی باعث…