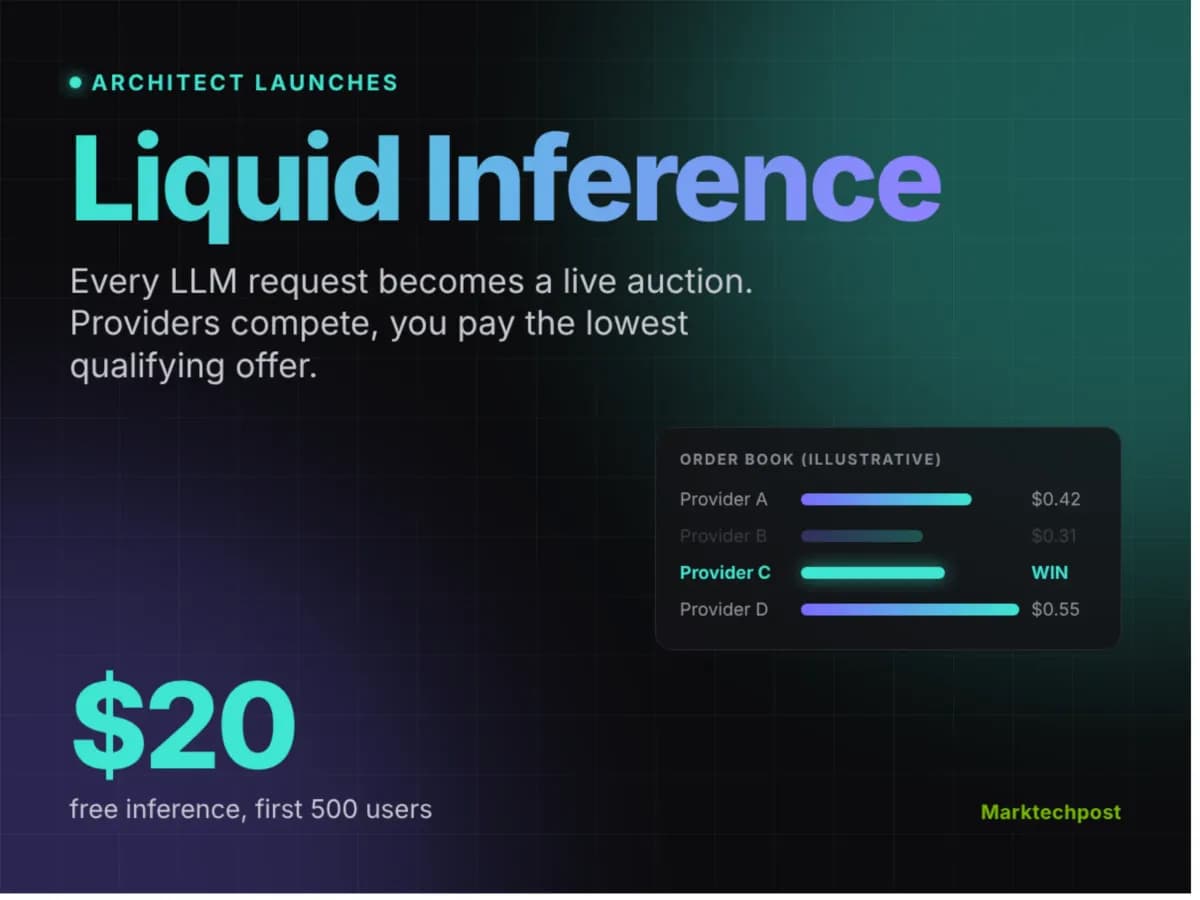
هر درخواست شما از یک مدل هوش مصنوعی اکنون برچسب قیمتی دارد که میتواند در چند میلیثانیه کاهش یابد. شرکت Architect Financial Technologies در ۸ اکتبر ۲۰۲۶ سرویس Liquid Inference را راهاندازی کرد تا استنتاج (Inference) — که مثل لحظهی خودِ آشپزی است، نه دورهی آموزش آشپز — را از مدل قیمتهای ثابت API به یک مدل حراج رقابتی و زنده تبدیل کند.
این تغییر در حالی رخ میدهد که سازمانها با هزینههای پیشبینیناپذیر در مقیاسبندی گردشهای کاری عاملمحور (Agentic) دستوپنجه نرم میکنند. همانطور که در تحلیل قبلی ما دربارهی کاربرد مدلها در بازارهای مالی اشاره کردیم، اکنون Architect منطق بورس را به لایهی محاسباتی آورده است. تصور کنید یک بورس سهام دارید، اما بهجای سهام، ارائهدهندگان برای پردازش پرامپت بعدی شما قیمت میدهند.
زمینهی بازار
شرکت Architect یک آزمایشگاه AI نیست، بلکه یک شرکت معاملاتی است که بورس AX را مدیریت میکند. طبق گزارش این شرکت، آنها در می ۲۰۲۶ یک بازار قراردادات رسمی در آمریکا (Designated Contract Market) را برای لیست کردن قراردادهای آتی واحد پردازش گرافیکی (GPU) خریداری کردند که در حال حاضر در انتظار بررسیهای نظارتی است. این تیم از تجربهی عمیق خود در ساخت بورسهای مالی استفاده کرد تا سیستمی برای کشف قیمت دوطرفه در لایهی استنتاج بسازد. این رویکرد یادآور سیستمهای پیشرفتهای است که در تشخیص حملات Spoofing از طریق بازسازی لحظهای دفتر سفارشات به کار میروند تا شفافیت بازار را افزایش دهند.
به نقل از گزارش MarkTechPost، این سامانه در چهار مرحله عمل میکند: ابتدا کاربر یک فراخوان API استاندارد میفرستد، سپس محدودیتهای خریدار پیشنهادها را فیلتر میکند، ارائهدهندگان در یک حراج زنده رقابت میکنند و در نهایت ارزانترین پیشنهادِ واجد شرایط برنده میشود. قیمت نهایی پیش از تولید اولین توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کییک طولانی — قفل میشود تا هیچ صورتحساب غیرمنتظرهای صادر نشود. سیستم پرداخت تنها هزینههای مصرفشده بر اساس اندازهگیری دقیق (Metered Usage) را پوشش میدهد.
مشخصات فنی و کنترلها
توسعهدهندگان میتوانند با تغییر یک URL ساده، این سرویس را به ابزارهایی مثل Claude Code، Cursor، Cline، Codex، OpenCode و Pi متصل کنند و سازگاری کامل خود را با این ابزارها حفظ نمایند. این پلتفرم کنترلهای دقیقی ارائه میدهد:
- سقف عملکرد: تعیین محدودیت برای زمان تا نخستین توکن (Time-to-first-token) و حداقل توان عملیاتی (Throughput). این تمرکز بر سرعت پاسخدهی، مشابه قابلیت پاسخدهی زیر میلیثانیهی API شرکت Groq است که برای برنامههای بلادرنگ طراحی شده است.
- حاکمیت دادهها: گزینههایی برای عدم ذخیرهسازی دادهها (ZDR)، انتخاب مناطق جغرافیایی مورد تأیید و لیست سفید ارائهدهندگان.
- حالت خودکار: قابلیتی که بهترین مدل را برای هر واحد کاری بهطور خودکار انتخاب میکند.
- پیشتنظیمهای مسیریابی: طبق پست لینکدین Harrison، این سیستم از پیشتنظیمهای قوانین مسیریابی و پشتیبانی کامل از مدلهای چندوجهی (Multimodal) برخوردار است.
شفافیت بازار
برخلاف APIهای سنتی، Liquid Inference دادههای بازار را بهطور شفاف نمایش میدهد. دارندگان حساب میتوانند دفتر سفارشات زنده (Live Order Books)، قیمتهای هر ارائهدهنده و هر مدل، و تراکنشهای نهایی شده را مشاهده کنند. این یعنی خریدار دقیقاً میداند بازار در لحظه چه قیمتی برای هر مدل خاص تعیین کرده است.
برای ارائهدهندگان نیز فرآیند ورود بسیار سریع است. Harrison، یکی از مدیران Architect، اعلام کرد که تأیید ارائهدهندگان جدید «در عرض چند دقیقه، نه چند هفته» انجام میشود. ارائهدهندگان از طریق APIهای REST و WebSocket مدلهای خود را ثبت کرده و قیمتها را بر اساس ظرفیت خالی GPUهایشان بهروز میکنند. پرداختها از طریق Stripe و بر اساس سوابق تفکیکشدهی هر پروژه انجام میشود.
چشمانداز رقابتی
در مقایسه با OpenRouter و Hugging Face، مدل Liquid Inference متفاوت است. در حالی که OpenRouter از توازن بار بر اساس قیمت (Price-weighted load balancing) استفاده میکند و Hugging Face بهطور پیشفرض سریعترین ارائهدهنده را انتخاب میکند، این پلتفرم برای هر درخواست یک حراج مجزا برگزار میکند. این سیستم از «صدها» مدل پشتیبانی میکند و برای ۵۰۰ کاربر اول، ۲۰ دلار اعتبار رایگان در نظر گرفته است. همچنین یک برنامه معرفی (Referral) وجود دارد که ۲۰٪ از هزینههای ارجاعشده را بهعنوان استنتاج رایگان و ۱۰٪ برای ارجاعات سطح دوم پرداخت میکند.
این مدل، اقتصاد استقرار AI را بهطور بنیادی تغییر میدهد. Architect با ایجاد کشف قیمت دوطرفه، «وابستگی به ارائهدهنده» (Provider Lock-in) را که معمولاً توسعهدهندگان را مجبور به پذیرش قیمتهای یک فروشنده واحد میکند، از بین میبرد. حالا مزیت به نفع خریدار است که میتواند استنتاج را بهجای یک سرویس انحصاری، شبیه به یک کالای عمومی (Commodity) ببیند.
برای یک توسعهدهنده، این یعنی زیرساخت AI او بدون تغییر در حتی یک خط از منطق اصلی کدها، ارزانتر و منعطفتر میشود. شما دیگر یک اشتراک نمیخرید، بلکه در بازار نقدیِ (Spot Market) هوش مصنوعی شرکت میکنید.
باید منتظر ماند و دید این مدل حراج چگونه بر استراتژی قیمتگذاری آزمایشگاههای بزرگی مثل OpenAI و Anthropic تأثیر میگذارد، زیرا آنها ممکن است مجبور شوند در سطح هر درخواست، با خوشههای GPU مستقل و کمهزینهتر رقابت کنند.
گام بعدی شما
- اگر از ابزارهای کدنویسی AI استفاده میکنید، بررسی کنید آیا امکان تغییر Base URL برای اتصال به بازارهای حراج وجود دارد یا خیر.
- هزینههای استنتاج فعلی خود را با قیمتهای لحظهای بازار مقایسه کنید تا میزان اتلاف بودجه را بسنجید.
- مدلهای ارزانتر اما بهینهتر را در حالت Auto Mode تست کنید تا تعادل میان هزینه و کیفیت را بیابید.
اما اثر این مدل حراج بر استراتژی قیمتگذاری غولهایی مثل OpenAI و Anthropic میتواند بسیار تندتر باشد — به تحلیل ما دربارهی جنگ قیمتهای توکنها مراجعه کنید.



گفتگو