اگر به دنبال این هستید که بدانید کدام مدل واقعاً در کارهای پیچیده اداری و تحلیلی دقیقتر است، دیگر نمیتوانید به بنچمارکهای عمومی تکیه کنید. رقابت برای رسیدن به مرز هوش مصنوعی اکنون به سمتی رفته است که تمرکز اصلی بر بنچمارکهای خصوصی و غیرقابلدستکاری (non-gameable) معطوف شده است. مدلها یاد گرفتهاند چگونه در آزمونهای عمومی تقلب کنند، نه اینکه واقعاً باهوشتر شوند.
به همین دلیل، پلتفرم Artificial Analysis در ۵ سپتامبر ۲۰۲۶، نسخه ۴.۲ از شاخص هوش مصنوعی (Intelligence Index) خود را منتشر کرد. این بهروزرسانی میانمدت برای مقابله با پدیده «گیمینگ» یا بهینهسازی مدلها برای کسب نمره در آزمونهای عمومی طراحی شده است. آزمایشگاههای هوش مصنوعی به طور فزایندهای مدلهای خود را برای بنچمارکهای عمومی بهینه میکنند که این امر باعث ایجاد یک اثر ماسککننده بر شکافهای عملکردی در دنیای واقعی میشود. هدف از تغییر وزندهی این شاخص، ارائه ارزیابی صادقانهتری از نحوه مدیریت کارهای دانشمحور، پیچیده و چندمرحلهای توسط مدلها است.
زمینه و زمانبندی
از زمان عرضه نسخه ۴ این شاخص در ژانویه، هشت ماه میگذرد. تیم توسعهدهنده تعمداً بهروزرسانیها را به تأخیر انداخته بود تا در طول عرضه مدلهای بزرگ اخیر، پایداری سیستم حفظ شود. با این حال، از آنجایی که مرزهای تکنولوژی در هفتههای اخیر با سرعت بسیار زیادی جابجا شدهاند، این بهروزرسانی میانمدت تسریع شد تا اطمینان حاصل شود که شاخص همچنان مرتبط و کاربردی باقی میماند.
این تغییرات در واقع به عنوان پلی برای رسیدن به نسخه ۵ عمل میکنند؛ نسخهای که تیم ماههاست در حال برنامهریزی و ساخت آن است. انتظار میرود در آینده نزدیک، نسخههای تکمیلی و تدریجی بیشتری نیز منتشر شود.
چارچوبهای ارزیابی جدید
برای افزایش استواری و استحکام ارزیابیها، شاخص v4.2 دو ستون اصلی ارزیابی را معرفی کرده است:
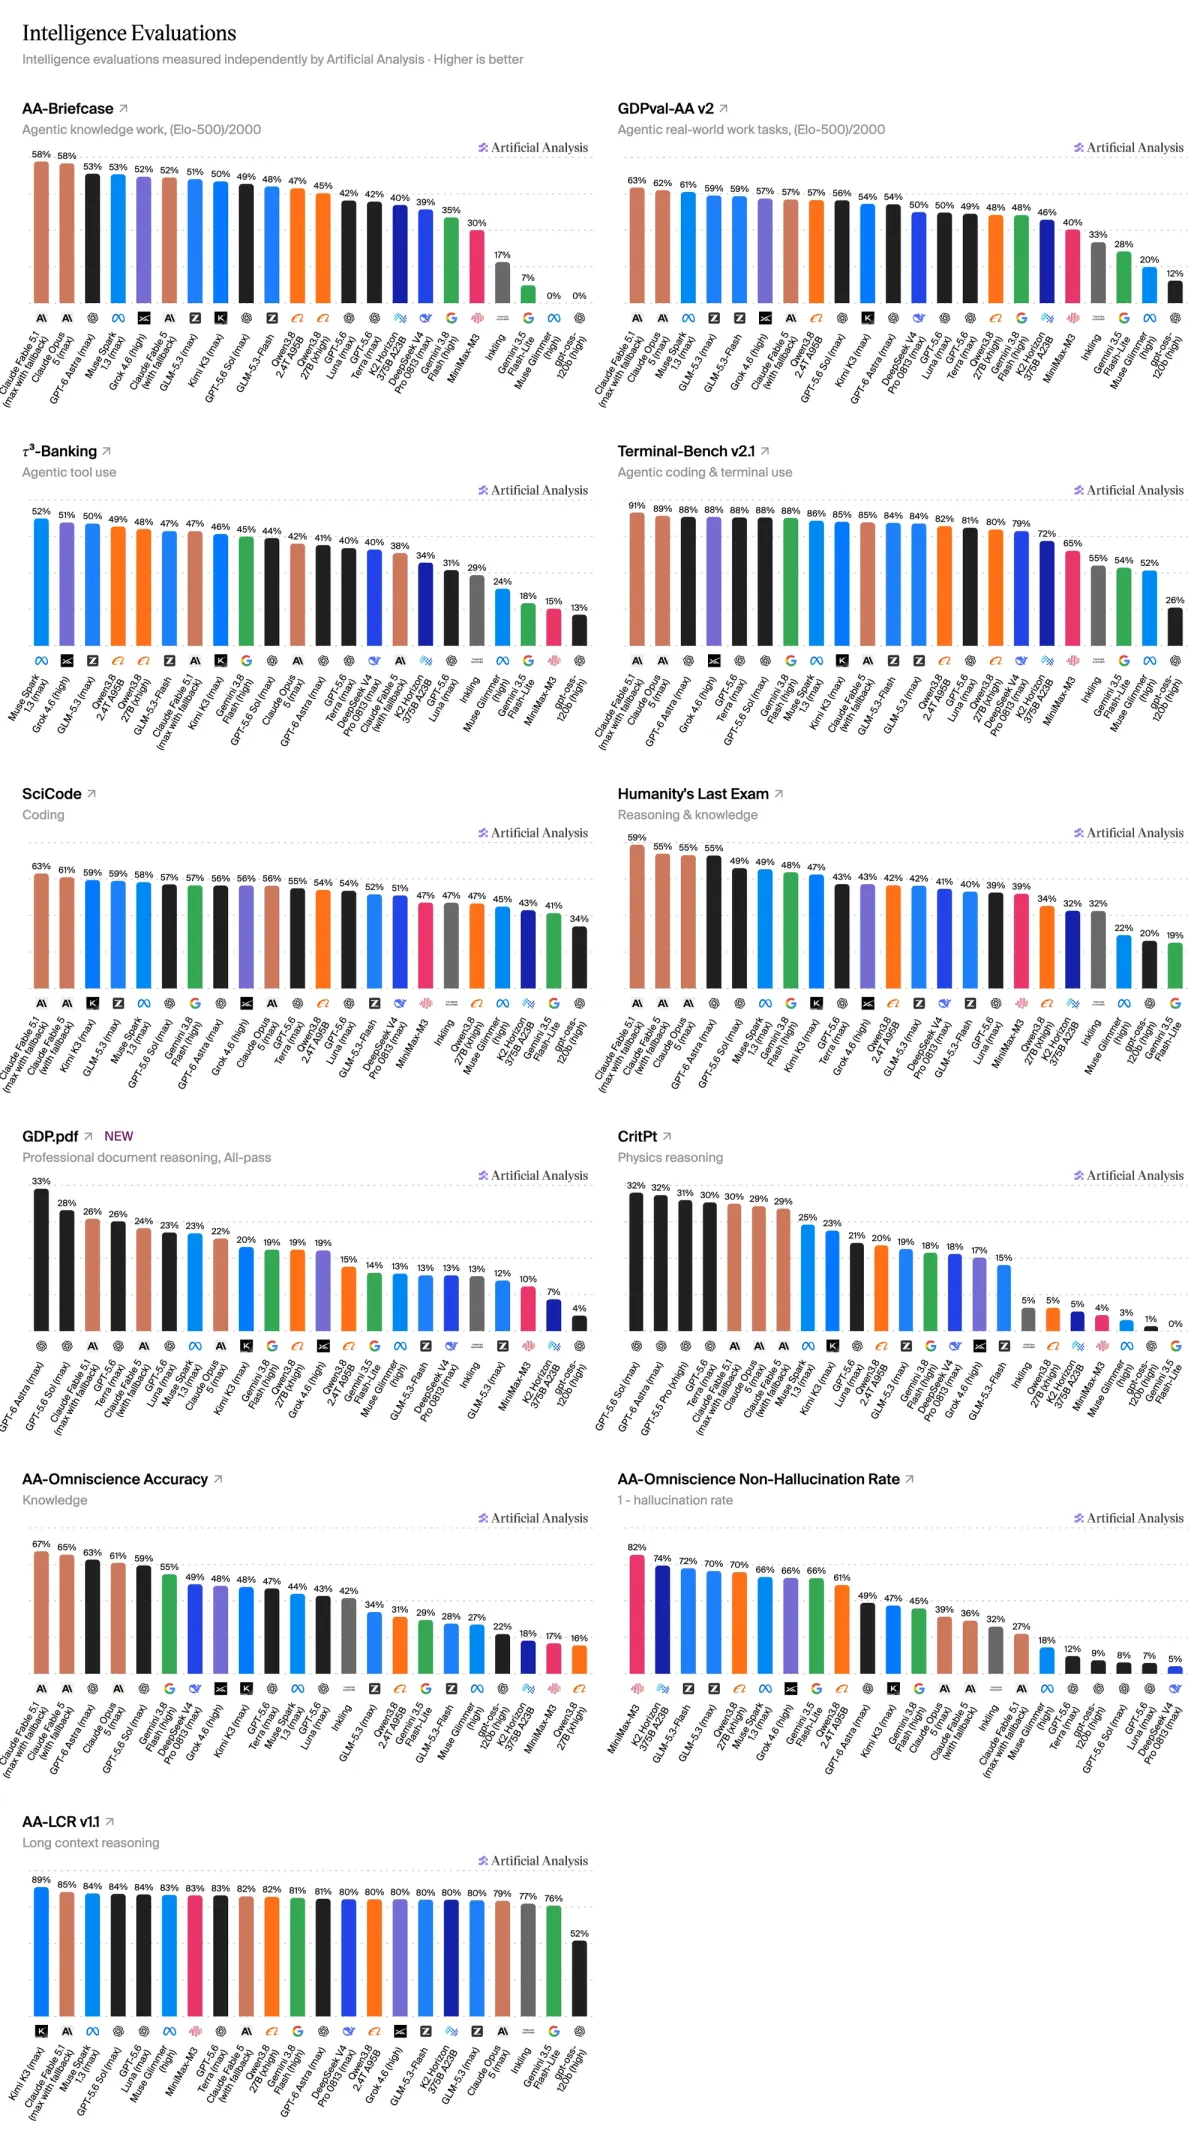
- AA-Briefcase: یک ارزیابی خصوصی و داخلی است که بر کارهای عاملمحور (Agentic) تمرکز دارد. این سیستم مدلها را در پروژههای چند هفتهای میسنجد که توسط متخصصان صنعت طراحی شده و شامل هزاران فایل منبع و بسیاری از وظایف مرتبط با یکدیگر است. این رویکرد در راستای تحولی است که اجرای ایدهها را از محیطهای سادهی چت به سمت معماریهای عاملمحور و سریعتر سوق میدهد. برای اندازهگیری موفقیت قابل تأیید در انجام وظایف، کیفیت تحلیلی و کیفیت ارائه، از ترکیبی از سیستمهای روبریگی (Rubric) و درجهبندی جفتی (Pairwise) استفاده میشود.
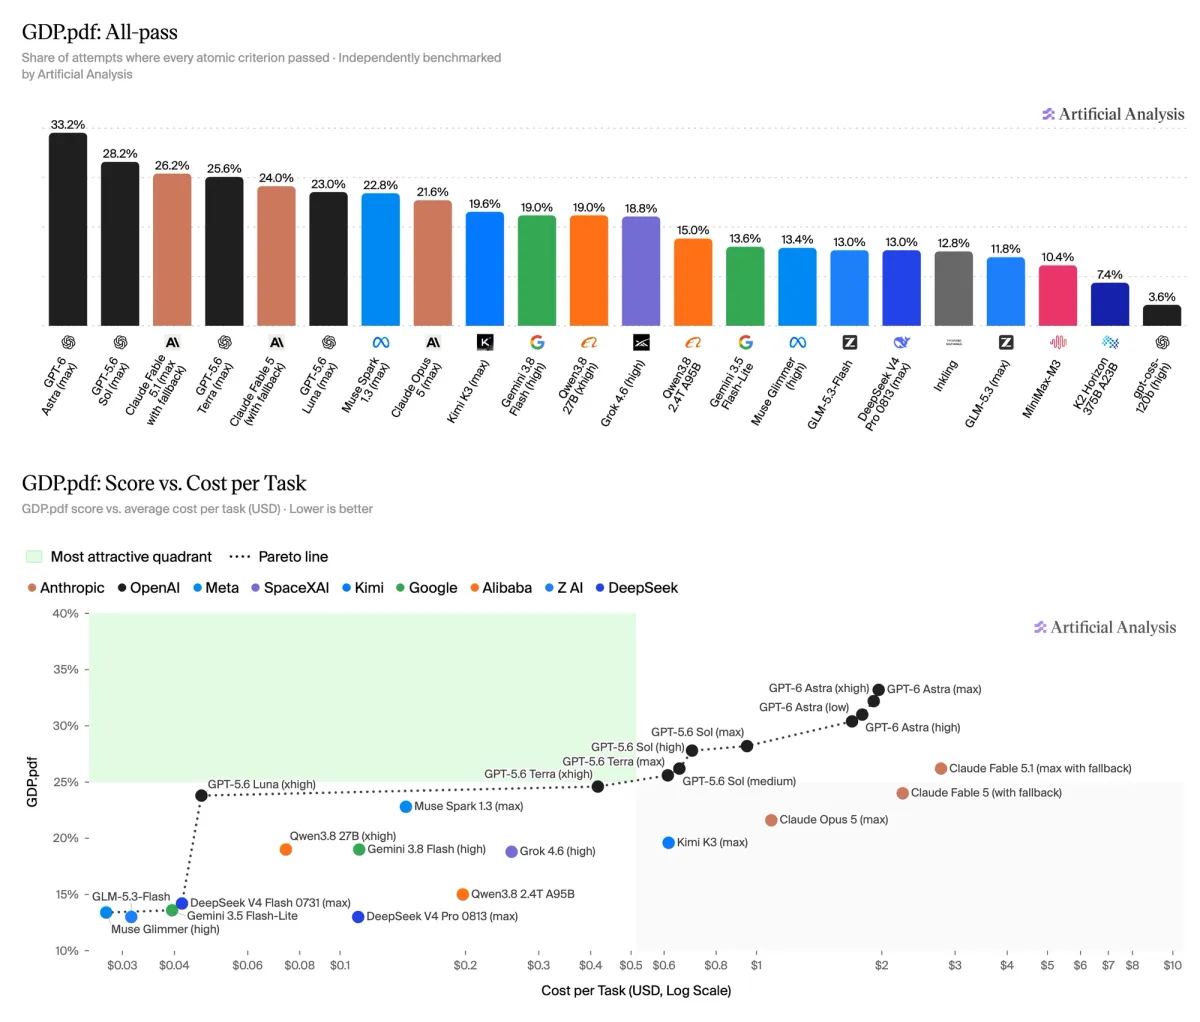
- GDP.pdf: این محک که توسط Surge AI توسعه یافته، توانایی استدلال روی اسناد حرفهای را در قالب تک-گام (single-turn) در ۱۰۰ فایل PDF و ۱۰ حوزه مختلف بررسی میکند. مدلها باید شواهدی را که در ۴۵۹۲ صفحه توزیع شدهاند (شامل متن، جداول، نمودارها، پاورقیها و موارد استثنا شده) ترکیب و سنتز کنند. پاسخها بر اساس ۱۲۷۵ معیار اتمیک (atomic criteria) که توسط متخصصان نوشته شدهاند، درجهبندی میشوند؛ به گونهای که یک وظیفه تنها زمانی پذیرفته میشود که تکتک این معیارها برآورده شده باشند.
جدول ردهبندی جدید
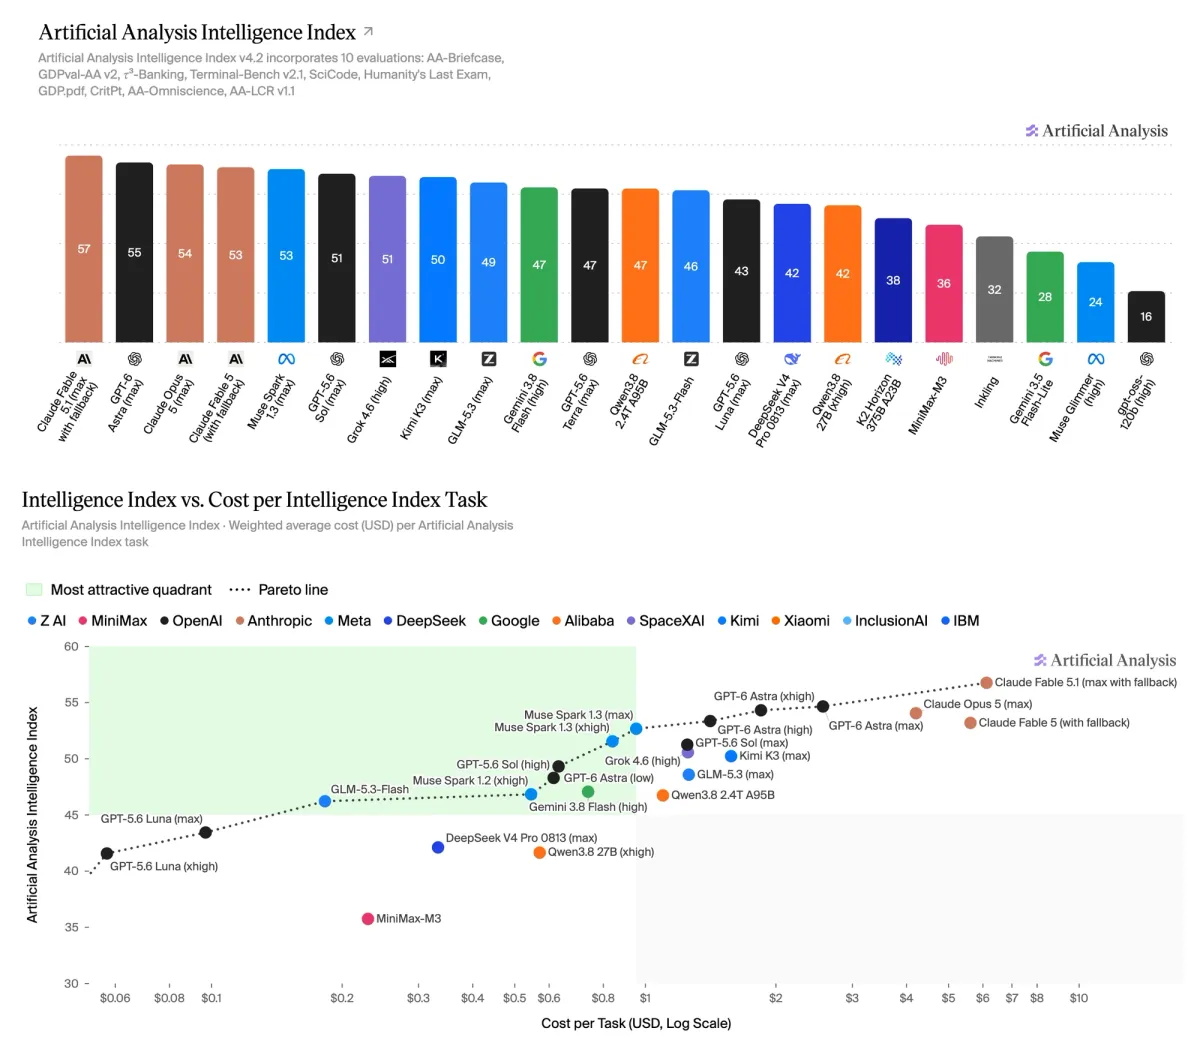
طبق گزارش Artificial Analysis، مدل Claude Fable 5.1 از شرکت Anthropic در حال حاضر در صدر کل شاخص قرار دارد. در رتبه دوم، GPT-6 Astra از شرکت OpenAI قرار گرفته است که پیشرفت ۴ امتیازی را نسبت به مدل قبلی خود، یعنی GPT-5.6 Sol، نشان میدهد. شرکت Meta به عنوان سومین آزمایشگاه توانمند رتبهبندی شده و پس از آن به ترتیب SpaceXAI، Moonshot/Kimi، Z.AI و Google قرار دارند.
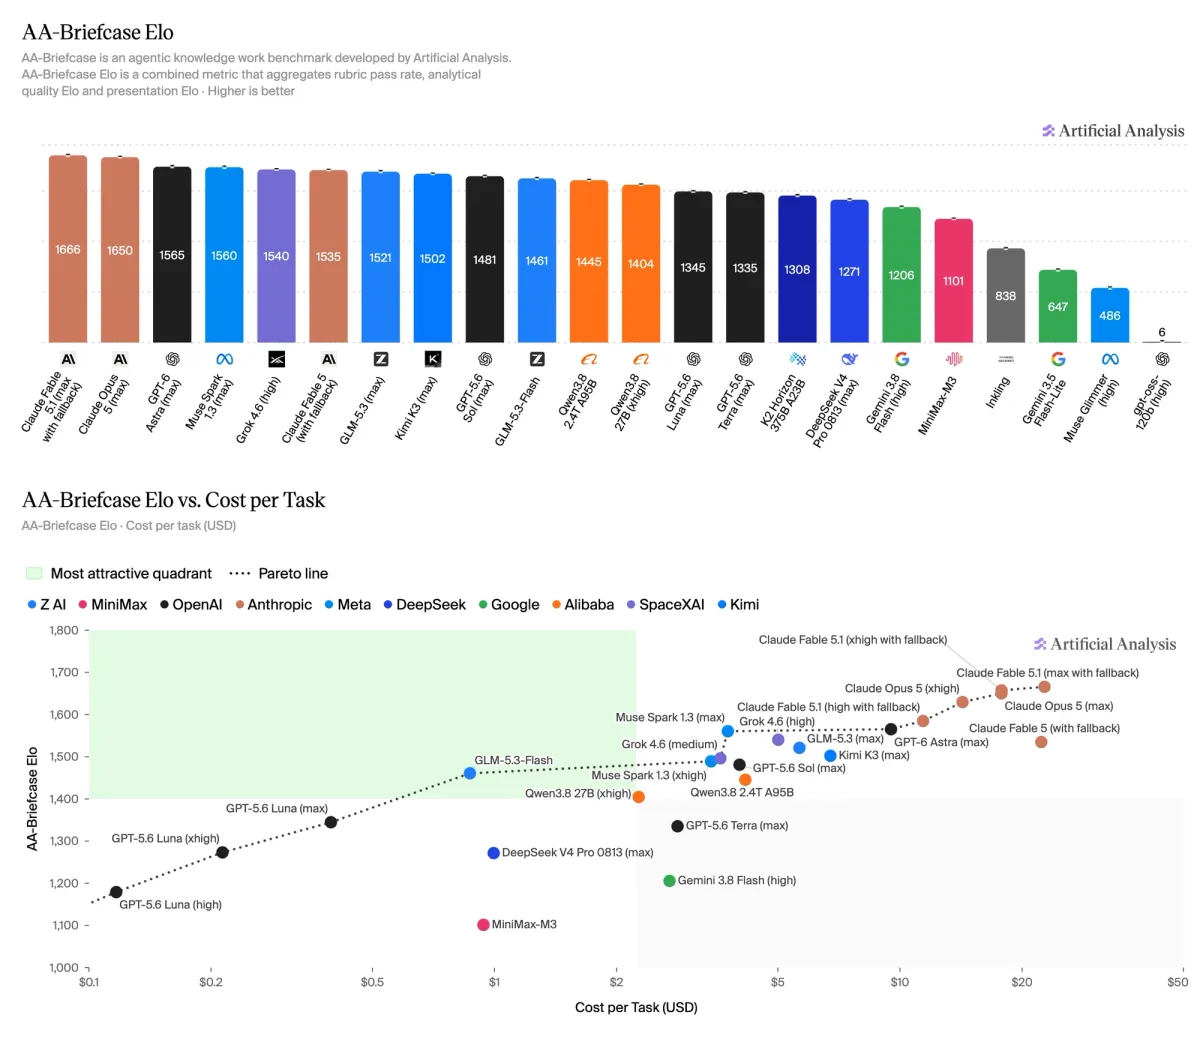
در دستههای تخصصی، نتایج متفاوت است. مدلهای Claude Fable 5.1 و Opus 5 در وظایف عاملمحور AA-Briefcase پیشتاز هستند، هرچند GPT-6 Astra در این دسته پیشرفت قابل توجهی (حدود ۸۵ امتیاز Elo) نسبت به GPT-5.6 Sol نشان داد. برای استدلال روی اسناد با بافت طولانی (GDP.pdf)، مدل GPT-6 Astra با نرخ موفقیت کلی ۳۳.۲٪ تسلط دارد و پس از آن GPT-5.6 Sol با ۲۸.۲٪ و Claude Fable 5.1 با ۲۶.۲٪ قرار گرفتهاند.
بهرهوری و هزینه
فراتر از هوش خام، این بهروزرسانی به «مرز پارتو» هزینه در هر وظیفه (Cost per Task) پرداخته است که در حال حاضر توسط شرکتهای Anthropic، OpenAI، Meta و Z.AI اشغال شده است.
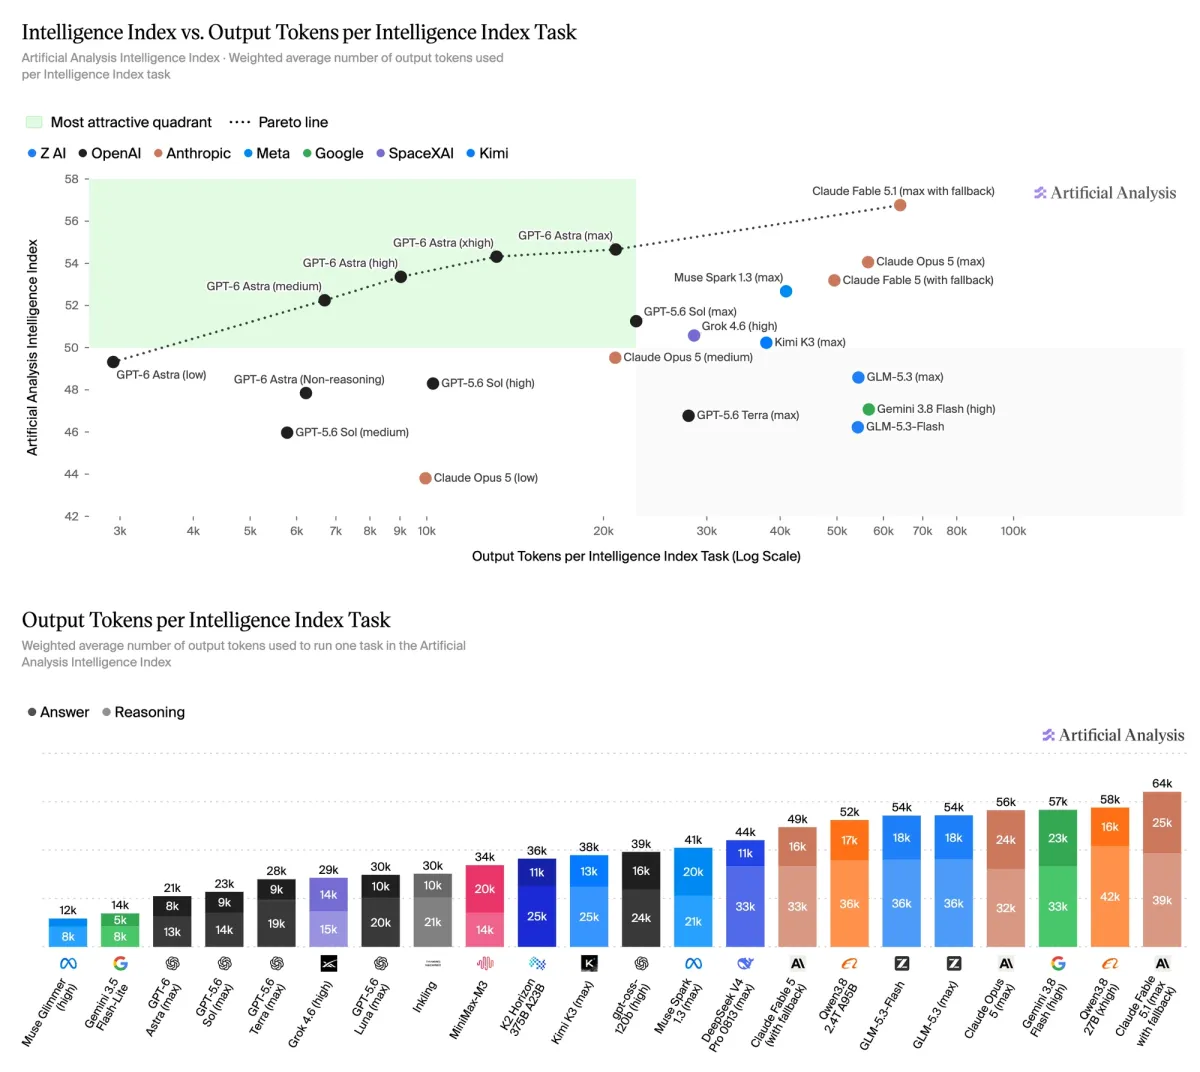
مدل GPT-6 Astra به عنوان توکنبهینهترین مدل در نزدیکی مرز هوش شناسایی شده است. این مدل نسبت به تقریباً تمام مدلهای همرده خود بهینهتر است. در مقابل، مدلهایی مانند Claude Fable 5.1، Grok 4.5 و Gemini 3.5 Flash-Lite در دو انتهای منحنی بهرهوری قرار دارند (البته مدلهایی که نمره زیر ۲۵ در شاخص کسب کردهاند، از این مقایسه حذف شدهاند).
ارتقای زیرساختهای فنی
برای تضمین پایداری نمرات، تیم زیرساختهای درجهبندی خود را ارتقا داده است:
- AA-LCR v1.1: یک پرامپت سیستم برای درجهبندی اضافه شد و خطاها و ابهامات در کلیدهای پاسخ برای بهبود دقت نمرهدهی اصلاح گردید.
- GDPval-AA v2 و AA-Briefcase: نمونهبرداریها بهبود یافت و مقیاس Elo مجدداً لنگر انداخته شد (re-anchored) تا با اضافه شدن مدلهای جدید، رتبهبندیها پایدارتر بمانند.
- SciCode: محیطهای اجرای کد (Sandboxes) تقویت شدند تا اطمینان حاصل شود کدهایی که اجرای کندی دارند اما صحیح هستند، دیگر به عنوان شکست (failure) علامتگذاری نشوند. این بهینهسازیهای زیرساختی در حالی صورت میگیرد که در سطح سختافزاری نیز راهکارهایی مانند معماری ویفری برای حذف گلوگاههای ارتباطی و افزایش سرعت استنتاج در حال توسعه هستند.
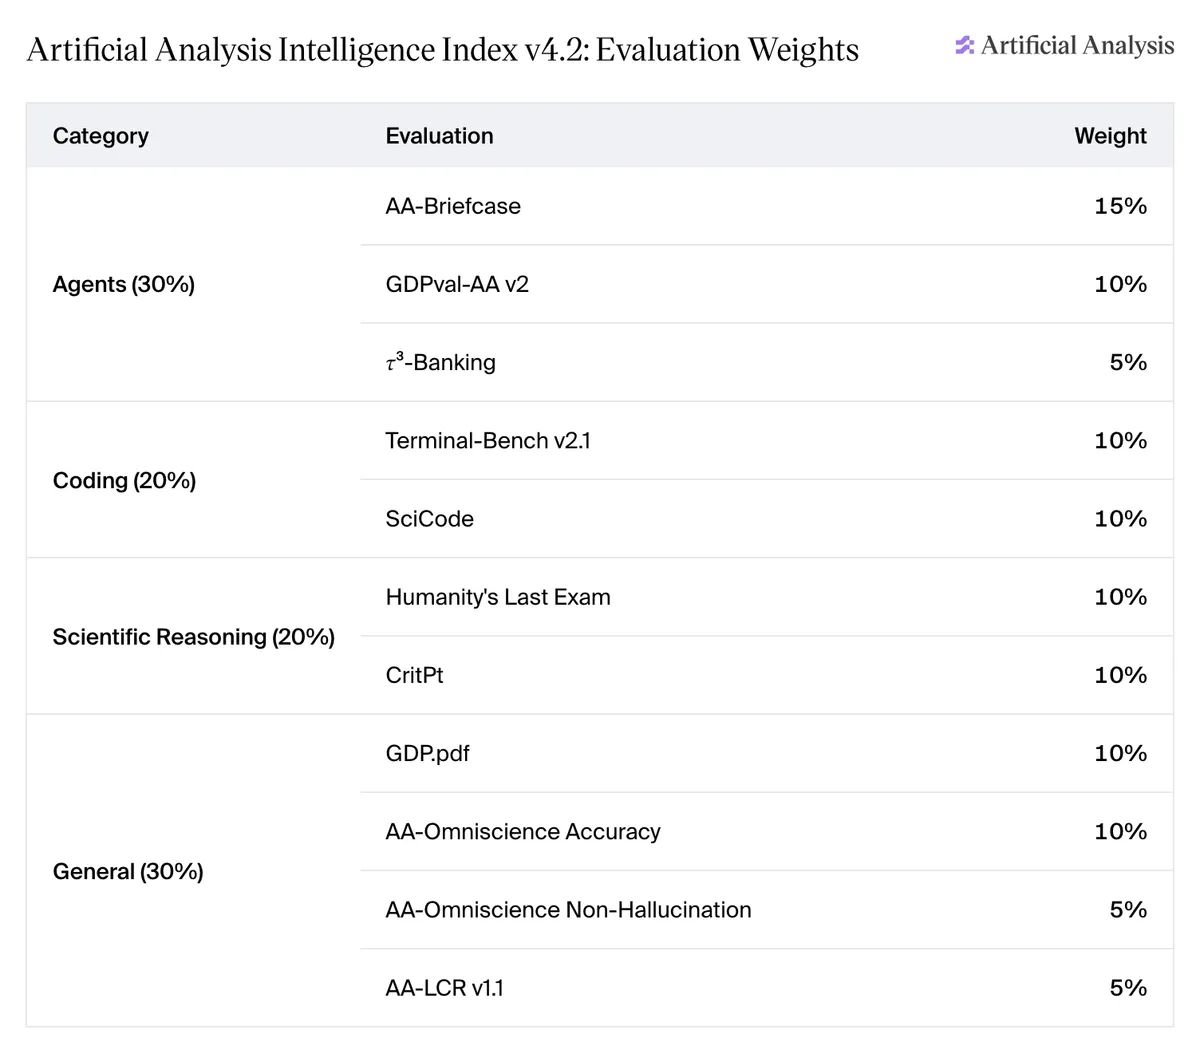
این چرخش به سمت دادههای خصوصی، یک تغییر بنیادین در متدولوژی بنچمارکگذاری است. با اختصاص ۴۰٪ از وزن شاخص به دادههای خصوصی — که دو برابر مقدار ۲۰٪ در نسخه ۴.۱ است — Artificial Analysis مدلها را مجبور میکند تا از تعقیب نمرات بنچمارکهای عمومی فاصله بگیرند. این دادههای پنهان شامل AA-Briefcase، AA-Omniscience و پاسخهای CritPt است. انتظار میرود درصد دادههای پنهان در نسخه ۵ حتی بیشتر شود.
در حالی که تیم برای عرضه کامل نسخه ۵ آماده میشود، صنعت باید نظارهگر باشد که آیا سایر ارزیابان نیز برای مقابله با اشباع تستهای استدلال علمی عمومی (مانند GPQA Diamond)، از وزندهیهای مشابه برای مجموعههای خصوصی استفاده میکنند یا خیر.
گام بعدی شما
- اگر از مدلهای Claude برای مدیریت پروژههای حجیم استفاده میکنید، روی قابلیتهای عاملمحور آن در محیطهای پیچیده تمرکز کنید.
- برای تحلیل اسناد PDF بسیار طولانی و استخراج دادههای دقیق، GPT-6 Astra را به عنوان گزینه اول در نظر بگیرید.
- تغییرات در وزندهی بنچمارکها را دنبال کنید تا متوجه شوید کدام مدلها در دنیای واقعی (و نه فقط در کاغذ) پیشرفت کردهاند.
اما تأثیر این تغییر در متدولوژی ارزیابی بر مدلهای متنباز حتی پیچیدهتر است — به تحلیل ما دربارهی مدلهای Llama و رقابت با مدلهای بسته مراجعه کنید.



گفتگو