اگر برای بهبود نتایج جستوجوی فروشگاه آنلاین خود روی مدلهای بازیابی سرمایهگذاری کردهاید، احتمالاً میدانید که تطبیق کلمات هرگز کافی نیست. حالا روشی به نام Bag of Decisions آمده تا به جای گشتن دنبال کلمات، به دنبال «معیارهای تصمیمگیری» بگردد.
طبق گزارشی که در ۱۰ اکتبر ۲۰۲۶ در وبسایت softwaredoug.com منتشر شد، این متد جدید با تبدیل پرسوجوهای کاربر به مجموعهای از معیارهای مشخص، عملکرد بهتری نسبت به روشهای سنتی دارد. در واقع این سیستم از یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — استفاده میکند تا برای هر جستوجوی منحصربهفرد، یک دفترچه راهنمای ارزیابی (Rubric) شامل سؤالات «بله/خیر» بسازد.
بیشتر موتورهای جستوجو هنوز به BM25 یا بازرتبهبندهای سادهای تکیه میکنند که فقط یک سؤال میپرسند: «آیا این سند مرتبط است؟». این رویکرد تفاوتهای ظریف در قصد کاربر را نادیده میگیرد. همانطور که در تحلیلهای قبلی ما دربارهی جستوجوی معنایی (Semantic Search) اشاره کردیم، درک نیت کاربر کلید موفقیت است. برای مثال، در جستوجوی «میز برای کودکان»، یک جستوجوی استاندارد فقط دنبال این کلمات میگردد؛ اما جستوجوی مبتنی بر تصمیم میپرسد: «آیا ارتفاع آن قابل تنظیم است؟»، «آیا برای کودکان ایمن است؟» یا «آیا برای لوازم تحریر جای دارد؟».
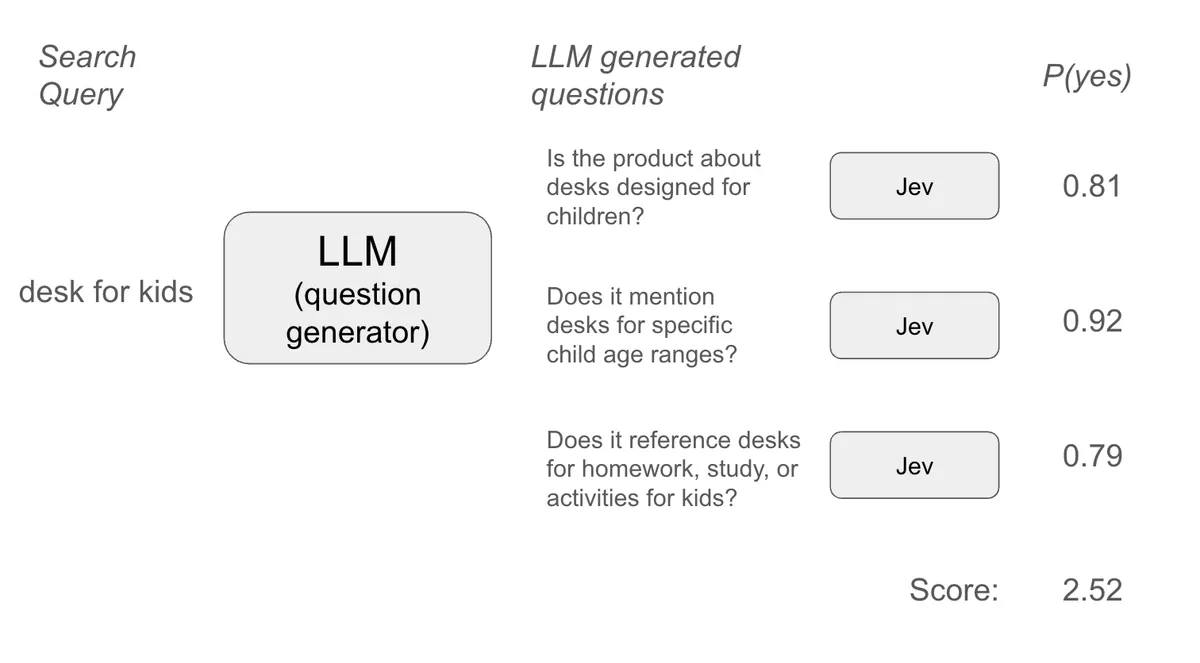
سازوکار این روش با دستور دادن به یک LLM برای ایجاد یک دفترچه راهنمای دقیق آغاز میشود. برای همان مثال میز کودکان، سیستم سؤالاتی درباره ابعاد متناسب با سن و ویژگیهای ایمنی مثل لبههای گرد تولید میکند. سپس هر سؤال توسط Jev — یک بازرتبهبند پیشرفته برای سنجش کیفیت — پردازش میشود تا احتمال پاسخ «بله» برای هر مورد محاسبه شود.
محکهای عملکردی
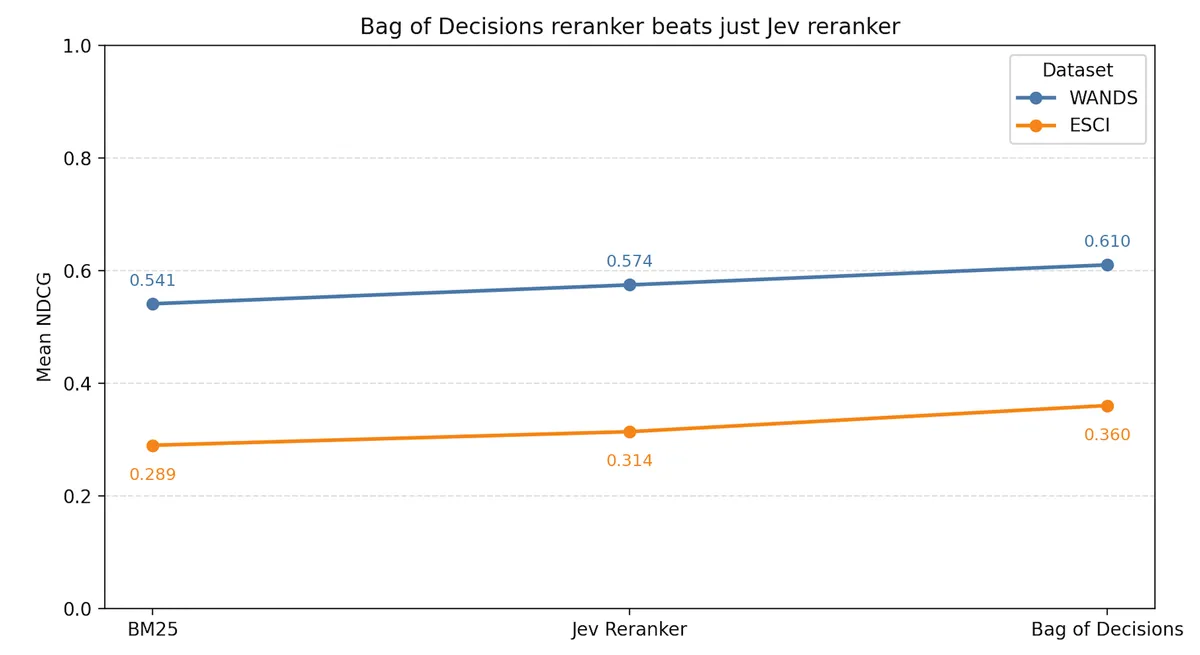
بر اساس مستندات این پژوهش، این رویکرد در برابر BM25 و بازرتبهبند استاندارد Jev روی دو مجموعه داده تجارت الکترونیک آزمایش شد:
- Wayfair WANDS: روش Bag of Decisions به میانگین NDCG برابر با ۰.۶۱۰ رسید که از بازرتبهبند Jev (۰.۵۷۴) و BM25 (۰.۵۴۰۷) بیشتر است.
- Amazon ESCI: این متد امتیاز ۰.۳۶۰ را کسب کرد که بهطور قابلتوجهی بالاتر از Jev (۰.۳۱۴) و BM25 (۰.۲۸۹) بود.
این تغییر به معنای حرکت به سمت «ایجاد ویژگی برای هر پرسوجو» است. سیستم به جای تکیه بر یک مدل ایستا، در لحظه تشخیص میدهد چه چیزی برای آن جستوجوی خاص اهمیت دارد و سپس با یک مدل تصمیمگیر، میزان پوشش آن معیارها در سند را میسنجد.
برای توسعهدهندگان و مهندسان جستوجو، این یعنی گلوگاه دیگر مدل بازیابی نیست، بلکه کیفیت دفترچه راهنمای تولیدشده است. به نظر ما، آموزش مدلهای تصمیمگیر تخصصی میتواند نتایج را در حوزههایی مثل پزشکی یا حقوق به شدت دقیقتر کند.
اگرچه این آزمایش فعلاً در مقیاس کوچک (Toy Study) بوده، اما نشان میدهد تجزیه ارتباط به مجموعهای از احتمالات، مؤثرتر از یک بررسی تکمرحلهای است. چالش بعدی، کاهش تکراری بودن سؤالات تولیدشده توسط LLM برای رسیدن به تحلیلهای تیزتر است.
گام بعدی شما
- اگر از خط لوله تولید بازیابیافزا (RAG) استفاده میکنید، سعی کنید برای مراحل بازرتبهبندی، معیارهای ارزیابی (Rubrics) را به جای یک امتیاز کلی تعریف کنید.
- ترکیب امتیاز احتمالی حاصل از این روش با امتیاز BM25 را برای ایجاد یک رتبهبندی ترکیبی آزمایش کنید.
- روی مدلهای زبانی کوچکتر برای تولید سریعتر این معیارها در لحظه (Real-time) تمرکز کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو