یک حلقه تکرار ساده در یک عامل هوشمند (Autonomous Agent) میتواند پیش از آنکه ارائهدهنده سرویس ایمیل هشدار ارسال کند، هزاران دلار از بودجه یک شرکت را ببلعد. برای متوقف کردن این کابوس مالی، تیمهای مهندسی اکنون درگاههای تخصصی هوش مصنوعی مانند Bifrost را مستقر میکنند تا حفاظهای برنامهریزیشدهای (Programmatic Guardrails) برای هزینههای API ایجاد کنند. برای مدیریت مصرف API که بهطور غیرقابلپیشبینی مقیاس میپذیرد، سازمانها باید بهترین درگاه LLM سازمانی را ارزیابی کنند تا هزینه مدلهای زبانی را از طریق این حفاظهای برنامهریزیشده کنترل نمایند.
این تغییر رویکرد در حالی رخ میدهد که مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — از یک رابط چت آزمایشی به لایهای از زیرساختهای حیاتی تبدیل شده است. طبق گزارشی از dev.to که در ۲۳ اوت ۲۰۲۶ منتشر شد، کسبوکارها اکنون این مدلها را برای وظایف حساس و با ریسک بالا مانند بررسی قراردادها و گردشهای کاری چندمرحلهای مبتنی بر عامل (Agentic Workflows) به کار میگیرند. در این محیطهای عملیاتی، پیشبینیپذیری هزینه به اندازه دقت یا تأخیر (Latency) تعیینکننده است. در واقع، نوسانات شدید قیمتگذاری ارائهدهندگان میتواند بودجهها را به سرعت تخلیه کند؛ چنانکه گزارشهای اخیر Vercel نشان میدهد هزینه توکنهای برخی مدلهای پیشرو مانند Anthropic تا ۴.۴ برابر میانگین بازار است.
همانطور که در تحلیل قبلی ما دربارهی ارجاع وظایف ساده به spaCy برای کاهش هزینهها اشاره کردیم، صنعت اکنون به سمت حاکمیت متمرکز حرکت میکند. درگاههای API سنتی برای این چالش اساساً ناتوان هستند، زیرا آنها تعداد درخواستها را میشمارند، نه میزان مصرف توکن (Token) — که مثل برشهای یک کیک طولانی است و مدل متن را تکهتکه میخورد. یک درخواست تکمرحلهای برای پردازش یک PDF با ۱۰۰ هزار توکن، بسیار گرانتر از ۵۰ پرسوجوی کوتاه است؛ بنابراین آگاهی از توکن برای بقای مالی سازمانها ضروری است. این موضوع باعث شده تا بسیاری از شرکتها میان استفاده از API و میزبانی محلی تردید کنند، چرا که میزبانی شخصی مدلهایی مانند Llama تنها در صورتی بهصرفه است که مصرف ماهانه از ۳۶۱ میلیون توکن فراتر رود.
معماری کنترل هزینه
مدیریت مؤثر هزینه به جای استفاده از یک کلید API کلی، نیازمند رویکردی سلسلهمراتبی است. یک معماری قدرتمند، صرفاً مصرف را در سطح کلید API جهانی ارزیابی نمیکند؛ بلکه بررسیهای سیاستگذاری را بهصورت متوالی در چندین مرز سازمانی اجرا میکند. این تأیید چندسطحی تضمین میکند که یک درخواست ورودی واحد، بهطور همزمان در برابر چندین بودجه مستقل سنجیده شود.
- سطح مشتری (Customer Level): یک بودجه کلان (Macro-budget) را برای یک مستاجر SaaS خاص یا یک شریک تجاری خارجی اعمال میکند تا حاشیه سود ناخالص سازمان حفظ شود.
- سطح تیم (Team Level): هزینههای تجمعی برای بخشهای داخلی (مثلاً تحقیق و توسعه، پشتیبانی مشتریان یا مهندسی محصول) را محدود میکند تا از مصرف کل بودجه شرکت توسط یک تیم واحد جلوگیری شود.
- سطح کلید مجازی (Virtual Key Level): محدودیتهای هزینه را به یک اپلیکیشن خاص، یک میکروسرویس یا یک محیط توسعه (Sandbox) اختصاص میدهد.
- سطح پیکربندی ارائهدهنده (Provider Config Level): مصرف را بر اساس هر ارائهدهنده یا هر مدل خاص محدود میکند. این امر تضمین میکند که تیمها در حالی که گزینههای ارزانتر در دسترس است، صورتحسابهای گزافی برای مدلهای استدلالی (Reasoning Models) گرانقیمت ایجاد نکنند.
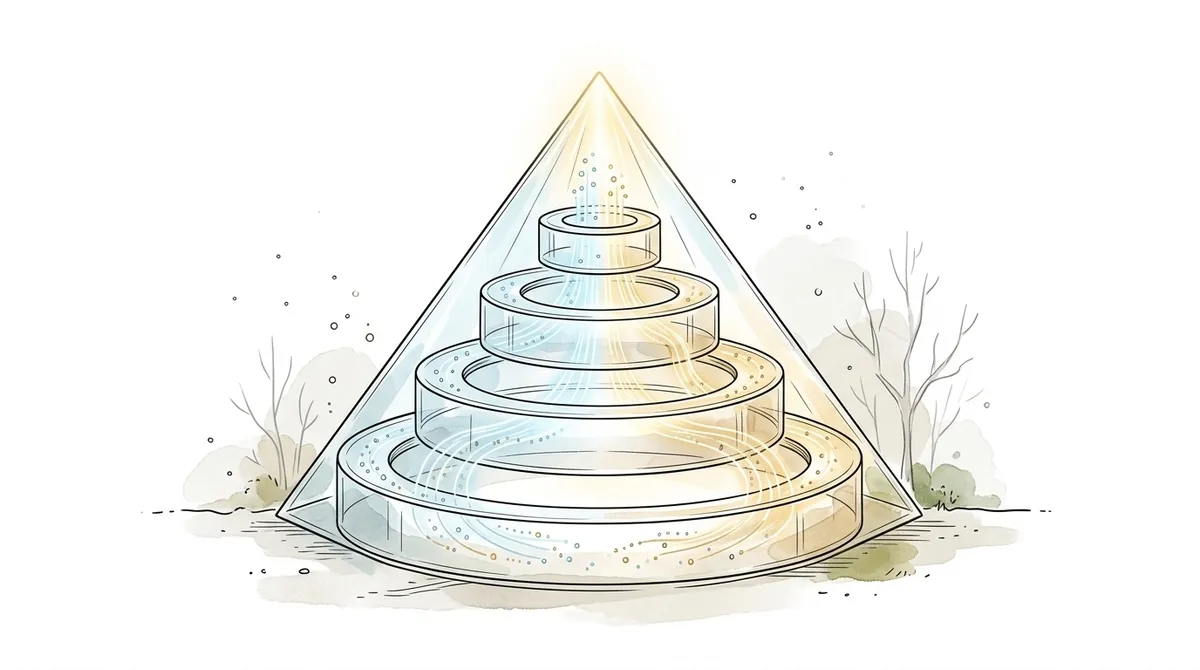
اگر یک درخواست در هر یک از این سطوح از سقف بودجه عبور کند، درگاه تماس را رهگیری کرده، اجرای آن را مسدود میکند و پیش از آنکه هرگونه هزینهای در سمت ارائهدهنده ایجاد شود، یک خطای واضح مبنی بر «محدودیت نرخ» (Rate-limit) یا «اتمام بودجه» بازمیگرداند.
مکانیزمهای محدودیت نرخ توکنمحور
محدودکنندههای نرخ استاندارد، ترافیک را بر اساس فرکانس درخواستهای HTTP ورودی کنترل میکنند. در حالی که این روش از سرورها در برابر حملات منع سرویس (DoS) محافظت میکند، اما برای مدیریت هزینه LLM اساساً بیفایده است، زیرا همه درخواستها تأثیر مالی یکسانی ندارند.
برای جلوگیری از هزینههای سرسامآور LLM، درگاهها باید محدودیتهای نرخ توکنمحور را پیاده کنند. این مکانیزم هم تعداد درخواست در دقیقه (RPM) و هم تعداد توکن در دقیقه (TPM) را میسنجد. نکته کلیدی این است که این محدودیتها به توکنهای ورودی (Prompts) و توکنهای خروجی (Completions) تقسیم میشوند. با تفکیک ردیابی توکنهای ورودی و خروجی، درگاه میتواند کنترلهای مالی دقیقتری را اعمال کند.
تفکیک ردیابی ورودی و خروجی اجازه میدهد کنترلهای مالی دقیقی بر اساس مورد استفاده اعمال شود:
- خط لولههای استخراج داده (Data-Extraction Pipelines): این موارد معمولاً به سقف توکن ورودی بالا برای پردازش اسناد حجیم، اما به سقف توکن خروجی بسیار پایین برای دادههای استخراجشده نیاز دارند.
- دستیارهای نویسندگی خلاق: این ابزارها به پیکربندی معکوس نیاز دارند؛ یعنی محدودیت ورودی کمتر و محدودیت خروجی بالاتر برای تولید محتوا.
پنجرههای بازنشانی منعطف
علاوه بر ردیابی توکن، مدت زمان این محدودیتها باید منعطف باشد تا با عملیات تجاری هماهنگ شود. بهترین درگاههای LLM سازمانی از پنجرههای بازنشانی متنوع پشتیبانی میکنند:
- پنجرههای غلتان (Rolling Windows): ترافیک را بهطور پویا بر اساس یک برش زمانی متحرک، مانند بلوکهای لغزان ۱ دقیقهای یا ۵ دقیقهای، کنترل میکنند.
- بازنشانیهای منطبق با تقویم (Calendar-Aligned Resets): بودجهها و محدودیتهای نرخ را به مرزهای سخت تقویمی در UTC متصل میکنند. این شامل محدودیتهای روزانه، هفتگی، ماهانه، سه ماهه یا سالانه است که کنترلهای هزینه را بهطور کامل با چرخههای مالی شرکت و دورههای صورتحساب فروشندگان هماهنگ میکند.
مقایسه درگاههای پیشرو
Bifrost که توسط Maxim AI توسعه یافته، یک درگاه هوش مصنوعی متنباز است که با زبان Go نوشته شده است. این ابزار به عنوان بهترین درگاه LLM سازمانی برای کنترل هزینه در بارهای کاری سنگین تولیدی معرفی شده است. در بنچمارکهای عملکرد پایدار، Bifrost تنها ۱۱ میکروثانیه تأخیر (Overhead) به هر درخواست اضافه میکند تا اطمینان حاصل شود که کنترلهای هزینه باعث افت عملکرد اپلیکیشن نمیشوند.
Bifrost هزینه و حاکمیت را از طریق «کلیدهای مجازی» مدیریت میکند؛ توکنهای API رو به مشتری که سیاستهای صریحی درباره مدلهای مجاز، ارائهدهندگان و مرزهای مالی دارند. این ابزار از یک ساختار بودجه سلسلهمراتبی بومی چهارلایه (مشتری > تیم > کلید مجازی > پیکربندی ارائهدهنده) استفاده میکند که محدودیتها را بهصورت تجمعی بررسی میکند. برای مثال، اگر یک کلید مجازی متعلق به یک تیم باشد، هر درخواست با استفاده از آن کلید، بهطور همزمان در برابر بودجه کلید و بودجه تیم والد در لحظه (Real-time) بررسی میشود.
همچنین Bifrost از تراز تقویمی برای بازنشانی بودجه پشتیبانی میکند و به تیمها اجازه میدهد محدودیتهای ماهانه یا سه ماههای تعیین کنند که دقیقاً در مرزهای تقویمی UTC بازنشانی شوند. علاوه بر این، اگر تیمی به ظرفیت هزینه موقت نیاز داشته باشد، مدیران میتوانند «جایگزینهای بودجه» (Budget Overrides) صادر کنند. این جایگزینها بهطور موقت محدودیتها را برای تعداد مشخصی از چرخههای صورتحساب، بدون تغییر در پیکربندی پایه، گسترش میدهند.
یک مزیت متمایز Bifrost، قابلیت Bifrost Edge است. سازمانها اغلب با مشکل «هوش مصنوعی سایه» (Shadow AI) روبرو هستند؛ جایی که توسعهدهندگان از Claude Desktop, ChatGPT یا عاملهای کدنویسی بهطور محلی روی لپتاپهای خود استفاده میکنند و کنترلهای درگاه را دور میزنند. Bifrost Edge همان سیاستهای حاکمیتی و کنترل هزینه را مستقیماً به نقطه انتهایی (Endpoint) میبرد. این امر تضمین میکند که حتی اپلیکیشنهای چت دسکتاپ یا عاملهای کدنویسی مبتنی بر ترمینال، بهطور خودکار از طریق درگاه مسیریابی شده و همان کلیدهای مجازی، بودجهها و محدودیتهای اعمالشده توسط سازمان را به ارث ببرند.
با قابلیتهای امنیت نقطه انتهایی و مسدودسازی اپلیکیشن، Bifrost Edge از تماسهای مستقیم و بدون نظارت اپلیکیشنهای غیرمجاز با ارائهدهندگان خارجی LLM جلوگیری میکند. مدیران میتوانند این ابزار را در سطح کل ناوگان با استفاده از ابزارهای استاندارد استقرار MDM مانند Jamf, Intune یا Kandji توزیع کنند تا رؤیت کامل هزینهها در سراسر نیروی کار سازمان تضمین شود.
Cloudflare AI Gateway یک سرویس پروکسی مدیریتشده است که روی شبکه لبه (Edge) جهانی کلودفلر اجرا میشود. این سرویس مشاهدهپذیری پایه و کشینگ را برای توسعهدهندگانی که از APIهای محبوب LLM استفاده میکنند فراهم میکند. اخیراً «محدودیتهای هزینه» (Spend Limits) را معرفی کرده است که به تیمها اجازه میدهد بودجههای مبتنی بر هزینه را پیکربندی کنند که هزینه دلاری واقعی درخواستها را بر اساس قیمتهای مدلهای ارائهدهنده ردیابی میکند.
قوانین در Cloudflare میتوانند بر اساس ارائهدهنده، مدل یا متادیتای سفارشی (مانند ارسال ID کاربر یا تگ محیط در هدر درخواست) تعریف شوند. درگاه، هزینه تجمعی را در پنجرههای زمانی غلتان یا ثابت ارزیابی کرده و پس از تخطی از محدودیت، کد وضعیت 429 را بازمیگرداند.
با این حال، برای سازمانهایی که نیاز به تقسیمبندی سلسلهمراتبی عمیق دارند، ممکن است بهترین درگاه برای کنترل هزینه نباشد. محدودیتهای هزینه آن به صورت قوانین مسطح و مستقل ارزیابی میشوند، نه یک سلسلهمراتب تو در تو. علاوه بر این، این یک محصول صرفاً SaaS است. سازمانهایی که نیاز به استقرار در VPC، شبکههای خصوصی یا محیطهای ایزوله (Air-gapped) دارند، نمیتوانند این درگاه را در زیرساخت خصوصی خود اجرا کنند. همچنین فاقد قابلیتهای عامل نقطه انتهایی برای مدیریت ماشینهای محلی توسعهدهندگان است.
LiteLLM یک پروکسی متنباز مبتنی بر پایتون است که بهطور گسترده پذیرفته شده و برای یکپارچهسازی دسترسی به چندین LLM با استفاده از فرمت درخواست OpenAI طراحی شده است. این ابزار ویژگیهای بومی بودجهبندی و محدودیت نرخ را فراهم میکند که در آن کاربران میتوانند کلیدهای مجازی ایجاد کنند، آنها را به تیمها اختصاص دهند و سقفهای سخت هزینه با مدتزمانهای قابل پیکربندی (ساعتی، روزانه، هفتگی، ماهانه یا سالانه) تعیین کنند.
LiteLLM از «جایگزینهای بودجه» (Budget Fallbacks) پشتیبانی میکند که بهطور خودکار درخواستها را در صورت اتمام بودجه یک مدل خاص، به مدلهای جایگزین ارزانتر هدایت میکند. علاوه بر این، یک داشبورد مبتنی بر وب برای مدیریت بودجهها و مشاهده تلهمتری هزینه بهصورت لحظهای ارائه میدهد.
توازن اصلی در اینجا مربوط به عملکرد است. به دلیل اینکه با پایتون نوشته شده است، در بارهای کاری همزمان و پایدار، تأخیر بیشتری نسبت به زبانهای کامپایلشده مانند Go یا Rust ایجاد میکند. در نتیجه، هنگام مقیاسبندی به هزاران درخواست در ثانیه، اغلب بهترین انتخاب نیست. همچنین فاقد یک عامل کلاینت بومی برای مدیریت هوش مصنوعی سایه در نقاط انتهایی است و بررسیهای بودجه تو در تو در چندین سطح، نیازمند پیکربندیهای میانافزار (Middleware) سفارشی است.
Kong AI Gateway بر روی پلتفرم بالغ مدیریت API شرکت Kong ساخته شده و افزونههای تخصصی برای مسیریابی LLM، کشینگ معنایی و مدیریت ترافیک اضافه کرده است. این ابزار مدیریت هزینه را از طریق افزونه «AI Rate Limiting Advanced» انجام میدهد که مصرف توکن (TPM) را به جای تعداد درخواستهای ساده میسنجد و محدودیتها را مستقیماً با معیارهای صورتحساب ارائهدهنده هماهنگ میکند.
دستورالعملهای بهینهسازی هزینه LLM در Kong، کشینگ معنایی و فشردهسازی پرامپت را ترکیب میکنند تا تعداد توکنهای ارسالی به بالا را کاهش داده و هزینه کل را پایین بیاورند. با این حال، این کنترلهای پیشرفته هزینه محدود به لایه لایسنس گرانقیمت Enterprise شرکت Kong است. راهاندازی این کنترلها نیازمند زنجیره کردن چندین افزونه است که منجر به یک منحنی یادگیری تند میشود. این رویکرد افزونهمحور بهندرت بهترین گزینه برای تیمهای مهندسی AI است که نمیخواهند پیچیدگیهای عملیاتی مدیریت یک زیرساخت عظیم API Gateway سازمانی را تحمل کنند.
پیادهسازی دفاع در عمق
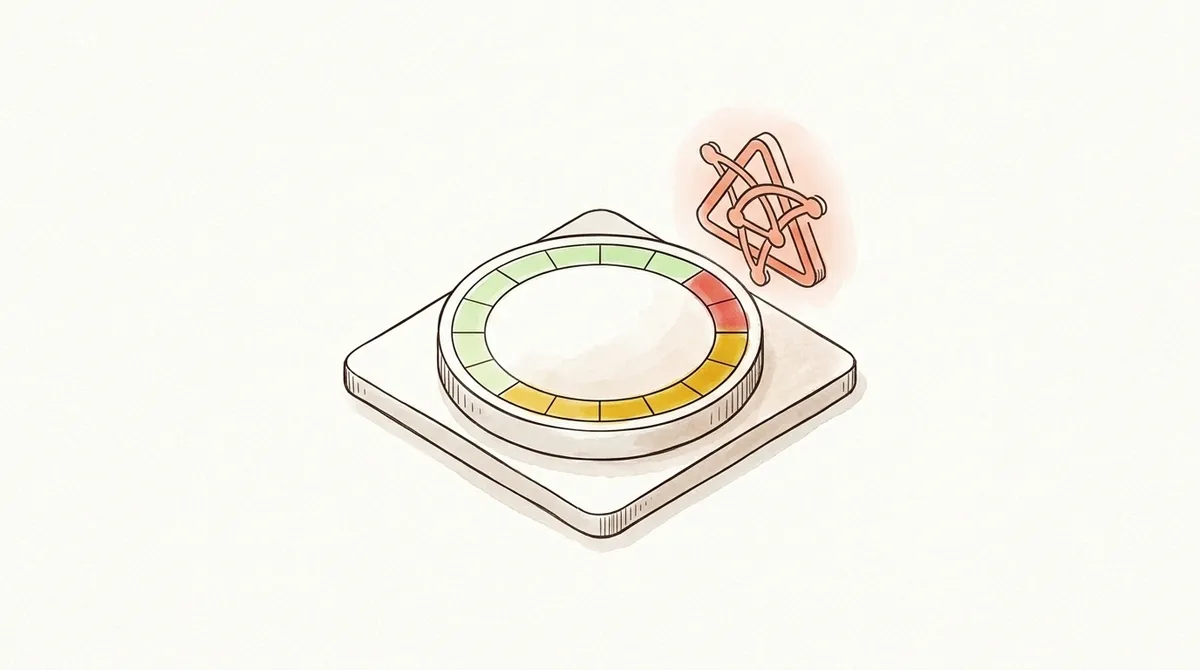
تعریف سیاستهای بودجه تنها گام اول است؛ تیمهای مهندسی باید همچنین تعیین کنند که درگاه در هنگام نزدیک شدن بودجهها به اتمام، چه واکنشی نشان دهد. یک استقرار قدرتمند درگاه، دفاع دو مرحلهای را پیاده میکند: هشدارهای نرم و محدودیتهای سخت.
۱. هشدارهای نرم (Soft Alerts): زمانی فعال میشوند که یک تیم یا کلید مجازی درصد خاصی از بودجه تخصیصی خود (مثلاً ۸۰٪) را مصرف کند. اینها معمولاً از طریق یکپارچگیهای وبهوک پیکربندی میشوند که اعلانها را به Slack، Discord یا مجموعههای نظارتی سازمانی مانند Datadog ارسال میکنند. این هشدارها به اپراتورهای پلتفرم دید اولیه نسبت به جهشهای مصرف میدهند و اجازه میدهد پیش از هرگونه اختلال در سرویس، محدودیتها را تنظیم یا پرامپتها را بهینه کنند.
۲. محدودیتهای سخت (Hard Limits): زمانی فعال میشوند که هزینه تجمعی به ۱۰۰٪ بودجه تعریفشده برسد. در این نقطه، هر درخواست بعدی بلافاصله در سطح درگاه مسدود میشود. درگاه به جای ارسال درخواست به ارائهدهنده LLM، اتصال را قطع کرده و یک کد HTTP 429 (Too Many Requests) یا یک پاسخ خاص مبنی بر اتمام بودجه بازمیگرداند. این امر تضمین میکند که هزینه فوراً متوقف شده و سازمان در برابر هزینههای پیشبینینشده محافظت شود.
برای سرویسهای حیاتی تولیدی، درگاهها باید از «جایگزینی تدریجی» (Graceful Fallbacks) پشتیبانی کنند. اگر بودجه یک مدل پرمیوم تمام شد، قوانین مسیریابی درگاه میتواند بهطور پویا ترافیک ورودی را به یک مدل مقرونبهصرفهتر کاهش دهد (Downgrade)، به جای اینکه اپلیکیشن را بهطور کامل خاموش کند.
چرخش در اقتصاد هوش مصنوعی
این تکامل در ابزارها نشاندهنده یک تغییر گستردهتر در نگاه شرکتها به هوش مصنوعی است. ما در حال حرکت از عصر «قرار دادن کلید API در یک فایل .env» به سمت عصر «زیرساختهای مدیریتشده» هستیم. برنده در این فضای رقابتی، درگاهی نخواهد بود که بیشترین ویژگیها را دارد، بلکه ابزاری است که کمترین تأخیر را در حالی که سختگیرانهترین مرزهای مالی را حفظ میکند، ارائه دهد.
برای توسعهدهنده، این به معنای آزادی کمتر برای آزمایش مدلهای پیشرو (Frontier Models) در محیط تولید بدون نظارت است. برای مدیر مالی (CFO)، این به معنای آن است که هوش مصنوعی بالاخره به یک ردیف پیشبینیپذیر در بودجه تبدیل میشود، نه یک ریسک مالی نوسانی.
برای ایمنسازی پشته (Stack) فعلی خود، باید مصرف API خود را برای شناسایی الگوهای «هوش مصنوعی سایه» بازرسی کنید و ارزیابی نمایید که آیا درگاه فعلی شما از محدودیتهای توکنمحور پشتیبانی میکند یا صرفاً تعداد درخواستها را میشمارد. برای تیمهایی که به بودجههای سلسلهمراتبی عمیق، اجرای با تأخیر کم و رؤیت نقاط انتهایی نیاز دارند، یک درگاه با عملکرد بالا و مبتنی بر Go مانند Bifrost، چارچوب حاکمیتی جامعی را فراهم میکند که برای پایدار نگه داشتن ابتکارات هوش مصنوعی در محیط تولید از نظر مالی ضروری است.
گام بعدی شما
- مصرف API خود را برای شناسایی الگوهای «هوش مصنوعی سایه» (استفادههای غیررسمی توسعهدهندگان) بازرسی کنید.
- بررسی کنید که آیا درگاه فعلی شما محدودیتهای توکنمحور دارد یا صرفاً تعداد درخواستها را میشمارد.
- اگر نیاز به بودجههای سلسلهمراتبی و تأخیر بسیار پایین دارید، استقرار یک درگاه مبتنی بر Go مانند Bifrost را ارزیابی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو