
تصور کنید تمام اسناد حساس و یادداشتهای کاری خود را به دستیاری سپردهاید که هرگز چیزی را فراموش نمیکند، اما وقتی میخواهید آنها را پس بگیرید، در را به روی شما میبندد. این همان وضعیتی است که کاربران فعلی ChatGPT با سیستم جدید ذخیرهسازی دادهها تجربه میکنند. در حالی که ChatGPT اکنون فایلهای کاربر را با دقتی خیرهکننده به خاطر میسپارد، ابزارهای حذف این دادهها بهطور عمدی دشوار طراحی شدهاند.
به گزارش منابع فنی، ابزارهای حذف داده در ChatGPT بهگونهای طراحی شدهاند که فرآیند پاکسازی را بهشدت دشوار میکنند. این وضعیت کاربر را در یک نبرد فرسایشی قرار میدهد: یا باید اجارهٔ فضای ذخیرهسازی را بپردازد و دادههایش را در سرورهای شرکت باقی بگذارد، یا گزینهٔ «هستهای» یعنی حذف کامل حساب کاربری را انتخاب کند تا از شر دادههای انباشته خلاص شود.
این چرخش در حالی رخ میدهد که دستیارهای هوش مصنوعی از چتباکسهای ساده و بدون وضعیت (Stateless) به همراهان دیجیتال دائمی تبدیل میشوند. همانطور که در تحلیل قبلی ما دربارهی پروتکلهای اتصال دادههای خارجی به هوش مصنوعی (MCP) اشاره کردیم، صنعت به سمت یکپارچگی عمیقتر پیش میرود. اما اجرای فعلی کتابخانه (Library) در ChatGPT، دادههای کاربر را به زنجیری تبدیل کرده است که خروج از این اکوسیستم را سختتر از ورود به آن میکند.
چرخش به سمت «ذخیرهسازی بهعنوان سرویس»
طبق اعلام OpenAI، در ۲۳ مارس ۲۰۲۶ قابلیت Library معرفی شد. این ویژگی باعث میشود فایلهای PDF، تصاویر و متنهای ارسالی بهجای حذف پس از پایان هر جلسه، بهصورت دائمی ذخیره شوند. در این سیستم، متنهای ارسالی بهطور خودکار به فایلهای متنی تبدیل و ذخیره میگردند. بر اساس مستندات، این آپلودها بهصورت پیشفرض برای آموزش مدلهای جدید استفاده میشوند، مگر اینکه کاربر بهطور دستی این گزینه را غیرفعال کند.
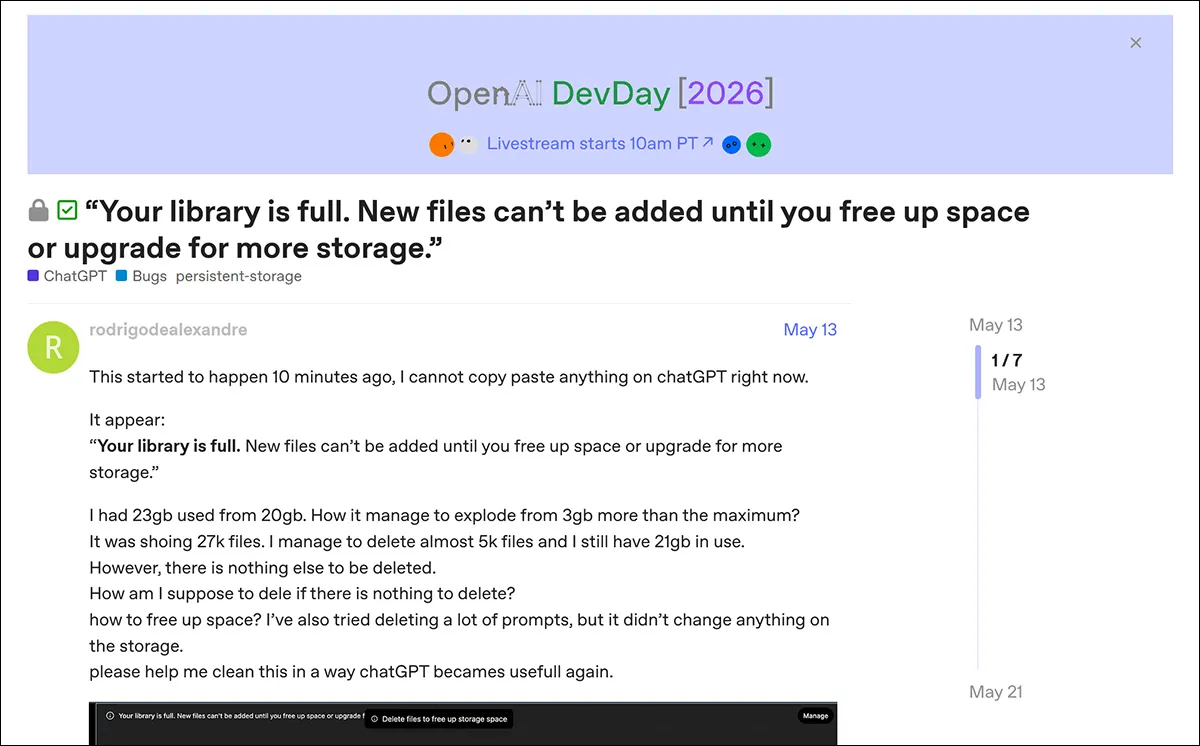
این سامانه در ابتدا شبیه به سطل زبالهٔ ایمیل بود که فایلها را برای ۳۰ روز در یک منطقهٔ انتظار نگه میداشت و سپس آنها را بهطور نهایی حذف میکرد. اما مدل کسبوکار بهسرعت تغییر کرد. از ۵ مه ۲۰۲۶، کاربران نسخههای Plus و Pro در وب به مدل GPT-5.5 Instant دسترسی یافتند. این مدل میتوانست برای بهبود کیفیت پاسخها، از چتهای قدیمی، فایلهای تولیدشده و در صورت اجازه کاربر، حتی از جیمیل (Gmail) استنتاج کند تا زمینههای دقیقتری را درک کند. این سطح از دسترسی به دادههای شخصی، در کنار قابلیتهای جدید کنترل ابزارهای اداری با صدا، ChatGPT را به مرکز فرماندهی دیجیتال کاربر تبدیل میکند.
نه روز بعد، در ۱۴ مه ۲۰۲۶، OpenAI طرحهای پرداختشدهای با محدودیتهای مختلف ذخیرهسازی معرفی کرد. این اقدام، مدل را به یک پارادایم ذخیرهسازی ابری — شبیه به iCloud یا OneDrive — تبدیل کرد. اکنون این سیستم یک راهکار بدون اصطکاک برای «ذخیرهسازی بهعنوان سرویس» است که هدفش استخراج اجارهای دائمی و رو به رشد از کاربر است.
موازنهٔ حافظه و حریم خصوصی
تجمع این «زبالههای تاریخی» هدف فنی خاصی دارد. طبق بررسیها، کتابخانه باعث بهبود چشمگیر تداوم و یادآوری زمینههای خاص هر کاربر در هوش مصنوعی زاینده (Generative AI) میشود، به شرطی که کاربر بهطور روتین آپلودهای خود را پاک نکند. این سیستم تا حد زیادی جایگزین رابط قدیمی حافظه بلندمدت (LTM) شده است.
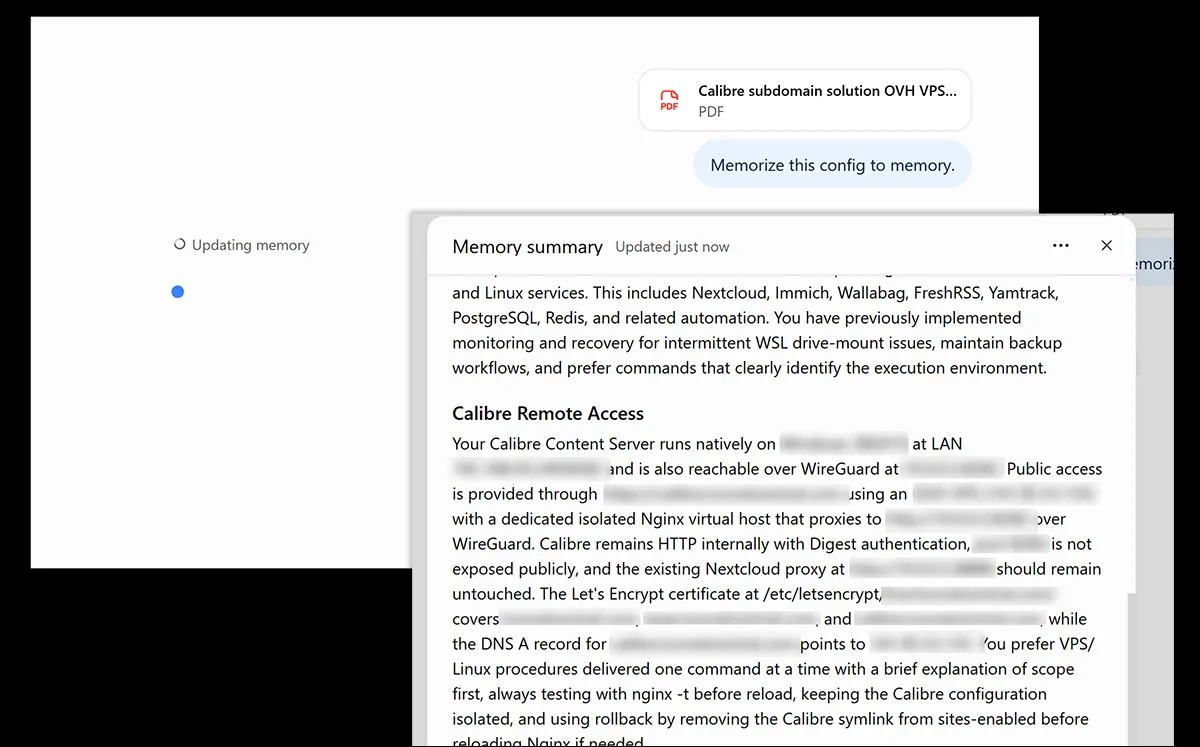
رابط LTM اکنون به ماتریسی مبهم و خود-تکاملیافته از اطلاعات درباره کاربر و دنیای او تبدیل شده که ویرایش آن دیگر ساده نیست. در حالی که کاربر میتواند گهگاه از GPT بخواهد ویژگی خاصی را در LTM ذخیره کند، هوش مصنوعی اغلب پاسخ میدهد که ابزار ثبت LTM در آن چت خاص در دسترس نیست. در واقع، مرکز مدیریت حافظه از این استخر متمرکز LTM به سمت تودهای از اسناد و تصاویری منتقل شده که در چتهای قبلی بهجا ماندهاند. این تمرکز بر دادههای کاربر در حالی است که نگرانیها دربارهی دسترسی پیمانکاران OpenAI به گفتگوهای خصوصی در پروژههایی مانند «لیلی»، بحثهای جدیتری را درباره حریم خصوصی برانگیخته است.
کاربران اکنون با یک موازنه سخت روبرو هستند: یا اسناد حساس — از جمله مدارک شناسایی یا دادههای مشتریان — را به OpenAI بسپارند تا عملکرد مدل حفظ شود، یا کتابخانه را پاک کنند و شاهد افت شدید آگاهی مدل از زمینهٔ کاری خود باشند. این موضوع بهویژه برای کاربرانی که متخصص داده نیستند دشوار است، زیرا آنها نمیتوانند مجموعههای بزرگ داده را بهطور هوشمندانه پالایش کنند و ابزارهای ارائه شده نیز ناکارآمد هستند.
الگوهای تاریک در حذف دادهها
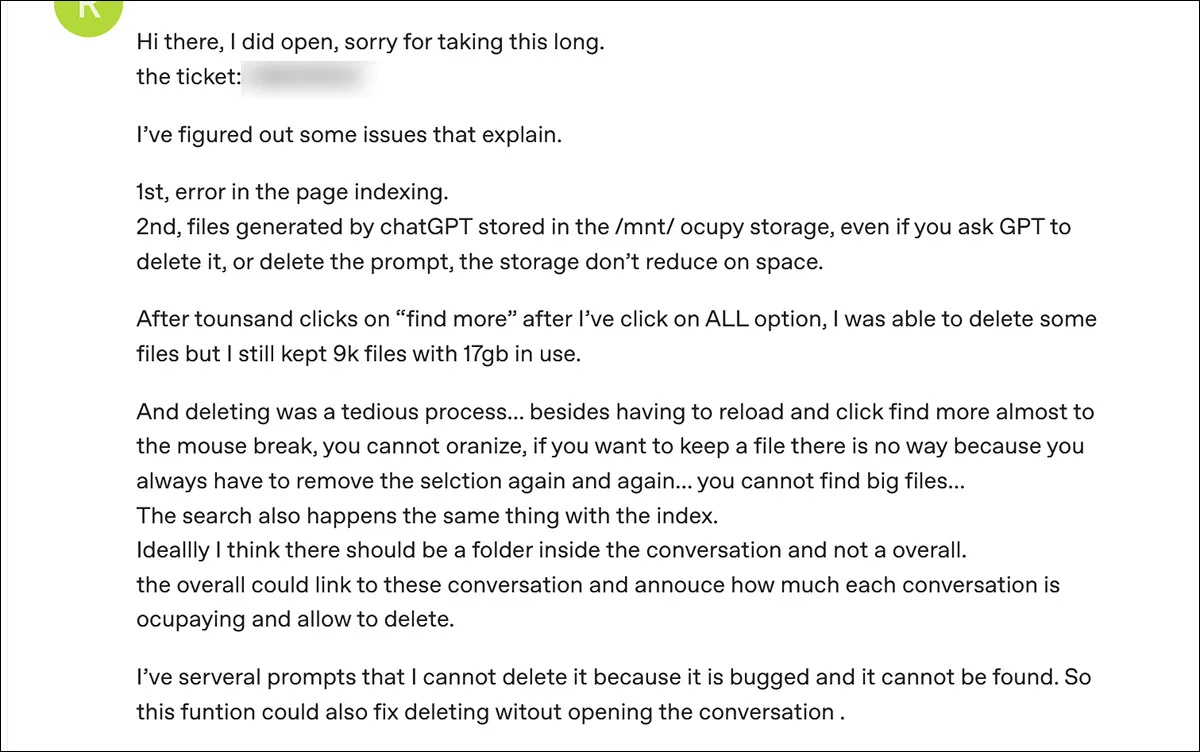
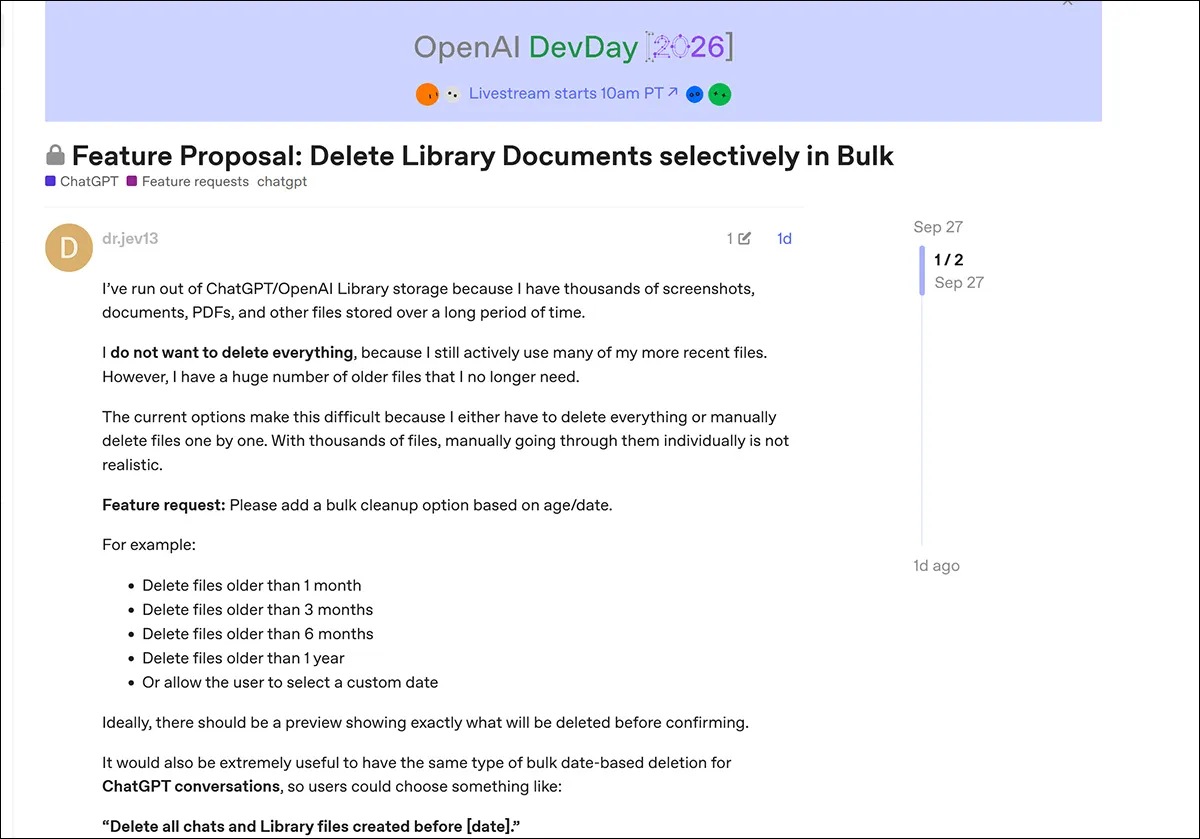
بیشترین اصطکاک در مرحلهٔ حذف دادهها رخ میدهد. بسیاری از کاربران گزارش دادهاند که حذف یک چت، فایلهای مرتبط با آن را پاک نمیکند؛ این آثار دیجیتال بهطور جداگانه از چتهایی که آنها را ایجاد کردهاند مدیریت میشوند. در حال حاضر هیچ گزینهای وجود ندارد که با حذف یک چت، تصاویر و فایلهای وابسته به آن نیز بهطور خودکار پاک شوند.
برای حذف دستی، کاربر باید به رابط کتابخانه برود که از سیستم «بارگذاری تنبل» (Lazy Loading) استفاده میکند. این یعنی دکمهٔ «انتخاب همه» فقط فایلهایی را انتخاب میکند که در آن لحظه روی صفحه نمایش داده میشوند، نه کل کتابخانه را.
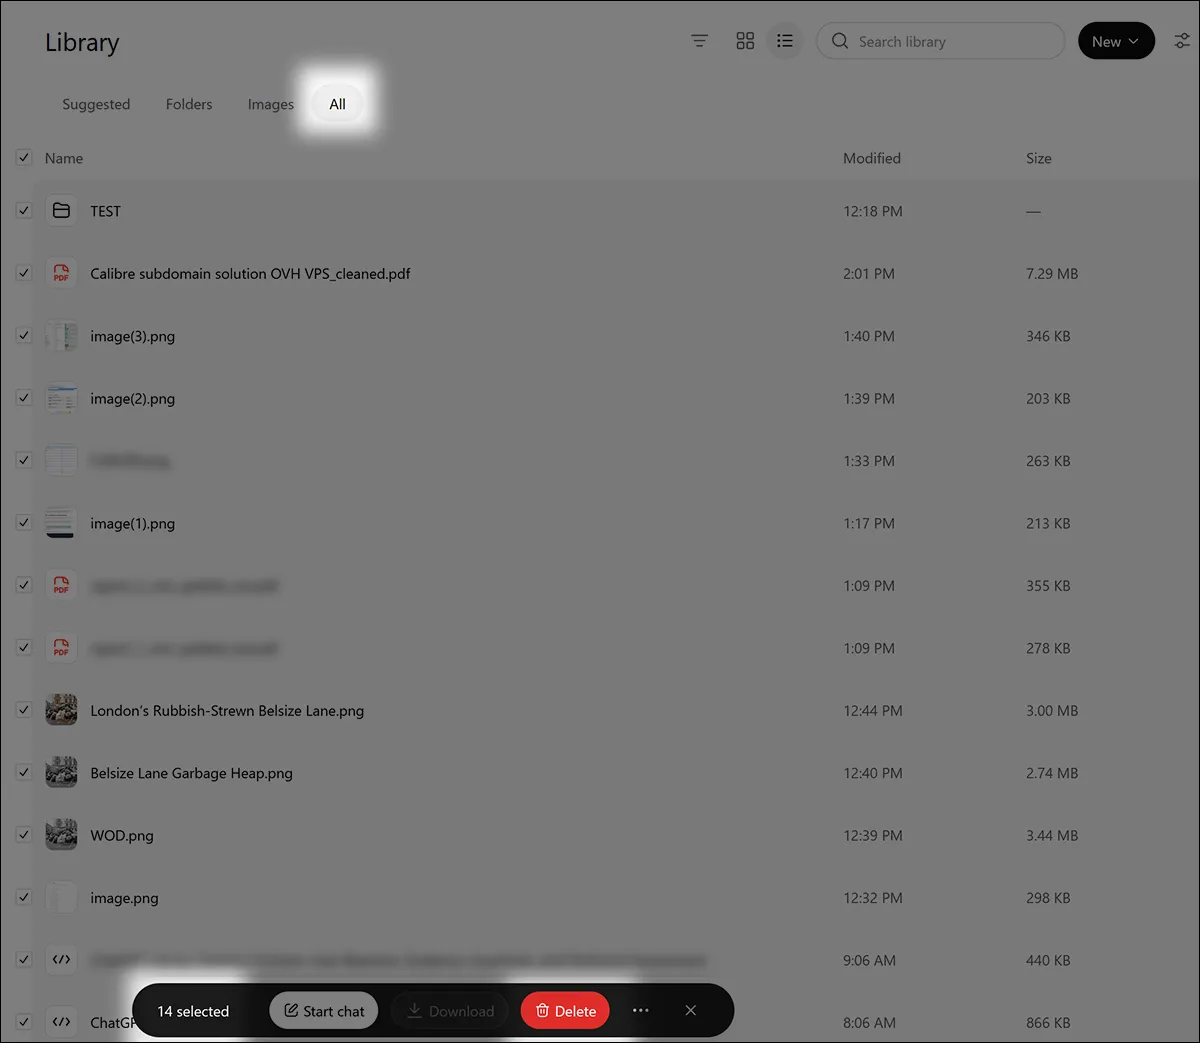
برای کاربری با ۹۰ هزار فایل، این فرآیند به اسکرول کردن بیپایان و کلیکهای مکرر نیاز دارد. کاربر باید برای مدت طولانی کلید Space را نگه دارد تا آیتمها بارگذاری شوند، اما نه آنقدر طولانی که مرورگر کرش کند یا ترتیب آیتمهای ابتدایی را از دست بدهد. این طراحی یک «الگوی تاریک» (Dark Pattern) است که کاربر را بهطور غیرمستقیم به سمت نگه داشتن دادهها سوق میدهد.
وقتی حجم دادهها بیش از حد زیاد و جریانهای کاری حذف بهشدت کند و خستهکننده میشود، تنها راه کارآمد، گزینهٔ «هستهای» است: حذف کامل حساب کاربری ChatGPT و شروع دوباره از صفر.
جایگزین «سند تحویلی»
برخی کاربران حرفهای برای فرار از این تله، از «اسناد تحویلی» (Handover Documents) استفاده میکنند. آنها بهجای تکیه بر آپلودهای خام، نامنظم و بدون پالایش — که ممکن است حاوی دادههای نامطلوب مثل رمز عبور شبکه باشد — از مدل میخواهند نتایج یک جلسه را در قالب یک فایل ساختاریافته مارکداون (.MD) خلاصه کند.
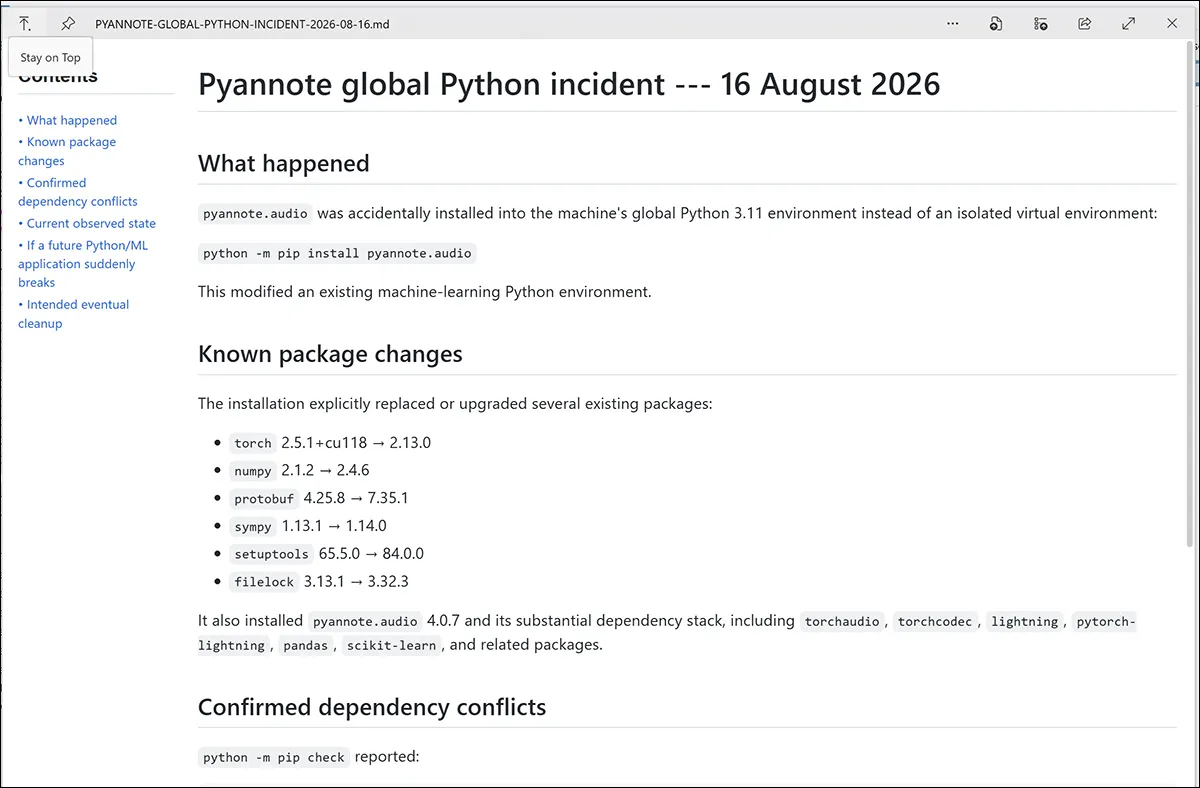
فرمت مارکداون بهدلیل سازگاری بالا با چارچوبهای هوش مصنوعی ترجیح داده میشود و اجازه میدهد جزئیات و استدلالهای بیشتری نسبت به یک سند متنی ساده ثبت شود. این روش به کاربران اجازه میدهد:
- دانش ضروری یک جلسهٔ پراکنده را در یک راهنمای منضبط و تکفایلی تلخیص کنند.
- محتوای تمام آپلودهای استفاده شده در چت را در یک digest خلاصه کرده و سپس فایلهای اصلی را با خیال راحت پاک کنند.
- یک سابقهٔ قابل انتقال و شخصی (Self-hosted) از دانش هوش مصنوعی داشته باشند که بهصورت انتخابی بهروز شود یا حذف گردد.
- کنترل کامل روی محل ذخیره و محتوای دقیق اطلاعات داشته باشند.
این پالایش بهطور خودکار در پشت صحنه انجام نمیشود. تبدیل آپلودها به راهنماهای ساختاریافته، منابع محاسباتی زیادی میطلبد و ممکن است بهعنوان «آموزش» تلقی شود که بسیاری از کاربران آن را رد میکنند. برای OpenAI ارزانتر است که در لحظهٔ استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه به خودِ آشپزی و نه دوره آموزش آشپز — متادیتای کاربر را بررسی کند تا اینکه «کوهی از آپلودهای تصادفی» را به یک پایگاه داده قابل فهم تبدیل کند.
پارادوکس هوش مصنوعی
در کمال تعجب، همان ابزاری که باعث ایجاد این مشکل شده، راه حل آن است. در حالی که رابط کاربری (GUI) حذف انبوه را تقریباً غیرممکن میکند، کاربران دریافتهاند که درخواست ساده از ChatGPT برای «حذف تمام فایلهای آپلود شده من» اغلب جواب میدهد. مدل میتواند دستورات حذفی را در لایههای پشتی (Backend) اجرا کند که در رابط کاربری پنهان یا پیچیده شدهاند.
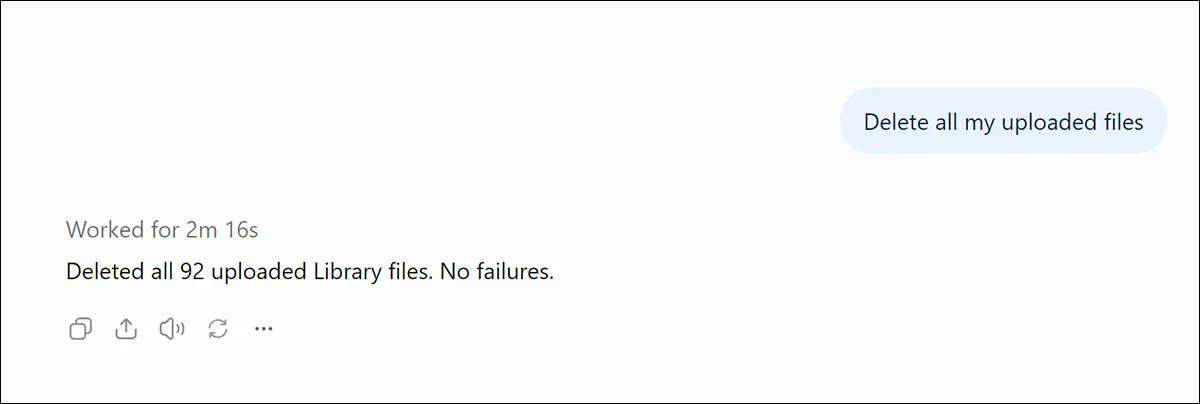
در یک آزمایش، کاربری با ۶۰۰ فایل در سه پروژه شبکه خانگی متوجه شد که ChatGPT پس از کمی تردید اولیه، تمام آپلودهای حساب او را در یک مرحله و بدون نیاز به دخالت دستی پاک کرد. این نشان میدهد قابلیتهای حذفی در لایهٔ چت وجود دارد که در رابط کاربری ظاهری کاملاً حذف شده است.
با این حال، این راه حل همواره سازگار نیست. مدل اغلب در خالی کردن سطل زباله شکست میخورد، به این معنی که بازه ۳۰ روزهٔ انتظار برای حذف نهایی همچنان اعمال میشود. علاوه بر این، تغییرات روزانه در رابط کاربری باعث میشود افزونههای کروم که برای پاکسازی کتابخانه ساخته شدهاند، بهسرعت از کار بیفتند.
منطق استراتژیک
این زیرساخت نشان میدهد OpenAI اولویت را بر «دادههای طلایی آپلود شده» گذاشته تا نرخ بازگشت کاربر را افزایش دهد و سرمایهگذاریهای تریلیون دلاری مدلهای پیشرو را جبران کند. این استراتژی مشابه Google Gemini است که در نسخههای پولی، فضای ذخیرهسازی حساب گوگل را بهطور قابل توجه افزایش میدهد تا دادههای آپلود شده کاربر را بهعنوان گروگان نگه دارد. این رویکرد بخشی از چشمانداز وسیعتر OpenAI برای تبدیل ChatGPT به یک مرکز توزیع اپلیکیشن است تا اکوسیستمی بسته و متمرکز ایجاد کند.
دلایل احتمالی این استراتژی عبارتند از:
- کاهش خسارت: ایجاد درآمد اضافی برای جبران سرمایهگذاریهای نامتقارن در مدلهای Frontier.
- حفظ کاربر: ایجاد اصطکاک در مهاجرت دادههای حجیم برای جلوگیری از تغییر ارائهدهنده (Lock-in effect).
- ارزش پیشنهادی: حل مشکل «فراموشی مدلهای زبانی» از طریق حافظه دائمی در رابطه انسان-هوش مصنوعی.
برای کاربر عادی، این یعنی «هوش» مدل شما اکنون مستقیماً به این بستگی دارد که چه مقدار از زندگی دیجیتال خود را روی سرورهای یک شرکت خصوصی رها کنید. راحتیِ داشتن یک حافظه دائمی، در حال حاضر با ارزِ «حریم خصوصی» و «کار دستی» پرداخت میشود.
باید منتظر ماند و دید آیا OpenAI گزینههایی مثل WebDav یا ذخیرهسازی شخصی (Self-hosted) را معرفی میکند یا خیر؛ چرا که این تنها راه خروج از مدل «اجارهدار» و رسیدن به حاکمیت واقعی بر دادههاست.
گام بعدی شما
- بهجای آپلود مستقیم فایلهای حجیم، از مدل بخواهید نکات کلیدی را در یک فایل Markdown خلاصه کند و سپس فایل اصلی را پاک کنید.
- برای پاکسازی سریعتر، بهجای استفاده از دکمههای رابط کاربری، مستقیماً در چت از مدل بخواهید تمام فایلهای آپلود شده را حذف کند.
- در تنظیمات حریم خصوصی، گزینه استفاده از دادهها برای آموزش را بررسی و در صورت نیاز غیرفعال کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.


گفتگو