
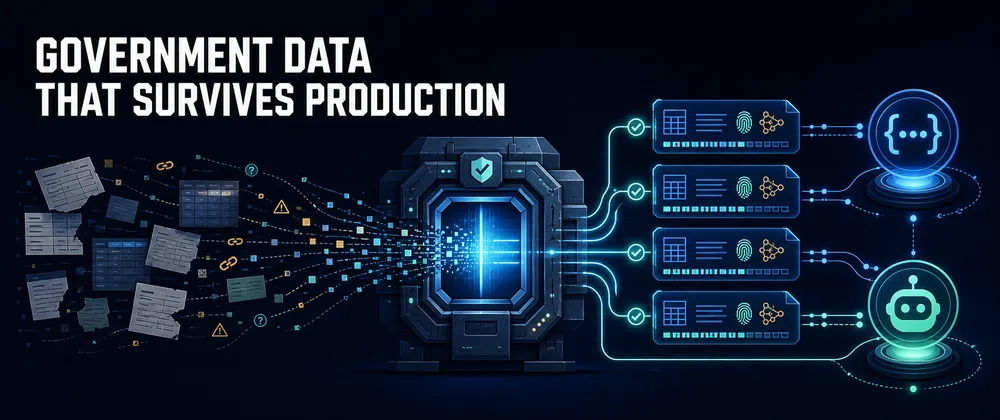
تصور کنید یک عامل هوش مصنوعی بر اساس یک پاسخ ناقص از API دولت، به اشتباه اعلام کند که یک مجوز قانونی صادر نشده است؛ این یک خطای فنی ساده نیست، بلکه یک توهم فکتمحور است. برای جلوگیری از این فاجعه، CivicDataForge در ۲۴ اوت ۲۰۲۶ معماری جدیدی را برای تبدیل دادههای باز دولتی به شواهد قابل استناد معرفی کرد. این درس سختی بود که تیم در حین ساخت یک سیستم عملیاتی برای تبدیل دادههای باز دولتی به شواهدی که توسط عاملهای هوش مصنوعی قابل فراخوانی باشد، آموخت.
بسیاری از توسعهدهندگان با APIهای دولتی مثل یک نقطه اتصال ساده JSON برخورد میکنند؛ یعنی یک URL را پیدا میکنند، دادهها را نرمالسازی میکنند و پروژه را منتشر میکنند. این روش برای یک دموی ساده جواب میدهد، اما در محیط عملیاتی شکست میخورد؛ زیرا ناشران دولتی ممکن است بدون اطلاع، یک فیلد را تغییر دهند، تعداد نتایج را محدود کنند، نقطه اتصال (Endpoint) را جابهجا کنند یا صفحهای خالی برگردانند که شبیه به «عدم وجود رکورد» به نظر برسد.
برای عاملهای هوش مصنوعی (AI Agents) — شبیه به دستیاران دیجیتالی که میتوانند بهطور مستقل ابزارها را اجرا کنند تا به هدف برسند — این شکستها فاجعهبار است. طبق گزارش تیم توسعه، یک عامل ممکن است محدودیت ۱۰۰۰ سطری یک صفحه را به عنوان کل جمعیت یک منطقه یا حوزه قضایی تفسیر کند. این اتفاق یک محدودیت فنی را به یک توهم واقعی تبدیل میکند که در تحلیلهای ما درباره تلهٔ دقتِ ساختگی و تولید نتایج غلط اما متقاعدکننده توسط عاملها به تفصیل بررسی شده است. CivicDataForge برای پاسخ به این پرسش بنیادین ساخته شد: چه چیزی باید بین یک ناشر رسمی دولتی و یک سامانه نرمافزاری — یا یک عامل هوش مصنوعی — وجود داشته باشد تا نتیجه را بتوان «شاهد» (Evidence) نامید؟
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، اعتماد به خروجیهای خام بدون لایه اعتبارسنجی، بزرگترین ریسک در سیستمهای عاملمحور است.
حل تلهٔ صفحهبندی
پلتفرمهای دولتی مانند ArcGIS و Socrata اغلب سقف تعداد رکوردها را اعمال میکنند. یک پاسخ میتواند JSON معتبری باشد و وضعیت HTTP 200 (موفق) داشته باشد، اما در واقع فقط صفحه اول را نشان دهد. برای مثال، سرویسهای ArcGIS از کنترلهایی مثل resultOffset و resultRecordCount استفاده میکنند و ممکن است سیگنال دهند که حد انتقال دادهها (Transfer Limit) رد شده است. مجموعهدادههای Socrata نیز به طور مشابه از کنترلهای صفحهبندی و پرسوجو استفاده میکنند.
به نقل از مستندات CivicDataForge، اگر جمعکننده دادهها این قراردادها را نادیده بگیرد، عبارت «منبع ۱۰۰۰ سطر برگرداند» بهطور خاموش به «این منطقه ۱۰۰۰ رکورد دارد» تبدیل میشود. این دو گزاره اصلاً یکسان نیستند. برای حل این مشکل، این پلتفرم قوانین سختگیرانهای را برای جمعآوری دادهها اجرا کرد:
- شناسایی سقف صفحات (Page Limit) ناشر.
- درخواست تمام صفحات با یک ترتیب پایدار.
- ردیابی تعداد صفحات، تعداد رکوردهای مشاهدهشده و مجموع گزارششده توسط منبع (در صورت موجود بودن).
- رد کردن خط مبنا (Baseline) در صورتی که پرسوجوی انتخابشده محدود (Capped)، ناقص یا از نظر ساختاری ناسازگار باشد.
- بستهبندی محدوده تکمیلشده در یک رسید (Receipt).
این مرحله آخر، حیاتیترین تصمیم محصول است. در حالی که یک صفحه ناقص برای اکتشاف و جستوجوی اولیه مفید است، اما نمیتواند ثابت کند که یک رکورد بین دو اجرای سیستم حذف شده است.
عبور از حقیقتِ صفر و یکی
یکی از خطرناکترین الگوها در هوش مصنوعی مدنی، بازگرداندن پاسخهای Boolean (بله/خیر) مانند «غیرقانونی» یا «مجاز نیست» (NOT_PERMITTED / ILLEGAL) در زمان عدم یافتن رکورد در جستوجوی آدرس است. این اغلب یک منفی کاذب است. ممکن است ناشر تمام رژیمهای قانونی را پوشش ندهد، آدرس به شکل متفاوتی فرمت شده باشد، یک مجوز محلی در سیستم دیگری وجود داشته باشد یا منبع دادهها صرفاً قدیمی باشد.
CivicDataForge نتایج دوتایی را با یک واژگان تصمیمگیری «بسته-در-صورت-شک» (Fail-closed) جایگزین کرد:
- EVIDENCE_FOUND (شاهد یافت شد)
- NO_PUBLISHED_MATCH (تطابق منتشرشدهای یافت نشد)
- REVIEW_REQUIRED (بازبینی لازم است)
- SOURCE_UNAVAILABLE (منبع در دسترس نیست)
- SCOPE_INCOMPLETE (محدوده ناقص است)
این واژگان عمداً کمتر از «بله/خیر» قاطع و دراماتیک هستند. یک API نباید به دلیل اینکه مصرفکننده یک پاسخ Boolean میخواهد، یقین ساختگی تولید کند. این رویکرد با مفهوم کفایت شواهد در برابر روانی متن همسو است که در آن سیستمهای بازیابی باید اجازه داشته باشند در صورت نبود شاهد، عدم قطعیت را اعلام کنند. اگر یک جریان کاری در مراحل پاییندست به پاسخ بله/خیر نیاز دارد، مشتری باید مالک سیاستی باشد که این وضعیتهای شاهد را به یک اقدام (Action) نگاشت میکند و باید وضعیت اصلی را برای بازبینی حفظ کند.
حفظ اصالت از طریق نرمالسازی
نرمالسازی (Normalization) — شبیه به تبدیل تمام تاریخها به یک فرمت واحد برای اینکه سیستم گیج نشود — برای اینکه عاملهای هوش مصنوعی بتوانند دادهها را پردازش کنند ضروری است، اما دقیقاً همینجاست که شواهد میتوانند هویت خود را از دست بدهند. برای جلوگیری از این اتفاق، تیم از یک «پاکت شاهد» (Evidence Envelope) استفاده میکند که مقدار نرمالشده را به تبار (Lineage) آن گره میزند. این کار تضمین میکند که سیستم بتواند پاسخ دهد کدام مقام رکورد را منتشر کرده، از کدام نقطه اتصال یا فایل آمده و چه پرسوجویی آن را تولید کرده است.
جزئیات پاکت شاهد
یک پاکت شاهد حداقلی شامل دادههای ساختاریافته زیر است:
- منبع (Source): مقام صادرکننده، URL رسمی (مثلاً
https://official.example/dataset) و برچسب زمانی بازیابی (retrieved_at). - محدوده (Scope): پرسوجوی محدودشده منبع و یک پرچم Boolean به نام
complete. - رکورد (Record): شناسه متعلق به ناشر (
source_id)، یک شناسه نرمالشده (normalized_identifier) و هش رکورد (sha256). - تصمیم (Decision): وضعیت (مثلاً
EVIDENCE_FOUND) و هش رسید (sha256).
با اثر انگشت گذاری روی رکورد و تصمیم، سیستم تضمین میکند که نتیجه نرمالشده، مسیر بازگشت به رکورد رسمی را قطع نکند.
پایش سلامت در برابر تازگی
در دسترس بودن به معنای دقت نیست. یک منبع میتواند در دسترس باشد اما دادههایش قدیمی باشد، یا طرحوارهای (Schema) پایدار داشته باشد اما دادههای ناقص برگرداند. همچنین ممکن است فایلی جدید منتشر کند که تاریخهای داخلی آن قدیمی باشد، یا بدون اینکه درخواست را با خطا مواجه کند، طرحواره را تغییر دهد.
CivicDataForge این موارد را در ابعاد مستقل پایش میکند:
- در دسترس بودن (Availability): آیا نقطه اتصال پاسخ میدهد؟
- سازگاری طرحواره (Schema Compatibility): آیا ساختار داده تغییر کرده است؟
- رفتار تعداد رکوردها (Record-count Behavior): آیا افت یا محدودیتهای غیرمنتظرهای مشاهده میکنیم؟
- یکپارچگی تاریخ منبع (Source Date Integrity): آیا تاریخ داخلی رکوردها با تاریخ انتشار همخوانی دارد؟
- تازگی (Freshness): زمانی که ناشر یک سیگنال قابل دفاع از تازگی ارائه دهد.
- اثر انگشت محتوا (Content Fingerprint): آیا محتوا بدون تغییر URL تغییر کرده است؟
- سازگاری قرارداد (Contract Compatibility): آیا پاسخ هنوز با مشخصات توافقشده مطابقت دارد؟
وقتی تازگی قابل اندازهگیری نباشد، سیستم صراحتاً آن را freshness_not_measured علامت میزند. این کار مانع از آن میشود که یک پایشگر عملیاتی، یک خط مبنای شناختهشده را صرفاً به دلیل دریافت پاسخ 200 OK، با یک پاسخ خالی یا آسیبدیده جایگزین کند.
پایش تغییرات قابل اعتماد
وبهوکها (Webhooks) اغلب به عنوان خودِ شاهد در نظر گرفته میشوند، اما آنها صرفاً اعلان هستند. پرسشهای دشوارتر این است که آیا اسنپشاتهای قبلی و جدید کامل بودهاند، یا اینکه جمعکننده دادهها شکست خورده است (نه اینکه منبع تغییر کرده باشد).
برای تضمین قابلیت اطمینان، تیم از یک کلید Idempotency استفاده میکند که ترکیب ID اجرای عامل و نوع رویداد است: idempotency_key = actor_run_id + ":" + event_type.
با پیروی از رفتار وبهوکهای Apify که تحویلهای شکستخورده را مجدداً تلاش میکنند، مصرفکنندگان باید Idempotent باشند. هندلر downstream باید وبهوک را سریعاً تایید کرده و کارهای سنگین در صف قرار دهد. در نهایت، مجموعهدادههای بادوام، هشهای رکورد، محدوده و رسید تصمیم، تنها منبع حقیقت قابل بازرسی باقی میمانند.
قرارداد انتخاب ابزار برای عاملهای هوش مصنوعی
صرفاً منتشر کردن یک سرور پروتکل زمینهٔ مدل (MCP) — شبیه به ایجاد یک دفترچه راهنما برای مدل تا بداند چه ابزارهایی در دسترس است — ابزار را ایمن نمیکند. عاملها باید مرزهای آنچه یک ابزار میتواند یا نمیتواند ثابت کند را بدانند. مشخصات MCP برای سرورهای راه دور، Streamable HTTP را توصیه میکند، اما انتقال دادهها تنها اولین قدم است.
CivicDataForge از قراردادهای «وظیفه-به-ابزار» (Task-to-tool) استفاده میکند تا عامل را هدایت کند. برای مثال، قراردادی برای تایید شواهد شرکتهای هند مشخص میکند:
- وظیفه: تایید شواهد شرکت هند
- شناسه ترجیحی: شماره شناسایی شرکتی (CIN)
- ورودی حداقل: CIN دقیق ترجیح میشود
- مرز: شواهد پژوهشی، نه تاییدیه خودکار KYC یا بررسی صلاحیت
این کار مانع از آن میشود که عامل از یک ابزار پژوهشی برای یک وظیفه حساس حقوقی با ریسک بالا استفاده کند. این لایه از کنترل دسترسی یادآور مکانیزمهای GuardRail در برابر فیلترهای متنی است که برای جلوگیری از اقدامات غیرمجاز عاملها در محیطهای عملیاتی به کار میرود.
از اسکرپر تا لایهٔ شاهد
این پروژه از یک اسکرپر ساده به یک معماری ششسرویس تبدیل شده است:
۱. بررسی امکانسنجی و حقوق منبع: تعیین اینکه آیا دادهها را میتوان به صورت قانونی و فنی استفاده کرد.
۲. نرمالسازی و نگاشت هویت: ایجاد شناسههای پایدار از دادههای نامنظم منبع.
۳. پایش سلامت منبع و تغییرات: ردیابی ابعاد مستقل سلامت و تازگی.
۴. تحویل و یکپارچهسازی شواهد: مدیریت مسیر رسیدن داده به مصرفکننده.
۵. پاکتهای شاهد و مسیرهای اصلاحی: اجازه دادن به انسانها برای اصلاح تطبیقهای مبهم.
۶. یکپارچهسازی ابزارهای عامل هوش مصنوعی: ارائه نقاط اتصال MCP و قراردادهای انتخاب.
این تغییر یعنی یک منبع تنها پس از عبور از تست تکمیل، قرارداد نرمالسازی، پروبهای سلامت و یک قرارداد تصمیم محدود، وارد محیط عملیاتی میشود. یک کانکتور صرفاً چون تصور شده است «در دسترس» نیست؛ بلکه باید از یک تست پذیرش از طریق APIهای عمومی، مجموعهدادهها، زمانبندیها، وبهوکها یا نقطه اتصال راه دور MCP عبور کند.
ماموریت و فراخوان برای ورودیهای خصمانه
هدف CivicDataForge کاهش ساعتهای تلفشده بین «دولت این را جایی منتشر کرده» و «یک شخص یا سیستم میتواند بدون پیشفرضهای غلط از آن استفاده کند» است. هدف این است که کیفیت منبع و عدم قطعیت را مرئی کنیم تا توسعهدهندگان مجبور نباشند بین اسکریپتهای شکننده و فروشندگان غیرشفاف یکی را انتخاب کنند.
برای تقویت این قراردادها، تیم اکنون به دنبال ورودیهای خصمانه (Adversarial Input) از جامعه توسعهدهندگان است تا حالتهای شکست خاص را شناسایی کند. آنها به دنبال پاسخ برای این موارد هستند:
- کدام منبع دولتی امروز جریان کاری شما را مختل میکند؟
- کدام شناسه حاضر نیست به طور تمیز تطبیق داده شود؟
- کدام ناشر بهطور خاموش نتایج را محدود یا بازطراحی میکند؟
- کدام وضعیت شاهد در API فعلی شما به یک Boolean گمراهکننده تبدیل میشود؟
درسهای آموختهشده
اگر تیم دوباره شروع میکرد، سه تصمیم را زودتر میگرفت: تعریف وضعیتهای شکست و عدم قطعیت پیش از طرحواره مسیر موفق (Happy-path)، اثبات جمعآوری کامل پیش از ساخت پایش تغییرات، و انتشار متادیتای انتخاب وظیفه در کنار هر ابزار عامل.
کدی که سطرها را میگیرد، کوچکترین بخش سیستم است. کار دشوار و قابل دفاع، حفظ حقیقتِ یک گزاره متصل به منبع پس از صفحهبندی، نرمالسازی، تلاشهای مجدد، تغییرات منبع و اتوماسیون پاییندست است.
برای توسعهدهندگان، این بدان معنای آن است که طرحواره «مسیر موفق» کماهمیتترین بخش سیستم است. کار واقعی در تعریف وضعیتهای شکست و عدم قطعیت پیش از دریافت اولین سطر نهفته است. اگر در حال ساخت ابزارهایی هستید که به سوابق عمومی متکی هستند، گام بعدی شما بازرسی APIهایتان برای «محدودیتهای خاموش» (Silent Caps) است؛ جایی که یک پاسخ 200 OK در واقع یک مجموعهداده ناقص را پنهان میکند.
گام بعدی شما
- APIهای خود را برای «محدودیتهای خاموش» (Silent Caps) بازرسی کنید تا مطمئن شوید پاسخ 200 OK لزوماً به معنای دریافت کل دادهها نیست.
- در طراحی ابزارهای عاملمحور، به جای پاسخهای Boolean، از واژگان وضعیت (Status Vocabulary) برای بیان عدم قطعیت استفاده کنید.
- برای هر ابزاری که به عامل ارائه میدهید، یک قرارداد مرزی (Boundary Contract) بنویسید تا کاربرد ابزار در وظایف حساس محدود شود.
اما چالشهای مربوط به استقرار این لایهها در مقیاس میلیونی حتی پیچیدهتر است — به تحلیل ما دربارهی بهینهسازی هزینه استنتاج در سیستمهای توزیعشده مراجعه کنید.



گفتگو