تصور کنید یک برنامهنویس هستید که برای عامل هوش مصنوعی خود ۴۰ مهارت سفارشی تعریف کرده و توصیفات دقیقی به زبان ژاپنی نوشته تا مدل بداند هر ابزار را چه زمانی به کار ببرد. شما تستهای محلی خود را بررسی میکنید و همه چیز عالی به نظر میرسد. اما در محیط عملیاتی، عامل شما ناگهان ابزارهای حیاتی را «فراموش» میکند چون توصیفات آنها توسط سیستم حذف شده است و مدل دیگر نمیداند آنها چه کاربردی دارند.
این اتفاق به دلیل یک مکانیزم پنهان در Claude Code رخ میدهد که نویسههای پهن (Full-width) در زبانهای شرق آسیا (ژاپنی، چینی یا کرهای) را بهطور بیصدا حذف میکند. در حالی که مستندات رسمی بودجهای بر اساس درصد پنجرهٔ زمینه را پیشنهاد میدهند، اندازهگیریهای واقعی نشان میدهد که نویسههای پهن با یک ضریب ۲ جریمه میشوند.
این کشف در حالی صورت میگیرد که توسعهدهندگان بهطور فزایندهای به مهارتهای سفارشی برای گسترش قابلیتهای عاملهای هوش مصنوعی متکی هستند. همانطور که در تحلیل قبلی ما دربارهی نحوهٔ دسترسی Claude Code به بکاندها بدون تغییر در کد اشاره کردیم، تمرکز اکنون از قابلیت دسترسی به قابلیت اطمینان در انتخاب ابزارها در طول یک جلسه تغییر کرده است. این موضوع یعنی استنتاج (Inference) — که شبیه به لحظهٔ خودِ آشپزی است، نه دورهی آموزش آشپز — در اینجا تحت تأثیر یک سیستم شمارش قدیمی قرار گرفته است.
اشتباه در محاسبه بودجه
به نقل از گزارشی مفصل در dev.to که در ۱۶ اکتبر ۲۰۲۶ منتشر شد، تیمی از توسعهدهندگان متوجه شدند تستهای داخلی آنها پاس میشود اما عامل در محیط واقعی با بنبست مواجه است. تستهای آنها سقف توصیفات مهارتها را روی ۱۰,۰۰۰ نویسه محدود کرده بود، اما محیط واقعی بسیار شلوغتر از این حد بود.
طبق این گزارش، جزئیات بودجه به شرح زیر است:
- بودجه رسمی برای یک پنجرهٔ ۱ میلیون توکنی، ۱٪ از آن پنجره است که به ۳۰,۰۰۰ نویسه ترجمه میشود.
- قانون داخلی تیم (۱۰,۰۰۰ نویسه) در ابتدا امن به نظر میرسید، اما این عدد فقط مهارتهای مربوط به پروژه خودشان را میسنجید.
- لیست نهایی که مدل میبیند شامل پلاگینها، مهارتهای سطح حساب کاربری و ابزارهای داخلی خودِ Claude Code است.
در یک جلسه در ۱۲ اکتبر ۲۰۲۶، مجموع لیست به ۲۶,۷۹۱ نویسه رسید. اما با اعمال «شمارش دوبرابر» برای نویسههای ژاپنی، این عدد به ۲۸,۱۱۹ رسید و تنها ۱,۸۸۱ واحد فضا تا لحظهٔ شروع حذف توصیفات توسط سیستم باقی ماند. این بدان معناست که لیست ۹۴٪ پر شده بود، در حالی که تستهای داخلی تیم ادعا میکردند ۷,۶۹۶ نویسه فضای خالی (Headroom) وجود دارد.
قوانین داخلی و گیتهای کامیت
برای جلوگیری از سرریز بودجه، تیم قانونی را در .claude/rules/claude-md.md تعریف کرد. این قانون به زبان ژاپنی تصریح میکرد که مجموع تمام توصیفات مهارتها باید زیر ۱۰,۰۰۰ نویسه بماند. منطق آنها بر این باور استوار بود که بودجهٔ لیست، ۱٪ از پنجرهٔ زمینه (Context Window) — که مثل میز کاری است که جا برای چند ورق دارد، نه کل کتابخانه — است. از آنجایی که جلسه اصلی و زیر-عاملهای (Subagents) آنها با پنجره ۱ میلیون توکنی اجرا میشدند، فرض کردند ۱۰,۰۰۰ نویسه محدودیتی امن است.
این قانون از طریق یک گیت کامیت در src/quality/gates/claude-md-structure.ts اجرا میشد که از مسیر test/ops/claude-md-structure.test.ts فراخوانی میشد. این تست از سه ثابت استفاده میکرد:
SKILL_DESCRIPTION_TOTAL_MAX_CHARS = 10_000SKILL_DESCRIPTION_MAX_CHARS = 1_536SKILL_DESCRIPTION_MIN_CHARS = 40
تست مذکور، مجموع را از طریق جمع کردن طول خط description در بخش frontmatter هر فایل SKILL.md در مسیر .claude/skills محاسبه میکرد. برای این کار از تابعی به نام sumSkillDescriptionChars استفاده میشد که لیست دایرکتوریهای مهارت را کاهش داده و مقدار .length هر توصیف را اضافه میکرد. این تابع از ویژگی .length در جاوااسکریپت استفاده میکرد که واحدهای کد UTF-16 را میشمارد؛ به این معنی که هر نویسه ژاپنی برابر با یک واحد شمرده میشد، در حالی که سیستم داخلی Claude Code طور دیگری عمل میکرد. این چالش در سازماندهی مهارتها یادآور تجربهای است که در پروژه headcount برای مدیریت ۱۷۲ مهارت هوش مصنوعی مشاهده شد، جایی که ساختاردهی درست به ابزارها برای جلوگیری از سردرگمی مدل حیاتی است.
تاریخچه مفروضات
تاریخچه گیت نشان میدهد این محدودیتها چگونه تکامل یافتند. بررسیها ابتدا در ۷ سپتامبر ۲۰۲۶ در کامیت bbf0dc95 و در پی نظر یکی از خوانندگان معرفی شد. در ابتدا، سقف تنها ۲,۰۰۰ نویسه بود که بر اساس پنجرهٔ ۲۰۰ هزار توکنی تنظیم شده بود. در آن زمان، مجموع ۹ مهارت ۱,۸۸۵ نویسه بود. تا روز بعد، اضافه شدن دهمین مهارت مجموع را به ۱,۹۹۰ رساند و تقریباً به سقف برخورد کرد.
در ۲۷ سپتامبر ۲۰۲۶، در کامیت 567a49c7 و پس از تأیید مالک پروژه، سقف به ۱۰,۰۰۰ نویسه افزایش یافت، زیرا اشاره شد که اکنون همه چیز روی پنجرههای ۱ میلیون توکنی اجرا میشود. پس از ادغام (Merge) و حذف یک مهارت، مجموع ثبت شده به ۱,۶۹۲ نویسه برای ۸ مهارت (بین ۱۴۵ تا ۲۹۳ نویسه برای هر کدام) کاهش یافت. حتی با احتساب یک مهارت نهم که بهطور محلی نادیده گرفته شده بود و ۶۱۲ نویسه داشت، مجموع تنها ۲,۳۰۴ بود که بسیار کمتر از حد ۱۰,۰۰۰ بود.
تضاد با مستندات رسمی
در ۱۳ اکتبر ۲۰۲۶ در ساعت ۱۹:۱۱ UTC، تیم قوانین خود را با صفحه رسمی مهارتها و مرجع تنظیمات مقایسه کرد. در حالی که مستندات و قوانین داخلی بر سر بودجه ۱٪ و سقف ۱,۵۳۶ نویسه برای هر ورودی توافق داشتند، سه تفاوت حیاتی ظاهر شد:
۱. ناهماهنگی واحدها: مستندات بودجه را ۱٪ از پنجرهٔ زمینه (توکن) تعریف میکنند، اما خود بودجه با نویسه (Character) سنجیده میشود. تیم بهاشتباه فرض کرده بود ۱٪ از ۱ میلیون توکن برابر با ۱۰,۰۰۰ نویسه است.
۲. دامنه سقف: سقف ۱,۵۳۶ نویسه برای مجموع description و when_to_use اعمال میشود. اما تست تیم فقط فیلد description را بررسی میکرد. بنابراین هر مهارتی که بخش when_to_use اضافه میکرد، از این بررسی داخلی عبور میکرد.
۳. پیامد سرریز: قانون داخلی ادعا میکرد که حذف توصیفات باعث میشود مهارت اجرا نشود. اما مستندات تصریح میکنند که نام مهارت باقی میماند و ابزار همچنان قابل فراخوانی است، اما مدل صرفاً «احتمال کمتری» دارد که آن را بهطور خودکار انتخاب کند.
اثبات جریمه نویسههای ژاپنی
پژوهشگران برای اثبات این مکانیزم، آزمایشگاهی با Claude Code 2.1.296 و مدل Claude-Opus-5.5 ساختند. آنها دستور claude -p "Reply with the single word OK." --output-format json --model opus --setting-sources project --max-turns 1 را با لاگ دیباگ اجرا کردند. آنها ۴۰ مهارت با توصیفات ۱,۰۰۰ نویسهای را در دو نسخه انگلیسی و ژاپنی مقایسه کردند.
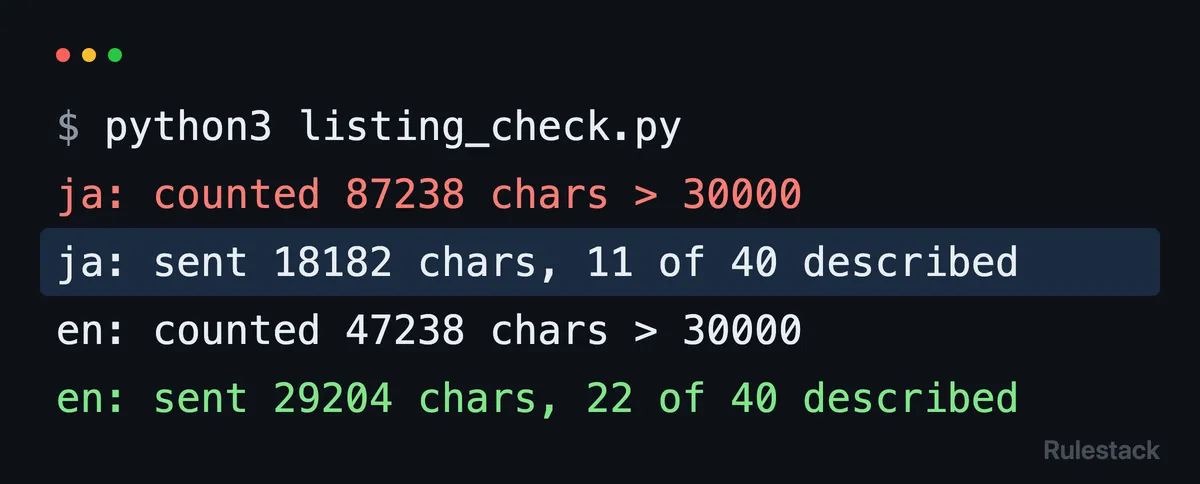
نتایج تکاندهنده بود. مجموعه انگلیسی ۴۷,۲۳۸ نویسه و مجموعه ژاپنی ۸۷,۲۳۸ نویسه شمرده شد. این تأیید میکند که Claude Code هر نویسه ژاپنی را دو واحد میبیند؛ دقیقاً مشابه روشی که ترمینالها عرض نمایش نویسههای پهن را محاسبه میکنند. لاگهای دیباگ صراحتاً هشدار میدادند: [WARN] Skill listing over budget: 54 skills, … chars > 30000 budget (که عدد ۵۴ شامل ۴۰ مهارت سفارشی و ۱۴ مهارت داخلی بود).
این بدان معناست که یک توصیف ژاپنی، نیمی از تعداد مهارتهای یک توصیف انگلیسی را در بودجه جای میدهد. در آزمایشگاه، لیست انگلیسی ۲۲ مورد از ۴۰ توصیف (۲۹,۲۰۴ نویسه) را نگه داشت، اما لیست ژاپنی تنها ۱۱ مورد از ۴۰ مورد را حمل کرد (۱۸,۱۸۲ نویسه که در صورت دوبرابر شدن برابر با ۲۹,۱۸۲ میشود). وقتی بودجه سرریز شود، سیستم حذف توصیفات را از کمکاربردترین ابزارها آغاز میکند. به محض حذف توصیف، احتمال انتخاب خودکار آن مهارت توسط مدل بهشدت کاهش مییابد.
ترکیب واقعی لیست مهارتها
تیم دریافت که تستهای آنها فقط بخش کوچکی از بودجه کل را میسنجید. در یک جلسه در ۱۲ اکتبر ۲۰۲۶ (با نسخه Claude Code 2.1.286)، پیوست skill_listing محیط شلوغی را نشان داد:
- مهارتهای پروژه: ۹ مورد (۲,۴۸۴ نویسه؛ ۳,۷۰۲ واحد دوبرابر شده)
- مهارتهای Anthropic: ۱۳ مورد شامل کنترل مرورگر، تحقیق و اسناد (۹,۵۰۲ واحد دوبرابر شده)
- مهارتهای داخلی/حساب: ۱۸ مورد (۸,۰۹۴ واحد دوبرابر شده)
- پلاگین حافظه: ۲۱ مهارت (۶,۳۴۳ واحد دوبرابر شده)
- سایر پلاگینها: ۳ پلاگین کوچک (۴۷۸ واحد دوبرابر شده)
در مجموع ۶۴ ورودی، لیست تقریباً به حد ۳۰,۰۰۰ واحدی خود رسیده بود. تست داخلی تیم که فقط ۲,۳۰۴ نویسه از پروژه خودشان را میدید، نسبت به این واقعیت کور بود که سایر پلاگینها پیش از آن، بخش اعظم بودجه را مصرف کردهاند. این پیچیدگی در مدیریت فایلهای مهارت، اهمیت بهینهسازی نحوه ذخیرهسازی اسناد را دوچندان میکند تا دقت مدل در بازیابی اطلاعات افزایش یابد.
هزینه توکن در برابر بودجه نویسه
یک شکاف دیگر بین بودجه نویسه و هزینه واقعی توکنسازی (Tokenization) — که شبیه بریدن یک کیک طولانی به تکههای کوچک برای خوردن مدل است — وجود دارد. تیم از /skill-doctor برای تخمین هزینه زمینه مهارتهایشان استفاده کرد، اما دریافت که تخمینهای این ابزار برای متون غیرانگلیسی بهشدت نادرست است.
بین ۹ سپتامبر و ۱۲ اکتبر ۲۰۲۶، تیم هر هفته /skill-doctor را اجرا کرد و نتایج را در state/skill-doctor-reports.jsonl ثبت نمود. آنها پنج گزارش از نسخههای 2.1.277 تا 2.1.296 را تحلیل کردند. آنها دریافتند که /skill-doctor ستون مربوط به هر مهارت را با گرفتن تعداد نویسهها (- name: description) و تقسیم آن بر ۳ و رند کردن به نزدیکترین دهگان محاسبه میکند. این فرمول کاملاً نادیده میگیرد که زبانهای مختلف چگونه توکنسازی میشوند.
تحلیل دقیق /skill-doctor
- بازه زمانی گزارشها: گزارشها در تاریخهای ۹ سپتامبر، ۲۱ سپتامبر، ۳۰ سپتامبر، ۵ اکتبر و ۱۲ اکتبر تولید شدند.
- مجموع لیستها: تخمینهای کل توکن به ترتیب ۳,۰۶۰، ۳,۲۱۰، ۳,۱۶۰، ۳,۲۷۰ و ۳,۲۷۰ توکن برای ۴۰، ۴۰، ۳۵، ۳۶ و ۳۶ ردیف بود.
- سهم پروژه: ردیفهای پروژه به ترتیب ۷۲۰، ۶۶۰، ۸۲۰، ۸۲۰ و ۸۲۰ توکن را به خود اختصاص دادند.
- رشد پلاگینها: پلاگین حافظه در این بازه از ۱,۷۸۰ به ۲,۲۳۰ توکن رشد کرد.
- روندهای فراخوانی: با تکامل کار، میزان استفاده تغییر کرد. مهارت
replyاز ۱۶ به ۵۴ فراخوانی، مهارتreachاز ۲۰ به ۵۴، مهارتweeklyاز ۱ به ۳۰ و مهارتsubagent-rulesاز ۰ به ۴ فراخوانی رسید. - نوسان توکنها: ستون توکنهای هفتروزه برای رتبهبندی بیش از حد ناپایدار بود. برای مهارت
weeklyمقادیر به ترتیب: خالی، خالی، ۳۴۴.۱ میلیون، ۱.۲ میلیارد و ۲۴۵.۹ میلیون بود.
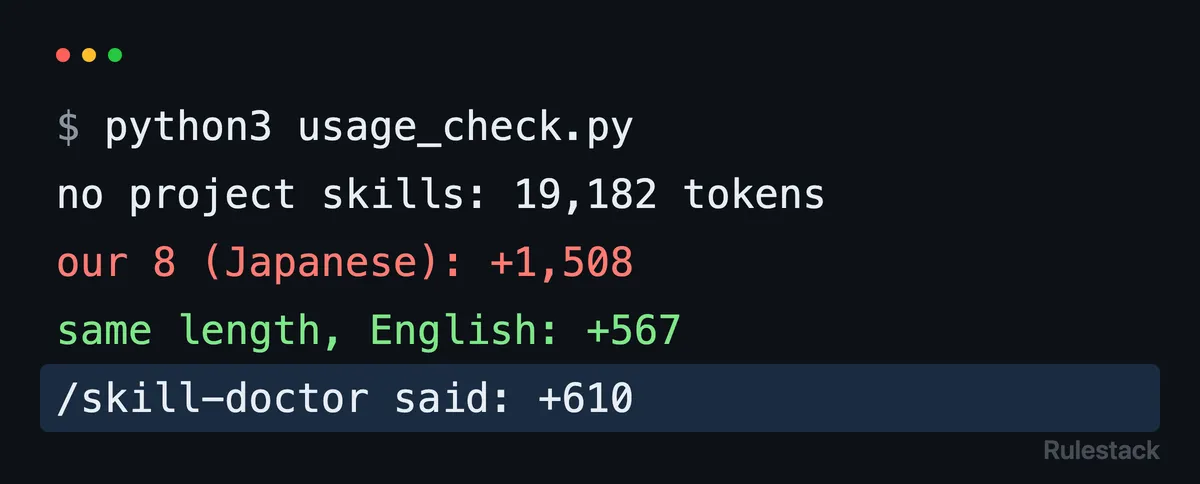
یافتههای آنها نشان داد که ۸ توصیف ژاپنی، ۱,۵۰۸ توکن به درخواست اضافه کردند. در مقابل، یک نمونه کنترل انگلیسی با همان تعداد نویسه، تنها ۵۶۷ توکن مصرف کرد. ابزار /skill-doctor هزینه را ۶۱۰ توکن تخمین زده بود؛ یعنی هزینه واقعی متن ژاپنی را ۲.۵ برابر کمتر از واقعیت برآورد کرده بود.
سقف هر ورودی
جالب است که سقف ۱,۵۳۶ نویسه برای هر ورودی، متفاوت از بودجه کل عمل میکند. وقتی تیم یک توصیف ژاپنی ۱۹۹۷ نویسهای را که به یک نشانگر (Marker) ختم میشد تست کرد، متوجه شد که توصیف به صورت ۱۵۳۵ نویسه اول و سپس یک علامت سه نقطه (...) به مدل میرسد که در مجموع ۱۵۳۶ نویسه میشود. نشانگر انتهایی کاملاً حذف شده بود.
بر اساس شمارش دوبرابر، آن ورودی ۳,۰۷۱ واحد بود. این نشان میدهد در حالی که بودجه کل از شمارش عرض دوبرابر استفاده میکند، سقف تکورودی از شمارش استاندارد نویسهها استفاده میکند. این تناقض لایه دیگری از پیچیدگی را برای توسعهدهندگانی که سعی در بهینهسازی کتابخانه مهارتهای خود دارند، ایجاد میکند.
تحلیل: هزینه بومیسازی
این یافتهها شکافی حیاتی در نحوه مدیریت بینالمللیسازی (i18n) در ابزارهای عاملهای هوش مصنوعی را آشکار میکند. Anthropic با استفاده از منطق «عرض نمایش» برای یک بودجه مبتنی بر توکن، بهطور ناخواسته نوعی «مالیات» بر توسعهدهندگان غیرانگلیسیزبان ایجاد کرده است.
برای یک توسعهدهنده عملی، این بدان معناست که حاشیه امن در کد شما یک توهم است. اگر از تعداد زیادی پلاگین استفاده میکنید یا به زبانهای CJK مینویسید، استقلال عامل شما شکننده است. شما فقط با پنجره زمینه نمیجنگید، بلکه با یک سیستم شمارش قدیمی به سبک ترمینالها در حال مبارزه هستید.
این موضوع معیار قابلیت اطمینان عامل را تغییر میدهد. دیگر دانستن تعداد توکنها کافی نیست؛ شما باید دقیقاً بدانید ارکستراتور چگونه نویسهها را میشمارد پیش از آنکه تصمیم بگیرد مجموعه ابزارهای شما را هرس کند. تیم اشاره کرد که اگرچه شمارش دوبرابر به هزینه واقعی توکنهای ژاپنی نزدیکتر است تا شمارش تکواحدی، اما باز هم باعث نمیشود ژاپنی از نظر مصرف بودجه «رایگان» شود.
اگر کتابخانه بزرگی از مهارتها را به زبان ژاپنی، چینی یا کرهای مدیریت میکنید، باید فوراً پیوستهای skill_listing را در ترنسکریپت جلسات خود بررسی کنید. بررسی کنید چه تعداد از ورودیها توصیفات خود را از دست دادهاند و تأیید کنید که آیا شمارش نویسههای شما دوبرابر میشود یا خیر.
گام بعدی شما
- اگر از زبانهای CJK (چینی، ژاپنی، کرهای) استفاده میکنید، فوراً پیوستهای
skill_listingرا در ترنسکریپت جلسات خود بررسی کنید. - تعداد مهارتهایی که توصیفاتشان حذف شده را شناسایی کرده و بودجه را بر اساس ضریب ۲ بازبینی کنید.
- برای ابزارهای حیاتی، توصیفات را کوتاهتر کنید تا در اولویت حذف قرار نگیرند.
اما داستان هزینه توکنها در زبانهای غیرانگلیسی حتی پیچیدهتر است — به تحلیل ما درباره تفاوتهای توکنسازی در مدلهای مختلف مراجعه کنید.



گفتگو