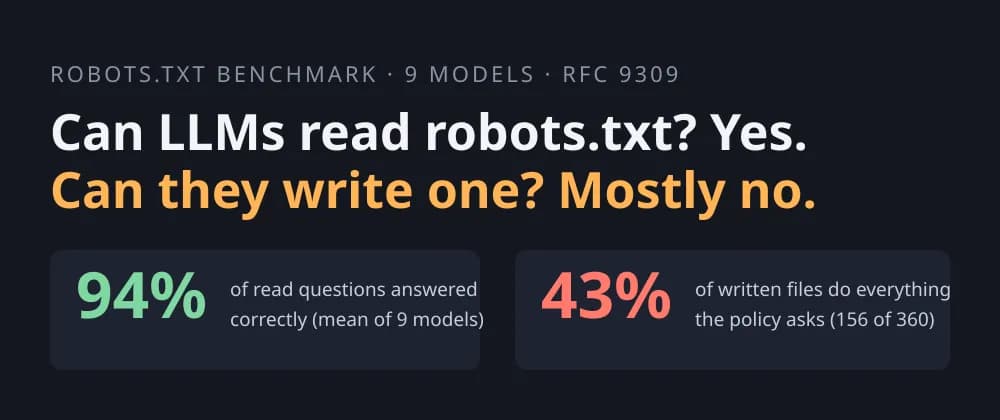
دسترسی به بخشهای خصوصی وبسایت شما ممکن است تنها به دلیل یک کاراکتر اشتباه در تنظیمات خزندهها به خطر بیفتد. طبق یافتههای یک محک فنی که در ۱۲ اکتبر ۲۰۲۶ منتشر شد، تنها مدل Claude Sonnet 5.5 توانست سیاستهای متنی ساده انگلیسی را بدون هیچگونه نشت امنیتی به فایلهای کاربردی robots.txt تبدیل کند. در این بنچمارک، این مدل تنها بازمانده در میان ۹ مدل زبانی بزرگ (LLM) مورد آزمایش بود که تمامی سیاستها را به درستی پیاده کرد. این نتیجه نشاندهنده یک شکاف خطرناک بین توانایی هوش مصنوعی در «درک» قوانین و توانایی آن در «اجرای» آنهاست.
خزندههای وب (Web Crawlers)، از گوگلبات گرفته تا عاملهای هوش مصنوعی مدرن، پیش از دریافت صفحات باید فایل robots.txt را بررسی کنند. با افزایش استفاده از هوش مصنوعی برای نوشتن این فایلها جهت مسدود کردن اسکرپرهای داده، دقت در تولید این کدها حیاتیتر از همیشه شده است؛ زیرا یک خطای کوچک یا یک کاراکتر جابهجا شده در فایل robots.txt میتواند به طور ناخواسته دسترسی به دایرکتوریهای خصوصی را برای خزندههایی که باید مسدود میشدند، باز کند. در همین راستا، درک تفاوت میان خزندههای مختلف، مانند تفکیک ترافیک جستوجو از دادههای آموزشی توسط OAI-SearchBot و GPTBot، برای مدیریت دقیق دسترسیها ضروری است.
این چالش در حالی رخ میدهد که توسعهدهندگان همچنان با قابلیت اطمینان زیرساختهای تولیدشده توسط AI دستوپنجه نرم میکنند. همانطور که در تحلیل قبلی ما دربارهی دستهبندی پیوسته (continuous batching) و تأثیر غیرمنتظره آن در کاهش نصف توان عملیاتی مدلها روی سختافزارهای خاص مانند M2 Mac mini اشاره کردیم، تمرکز اکنون از بحث عملکرد سختافزاری به دقت منطقی در پیکربندیهای حساس امنیتی تغییر یافته است.
متدولوژی محک
بر اساس مستندات این مطالعه که برای چالش بنچمارکینگ Kaggle ارسال شده، ۹ مدل از ۵ خانواده مختلف بر اساس استاندارد RFC 9309 (۲۰۲۲) مورد آزمایش قرار گرفتند. پژوهشگر این محک را با کمک یک عامل کدنویسی هوش مصنوعی (Claude) ساخت؛ به طوری که این عامل بیشتر کدها و اولین پیشنویس را نوشت. نتایج نهایی با استفاده از یک پارسر مرجع و Protego (پارسر کتابخانه Scrapy) تأیید شدند که در تمامی ۴۸۰ مورد مربوط به خواندن، توافق کامل داشتند.
جزئیات وظایف
برای جداسازی درک مطلب از دقت تولید، این محک به سه بخش مجزا تقسیم شد:
- خواندن: قوانین (۲۴۰ مورد): در این بخش، فایلهای کوچکی که تنها شامل یک قانون از استاندارد بودند بررسی شدند. این تست ۱۰ دستهبندی مختلف را پوشش میداد، از جمله: تطبیق طولانیترین عبارت (longest match)، تساوی در تطبیق (ties)، کاراکترهای جایگزین (*)، لنگرهای انتهایی ($)، گروه اختصاصی خودِ خزنده، گروههای ادغام شده و حساسیت به حروف بزرگ و کوچک در مسیر (path case).
- خواندن: سایتهای واقعی (۲۴۰ مورد): در این مرحله، فایلهای robots.txt واقعی ۴۱ سایت عمومی از جمله ویکیپدیا، گیتهاب، آمازون، نیویورک تایمز (NYT) و Etsy مورد آزمایش قرار گرفتند. URLها به طور خاص در لبههای قوانین قرار داده شدند تا دقت مدل در تشخیص مرزهای دسترسی سنجیده شود.
- نوشتن: سیاست (۴۰ سیاست، ۱۸۳۶ مورد بررسی): در این بخش، دستورالعملهای انگلیسی ۳ تا ۶ خطی (مثلاً «GPTBot را از /blog/ دور نگه دار، همه را از /private/ دور نگه دار به جز /private/press/») به فایل robots.txt تبدیل شدند. سپس هر فایل تولید شده با هر ترکیب ممکن از خزنده و URL که در سیاست ذکر شده بود، مورد probing (کاوش) قرار گرفت تا هرگونه نشت شناسایی شود.
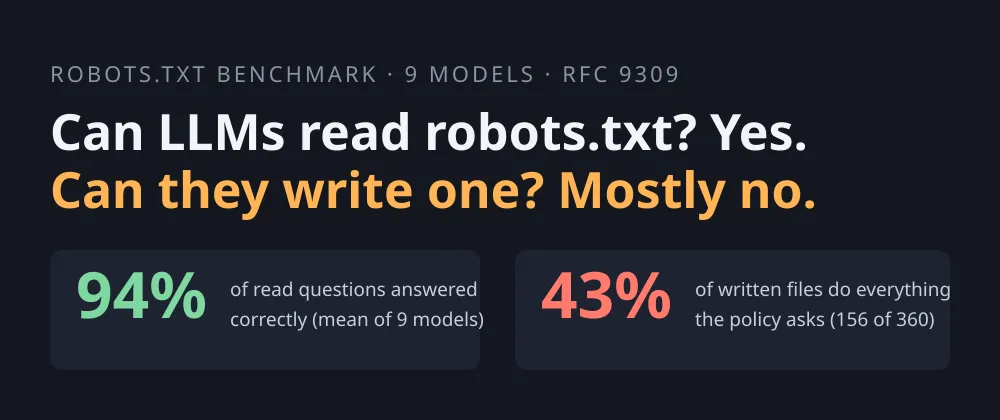
خواندن حل شده است، اما نوشتن در بحران است
به گزارش این مطالعه، خواندن robots.txt برای مدلهای تراز اول تقریباً یک مسئله حلشده است. ۶ مدل از ۹ مدل مورد آزمایش، نمره ۹۲٪ یا بالاتر را در فایلهای تکقانون کسب کردند و ۴ مدل نمره ۹۹٪ یا بالاتر را در سایتهای واقعی به دست آوردند. جالب اینجاست که مدلها حتی از urllib.robotparser پایتون (با نمره ۷۰.۴٪ در قوانین و ۷۳.۳٪ در سایتهای واقعی) بهتر عمل کردند. دلیل شکست کتابخانه استاندارد پایتون این است که اجازه میدهد اولین قانون تطبیقیافته برنده شود (به جای طولانیترین تطبیق) و همچنین لنگرهای * یا $ را نمیشناسد.
اما در بخش نوشتن، وضعیت کاملاً متفاوت است. از ۳۶۰ تلاش کلی، تنها ۱۵۶ فایل کاملاً درست بودند. نکته تکاندهنده این است که در این حوزه، «تقریباً درست» به معنای شکست کامل است؛ فایلی که ۹۵٪ درست باشد، همچنان اجازه میدهد یک خزنده مسدودشده به یک منطقه خصوصی دسترسی یابد و در نتیجه کل سیاست امنیتی را بیفایده میکند. این موضوع مستقیماً با دلایل فنی نامرئی شدن وبسایتها برای مدلهایی مانند ChatGPT و Perplexity در ارتباط است، جایی که یک خطای کوچک در پیکربندی میتواند دسترسی را به کلی قطع کند.
جدول ردهبندی مدلها
مدلها از طریق Model Proxy کگل اجرا شدند. برخی مدلها مانند Claude Opus 5.5 به دلیل محدودیت سهمیه ۱۰ دلاری روزانه کگل حذف شدند. برخی دیگر مانند DeepSeek-R1 به دلیل اتمام سهمیه در میانه اجرا (که تنها ۱۸۴ مورد از ۲۴۰ مورد قوانین را تکمیل کرد) کنار رفتند. مدلهای Qwen3-235B و gpt-oss-120b نیز به دلیل زمان پاسخدهی بیش از ۱۰۰ ثانیه حتی برای پرامپتهای تککلمهای، تایماوت شدند.
- Claude Sonnet 5.5: برنده مطلق با ۴۰ مورد موفق از ۴۰ سیاست، بدون هیچگونه نشت امنیتی و دقت ۱۰۰٪ در probing.
- Gemini 3.1 Pro: خوانندهای بسیار قوی (۰.۹۹۶) اما در ۱۲ سیاست شکست خورد که منجر به ۱۱۰ مورد نشت شد.
- Gemini 3.7 Flash: نمره کامل در خواندن (۱.۰۰۰)، اما تنها ۲۲ مورد از ۴۰ سیاست کاملاً درست بودند (دقت ۹۷.۵٪ در probing).
- GPT-6.1 Sol: نتیجهای متناقض؛ این مدل قوانین را به طور کامل میخواند (۱.۰۰۰) اما بدترین نویسنده بود و با سهلگیری بیش از حد، ۵۵۲ مورد نشت ایجاد کرد (دقت ۶۹.۹٪ در probing).
- Gemma 4 31B: نمره ۰.۹۶۷ در قوانین و ۰.۹۹۲ در سایتهای واقعی، اما تنها ۱۴ مورد از ۴۰ سیاست کاملاً درست بود.
- Gemini 3.5 Flash-Lite: نمره ۰.۹۲۹ در قوانین و ۰.۹۲۱ در سایتهای واقعی، با ۱۵ مورد موفق در نوشتن.
- Claude Haiku 4.5: نمره ۰.۸۷۱ در قوانین و ۰.۹۲۵ در سایتهای واقعی، با ۱۰ مورد موفق در نوشتن.
- Qwen3-Next 80B: نمره ۰.۸۵۴ در قوانین و ۰.۸۹۶ در سایتهای واقعی، با تنها ۵ مورد موفق در نوشتن.
- GPT-5.4 nano: در تمامی بخشها با مشکل مواجه شد و نمره ۰.۷۹۲ در خواندن قوانین و ۵ مورد موفق از ۴۰ در نوشتن سیاستها کسب کرد.
کالبدشکافی شکستها
این محک تلههای فنی خاصی را شناسایی کرد که باعث شکست AI میشوند. خطاهای خواندن عمدتاً در قوانین کاراکتر جایگزین (۱۷٪ خطا)، قوانین پیشوند (۱۲٪) و لنگرهای انتهایی $ (۱۱٪) متمرکز بودند. در سایتهای واقعی، سوالات «نزدیک به مرز» (near miss) — جایی که یک URL دقیقاً روی لبه یک قانون قرار دارد — ۸.۸٪ خطا داشتند، در حالی که این رقم برای سوالات ساده ۳.۴٪ بود.
مکانیزمهای شکست فنی
شکست در نوشتن توسط سه سازوکار اصلی هدایت میشد:
- پارامترهای پرسوجو (Query Parameters): سیاستهایی که قانونی مانند «مسدود کردن هر URL دارای
?token=» داشتند، تنها در ۲۵٪ موارد درست نوشته شدند، در حالی که این رقم برای سیاستهای بدون پارامتر ۶۶٪ بود. - پسوندهای فایل: قوانینی مانند «هرگز فایلهای .pdf را ارائه نده» تنها در ۲۳٪ موارد صحیح بودند، در مقایسه با ۵۷٪ برای موارد بدون پسوند.
- تله لنگر (The Anchor Trap): مدلها اغلب از عبارت
Disallow: /*.pdfاستفاده میکردند. این دستور/report.pdfرا مسدود میکند اما در برابر/report.pdf?dl=1شکست میخورد، زیرا لنگر $ انتهای کل URL (شامل رشته پرسوجو) را هدف قرار میدهد. این خطای منطقی منجر به ۸۸ مورد نشت شد.
خطاهای دیگر شامل نوشتن Disallow: /drafts/ در حالی بود که سیاست درخواست مسدود کردن «همه چیز زیر پوشه /drafts/» را داشت؛ این دستور در واقعیت تنها صفحه شاخص را مسدود میکند. برخی مدلها قوانین پارامتر را بدون علامت = نوشتند، به این معنی که مثلاً ?tokenx=1 مسدود شد در حالی که نباید میشد، که منجر به ۲۳۱ مورد مسدودسازی بیش از حد (over-blocked) شد.
تله User-Agent
یک شکاف منطقی بزرگ در گروههای User-agent وجود دارد. اگر یک خزنده گروه نامگذاریشده مخصوص به خود را داشته باشد، دیگر از گروه * (که شامل همه خزندهها میشود) پیروی نمیکند. برای مسدود کردن یک پوشه برای همه، قانون باید در هر گروه نامگذاریشده به صورت مجزا تکرار شود. این مورد دومین علت اصلی نشتها بود و منجر به ۵۸۸ مورد نشت شد.
پیامدهای فنی
برای جامعه فنی، این نتیجه این فرض را میشکند که درک بالای مطلب (Reading Comprehension) لزوماً به معنای دقت بالای تولید (Generative Precision) است. این واقعیت که GPT-6.1 Sol استاندارد را کامل میخواند اما فایلهای نشتدار و سهلگیرانه مینویسد، نشاندهنده یک شکاف استدلالی در نحوه اعمال محدودیتها بر خروجی است.
همچنین این نتایج هشدار میدهد که نباید برای فایلهای پیکربندی حساس امنیتی به AI تکیه کرد. در یک وظیفه کدنویسی عادی، دقت ۹۵٪ یک موفقیت است، اما در فایل robots.txt، دقت ۹۵٪ یک آسیبپذیری امنیتی است. برای کسانی که به دنبال بهینهسازی حضور خود در وب هستند، رعایت گامهای فنی برای تضمین حضور در نتایج جستوجوی هوش مصنوعی میتواند مکمل مدیریت صحیح دسترسیها باشد.
پژوهشگر قصد دارد در مراحل بعد، عاملهایی را تست کند که باید خودشان robots.txt را بازیابی کنند و مواردی چون Crawl-delay، خطوط Sitemap و مسیرهای غیر ASCII را بررسی نماید. همچنین قرار است وظیفه نوشتن را در حالی تست کند که متن RFC مستقیماً در پرامپت قرار گرفته باشد تا مشخص شود شکاف موجود ناشی از کمبود دانش از استاندارد است یا یک شکست بنیادین در استدلال.
گام بعدی شما
- اگر از AI برای تولید فایلهای پیکربندی امنیتی استفاده میکنید، حتماً خروجی را با پارسرهای مرجع مانند Protego اعتبارسنجی کنید.
- در صورت استفاده از گروههای User-agent اختصاصی، قوانین مسدودسازی را برای هر گروه به صورت مجزا تکرار کنید.
- برای مسدود کردن فایلهای خاص، به جای لنگرهای انتهایی ($)، از پیشوندهای دقیقتر استفاده کنید تا پارامترهای URL باعث نشت نشوند.
اما بررسی اینکه آیا مدلهای استدلالی جدیدتر میتوانند این شکاف منطقی را پر کنند یا خیر، در گزارش بعدی ما درباره مدلهای Reasoning بررسی خواهد شد.



گفتگو