
اگر برای بهبود دستیار کدنویسی خود فقط روی بهینهسازی بردارها تمرکز کردهاید، احتمالاً در حال حل نیمی از مسئله هستید. دادههای جدید نشان میدهد که تغییر سادهای در نحوه ارائه متن به مدل — یعنی ارسال کل فایل بهجای تکههای خرد شده — میتواند نرخ موفقیت را از ۶٪ به ۵۰٪ برساند.
طبق گزارشی که در ۲۷ سپتامبر ۲۰۲۶ در dev.to منتشر شد، در سیستمهای تولید بازیابیافزا (RAG) — که شبیه دانشآموزی است که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — متداولترین روش، تکهبندی (Chunking) است. در این روش، فایلها به قطعات کوچک تقسیم میشوند تا در پنجره متنی (Context Window) — یعنی میز کاری مدل که فقط جای چند ورق دارد — جا شوند. اما این کار باعث میشود منطق کسبوکار و هدف کلی کد که در ارتباط میان بخشهای مختلف فایل نهفته است، از بین برود.
برای توسعهدهندگان، این به معنای آن است که هوش مصنوعی ممکن است تابع درست را پیدا کند، اما در درک دلیل وجود آن یا نحوه قرارگیری آن در سیستم بزرگتر شکست بخورد. مشکل اصلی این است که جستوجوی RAG در یک کدبیس ناآشنا، کد را میبیند اما «قصد» (Intent) نویسنده را گم میکند. بر اساس این گزارش، بردار معنایی (Embedding) — که مثل کارت معرفی عددی برای هر واژه است — تکهها را بر اساس کلمات کلیدی مییابد و PropertyGraphs نمادها را با نام پیدا میکنند، اما هیچکدام نمیتوانند به پرسشی مثل «منطق واقعی کسبوکار در اینجا کجاست و چه چیزی را میتوانم با خیال راحت حذف کنم؟» پاسخ دهند، چون این پاسخ در نمایش استاتیک کد وجود ندارد.
خط لوله بوتاسترپ (Bootstrap Pipeline)
پژوهشگر برای حل این مشکل، یک خط لوله برای نمایهسازی کد پیاده کرد که بر چهار ستون استوار بود:
- موجودیتها (Entities): استفاده از انواع داده (Types) و دیتا-کلاسها به عنوان ستون فقرات دامنه.
- نقاط ورود (Entry points): شناسایی مرزهای سیستم از طریق دکوراتورهایی مثل
@mcp_app.tool. - تستها به عنوان مرجع (Ground Truth): استفاده از تستها به عنوان تنها راه قطعی برای شناسایی منطق اجرایی زنده.
- گیت به ADR: استخراج تاریخچه تصمیمات مستقیماً از لاگهای کامیت (Commit Logs).
یک پیشرفت کلیدی، استفاده از یک پلاگین سفارشی sys.settrace برای پیوند دادن تستها به توابع واقعی بود که آنها را اجرا میکنند. این ردیابی پویا بسیار مؤثرتر از تطبیق نامهای استاتیک بود؛ در واقع، روش تطبیق استاتیک در ۱۰۰٪ نمونههای ارزیابی (۰ مورد از ۱۰۹ تطبیق کاندید) شکست خورده بود.
جزئیات ردیابی پویا
پلاگین sys.settrace تعداد ۱۷۲۷ تست را ردیابی کرد و نشان داد فرض «یک تست = یک تابع» یک باور غلط است. دادههای استخراج شده حاکی از آن بود که:
- ۱۵۵۱ تست (۸۹.۸٪) حداقل یک تابع منبع را اجرا میکنند.
- ۱۲۱۲ تابع منحصربهفرد شناسایی شدند.
- میانگین تعداد توابع در هر تست اجرایی ۱۰.۱ مورد بود (میانه ۶، در بازه ۱ تا ۱۱۸).
به دلیل این پیچیدگی، پژوهشگر دریافت که لبههای مربوط به تستها (TESTS edges) برای گنجانده شدن در سیستم نیازی به رتبهبندی (Ranker) ندارند و صرفاً مجموعه خام فراخوانیهای ردیابی شده تحت فیلترهای Exp-7 بودند. در مقابل، روشهای دیگر رد شدند:
- رتبهبندی Tarantula: به عنوان انتخابگر رد شد زیرا رتبههای $\le 3$ تنها ۲۲.۶٪ از تستها را پوشش میدادند، هرچند به عنوان یک یادداشت برای میزان اطمینان (Confidence Annotation) حفظ شد.
- Coverage.py: پلاگین سبکوزن پژوهشگر از نظر سربار (Overhead) بهتر از
coverage.pyعمل کرد (۱۳.۶٪ در برابر ۱۹.۹۶٪ در اجراهای A/B در یک نشست). - سیگنالهای استاتیک: این سیگنالها به بازخوانی اتحادی (Union Recall) ۷۰٪ روی مجموعه طلایی ردیابی پویا رسیدند، اما بیشتر به عنوان یک مکمل باقی ماندند تا یک پیشران.
قابلیت انتقال (Portability) این سیستم بالا بود؛ به طوری که ۹۷.۳٪ (۲۸۰۵ از ۲۸۸۲) تست در gemma_agent و ۱۰۰٪ (۲۷ از ۲۷) تست در مخازن commit- پیوند داده شدند.
سیگنال E17
این خط لوله به حلقه E17 ختم شد که در آن تا سه تست پوششی برای هر تابع با امتیاز گراف ۰.۴ (وزن گروه TESTS در مقابل ۱.۰ برای تعاریف) اضافه میشد. اگرچه این کار معیار hit@1 را تغییر نداد، اما بستر ثانویه حیاتی برای مدل فراهم کرد. در پانلی گسترده با ۳۵ پرسوجو، مرحله گراف (graph_stage) باعث بهبود ۱۵.۳ درصدی شد. سیگنال E17 توانست از ۵ مورد از ۵ حمله تیم قرمز (Red Team) بهطور کامل دفاع کند، هرچند پژوهشگر اشاره کرد که سیگنال TEST برای مدل یک «بستر» (Context) است، نه ابزاری برای بهبود جستوجو.
طراحی آزمایش چهارشاخه (F5)
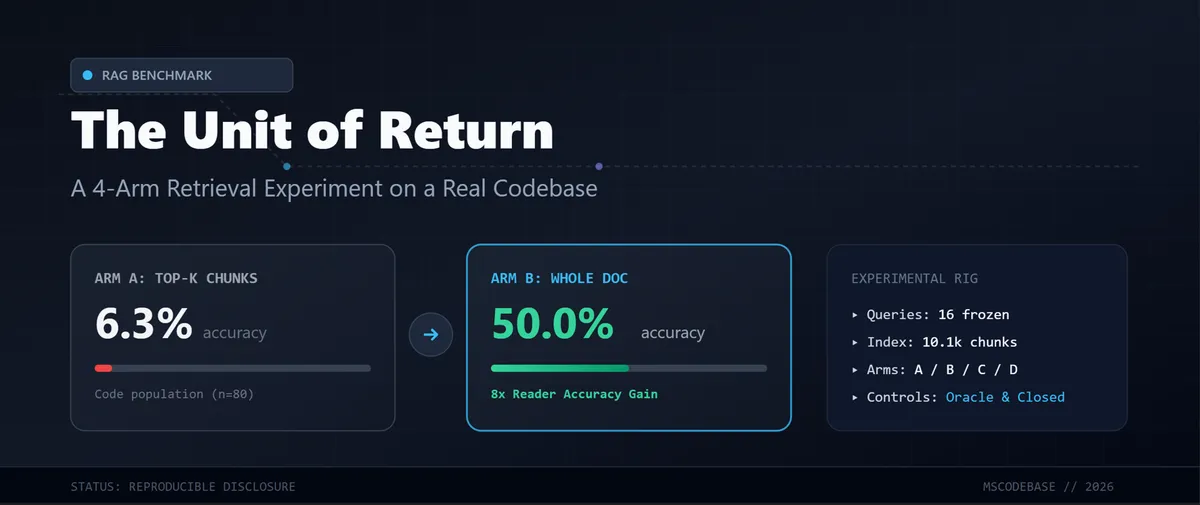
برای جداسازی اثر «واحد بازگشتی»، آزمایشی کنترلشده به نام F5 اجرا شد. این یک طراحی منجمد (Frozen Design) با ۱۶ پرسوجو (۸ کد، ۸ متن) و ۱۶۰ ارزیابی برای هر شاخه بود که در مجموع ۶۴۰ حکم نهایی تولید کرد (هر حکم نیازمند ۲ فراخوانی LLM بود: یک خواننده و یک داور). پرسوجوها از طریق هش SHA256 (e048aa12d36d95fb6d252de015d0ae807cbbce718e9c78effcd334f7c3ce83cb) و بررسی همپوشانی توسط frozen_overlap_check.py v2 تأیید شدند.
اسنپشات ایندکس (گرفته شده در ۲۰۲۶-۰۹-۲۶) شامل ۱۰,۱۰۶ تکه، ۷۱۶ فایل و ۱۴,۰۹۹ نماد بود. بازیاب (Retriever) از حالت کیفی ترکیبی شامل BM25، Dense و FTS5 با لایههای سیگنال گراف استفاده میکرد و از ادغام رتبه متقابل ۳-راهه (3-way RRF) و رتبهبندی مجدد BGE-M3 بهره میبرد.
آنها چهار «شاخه» مختلف برای تحویل بستر را با استفاده از خواننده longcat-2.0 و داور کور qwen3.7-plus (با معیار باینری درست/نادرست و اکثریت $\ge 6/10$) تست کردند:
- شاخه A: ۱۰ تکه (Chunk) برتر بازیابی شده.
- شاخه B: متن کاملِ اولین سند بازیابی شده (Top 1 Document).
- شاخه C (اوراکل): فایل طلایی که دقیقاً روی بازه پاسخ تکهبندی شده است.
- شاخه D (کتاب بسته): بدون هیچ بستری (بلاک متنی خالی).
نتایج: کد در برابر متن
دادهها تفاوت عظیمی را بین نحوه برخورد هوش مصنوعی با کد و متن نشان داد. برای پرسوجوهای مربوط به کد، روش «سند کامل» (شاخه B) به نرخ موفقیت ۵۰٪ (۴۰ از ۸۰) رسید، در حالی که روش «تکههای برتر» (شاخه A) تنها ۶.۳٪ (۵ از ۸۰) موفق بود. این نشاندهنده افزایش ۸ برابری دقت صرفاً با تغییر واحد بازگشتی است، در حالی که بازیاب برای هر دو حالت یکسان بود. فواصل اطمینان (Wilson 95%) برای کد، برای شاخه B در بازه [۳۹.۳–۶۰.۷] و برای شاخه A در بازه [۲.۷–۱۳.۹] بود که هیچ همپوشانی نداشتند.
در مقابل، پرسوجوهای متنی با تکهها (۲۶.۳٪، CI ۱۷.۹–۳۶.۸) بهتر از اسناد کامل (۱۸.۸٪، CI ۱۱.۷–۲۸.۷) عمل کردند. اگرچه فرضیه «فروپاشی متن» (اینکه اسناد کامل به بدی کتابهای بسته عمل کنند) کاملاً تکرار نشد — زیرا ۱۸.۸٪ هنوز بالاتر از نرخ ۰٪ کتاب بسته است — اما جهت نتایج نشان میدهد که متون اغلب با یک قطعه دقیق و ایزوله قابل حل هستند. اکثریت پاسخها برای هر پرسوجوی متنی ۲/۸ برای شاخه A و ۱/۸ برای شاخه B بود.
شکست بازیابی در برابر شکست خواننده
این مطالعه شکافی حیاتی را آشکار کرد: شکست در بازیابی با شکست در رتبهبندی متفاوت است. در این آزمایش، نرخ hit@1 (اینکه سند درست در رتبه اول باشد) تنها ۳۱.۲٪ (۵ از ۱۶) بود. اما وقتی سند درست (در شاخه اوراکل) ارائه شد، دقت به ۹۷.۵٪ (۱۵۶ از ۱۶۰) جهش کرد.
این ثابت میکند که مدل خواننده قادر است پاسخ را بیابد اگر بستر موجود باشد، اما بازیاب اغلب در بیرون کشیدن فایل درست شکست میخورد. هیچ سندی فراتر از رتبه ۳، سند طلایی نبود که نشاندهنده شکست در بازیابی است. جالب اینجاست که بسترهای اوراکل بهطور میانگین کوچکتر (۷۳۳۷ کاراکتر) از اسناد کامل در شاخه B (۱۹۷۴۷ کاراکتر) بودند؛ این ثابت میکند که «کامل بودن» واحد بازگشتی مهمتر از «حجم» متن است. میانگین کاراکترهای بستر برای شاخه A برابر ۴۹۴۶ بود.
تست رویکرد گرافی (NodeRAG)
فراتر از واحد بازگشتی، پژوهشگر NodeRAG را (که از BFS در PropertyGraph با عمق ۳ استفاده میکرد) در برابر تکهبندی TF-IDF استاندارد روی ۱۰ پرسوجوی قاعدهمند (sha 8657a7e3...) تست کرد:
- شاخه A (TF-IDF): نرخ موفقیت ۸۰٪ (۸ از ۱۰) با مصرف ۳۰۱,۹۸۱ توکن.
- شاخه B (Graph BFS): نرخ موفقیت ۷۰٪ (۷ از ۱۰) با مصرف ۱۷۰,۱۴۰ توکن.
اگرچه رویکرد گرافی مصرف توکن را ۴۳.۶٪ کاهش داد، اما در نرخ موفقیت شکست خورد. دلیل این اتفاق «شکنندگی نقطه ورود» (Entry-point fragility) بود؛ هر سه مورد شکست (پرسوجوهای R1، R2 و R7) صفر فایل برگرداندند چون گرههای اولیه (Seed Nodes) شکست خوردند. این نشان میدهد کیفیت پیمایش نمیتواند نقص نقطه ورود را جبران کند.
اعتبارسنجی و حملات تیم قرمز
برای اطمینان از استواری، حملاتی روی سیگنال E17 انجام شد. سیستم تمام حملات را دفع کرد، از جمله:
- ۱۰ رشته (Thread) $\times$ ۱۰۰ فراخوانی با صفر خطا.
- یک تابع مرکزی با ۲۳۴ تست که با میانگین ۱۶.۱ میلیثانیه پاسخ داد.
- پرسوجو برای توابع موجود نبود و مسیرهای PropertyGraph موجود نبود (هر دو نتیجه صفر برگرداندند).
- بستن گراف در میانه فراخوانی، که منجر به نتایج خالی شد بدون اینکه سیستم کرش کند.
برای پایلوت F5، پژوهشگر سه مورد «خود-حمله» (Self-attack) را افشا کرد:
- تساوی اکثریت: یک نقطه منتشر شده برای B بر اساس تساوی ۵/۵ بود؛ سپس قوانین سختگیرانه (>۵۰٪) اعمال شد تا اصلاح شود (B متن ۱/۸، B کل ۵/۱۶).
- اجراهای نامعتبر: ادعای «صفر نامعتبر» برای trials=10 درست بود، اما برای پایلوت t5 غلط بود (یک اجرای نامعتبر در F5S-03/B).
- تعریف طلایی: برای ۷ از ۸ پرسوجوی متنی، هیچکدام از شاخهها سند طلایی را نداشتند، اما خواننده همچنان از طریق ترجمههای تکراری از یک حقیقت واحد، امتیاز گرفت.
چه چیزهایی میتواند اشتباه پیش برود؟
پژوهشگر به چندین محدودیت در این مطالعه در مقیاس پایلوت (n=16) اشاره کرد. اول، درصدها نشاندهنده «جهت» هستند نه اثرات مطلق، بهویژه برای متن که نتایج تنها به دو پرسوجو وابسته است. دوم، ایندکس اسنپشات شده بود اما کاملاً منجمد نشده بود، به این معنی که مقداری رانش (Drift) بین اجراها رخ داد. سوم، خواننده مورد استفاده (longcat-2.0) یک مدل پیشرو (Frontier) نیست؛ یک خواننده قدرتمندتر ممکن است شکاف ۸ برابری را کاهش دهد.
سایر ریسکهای فنی عبارتند از:
- باند نویز: توافق t5 $\rightarrow$ t10 نشاندهنده بازتولیدپذیری است، نه اندازهگیری نویز.
- هزینههای توکن: هزینه توکن برای هر شاخه در F5 اندازهگیری نشد و فقط کاراکترهای بستر محاسبه شدند.
- نقطه عملیاتی: مقدار
graph_score = 0.4در برابر تعامل BM25/reranker در یک جدول تکمتغیره تأیید نشده است. - محدودیتهای سیگنال TESTS: اینها فقط برای پایتون هستند و سربار ۱۵.۳٪ در
graph_stageروی پانل ۳۵ پرسوجویی ایجاد کردند. همچنین ۱۰.۲٪ از تستها صفر تابع منبع را اجرا میکنند (نابینایی Mock).
این آزمایش فرض بنیادی را که «برداریهای بهتر» تنها راه بهبود RAG هستند، تغییر میدهد. این نتایج پیشنهاد میکند که برای دامنههای فنی مانند مهندسی نرمافزار، صنعت باید تمرکز خود را از «چگونه تکهها را بیابیم» به «چگونه واحدهای بازگشتی را برای LLM بستهبندی کنیم» تغییر دهد. اگر در حال ساخت دستیار کدبیس هستید، بهینهسازی اندازه تکهها را متوقف کنید و بازیابی کل فایل را برای پیچیدهترین پرسوجوهای منطقی خود تست کنید.
گام بعدی شما
- اگر در حال ساخت دستیار کدنویسی هستید، به جای بهینهسازی اندازه تکهها (Chunk Size)، بازیابی کل فایل را برای پرسوجوهای پیچیده تست کنید.
- برای بهبود بازیابی، به جای تکیه بر بردارها، از ردیابی پویا (Dynamic Tracing) برای پیوند دادن تستها به توابع استفاده کنید.
- در سیستمهای RAG، ابتدا بررسی کنید آیا مدل با داشتن سند درست پاسخ میدهد (تست اوراکل) یا اینکه مشکل از عدم بازیابی سند است.
اما داستان سختافزاری این تحول و هزینه استنتاج در مقیاس بالا حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو