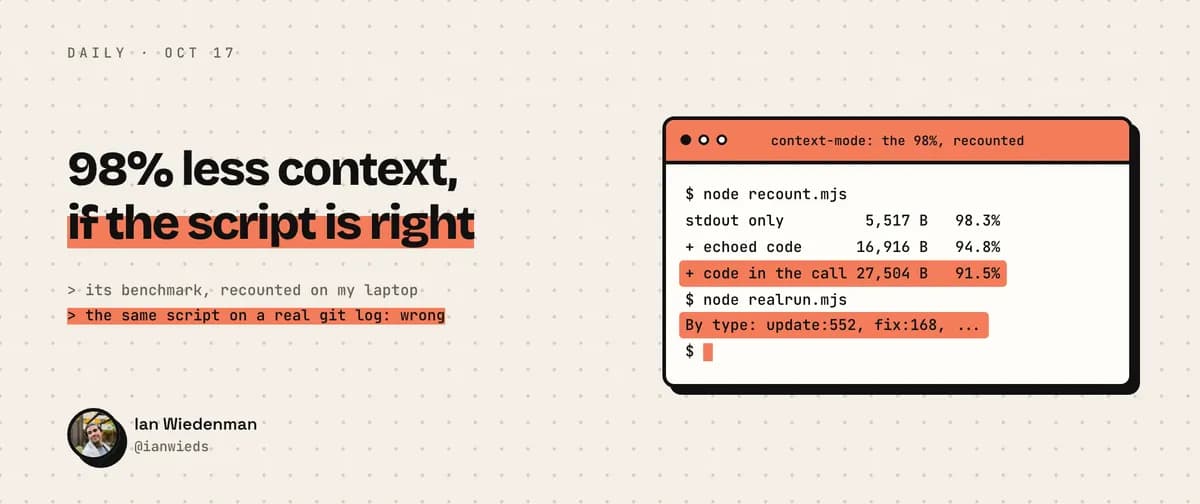
اگر امروز برای پردازش فایلهای حجیم در عاملهای هوشمند هزینه میکنید، احتمالاً با مشکل «تورم زمینه» (Context Bloat) روبرو هستید که حافظه مدل را میبلعد و هزینهها را افزایش میدهد. تصور کنید به جای اینکه یک کتاب ۵۰۰ صفحهای را به یک دستیار بدهید تا یک جمله از آن پیدا کند، به او یاد بدهید خودش یک جستوجوی سریع در کتابخانه انجام دهد و فقط همان جمله را برایتان بیاورد.
این دقیقاً همان ایدهای است که context-mode، سرور جدید پروتکل زمینهٔ مدل (MCP) ساخته شده توسط Mert Koseoğlu، پیاده میکند. ادعای مرکزی این پروژه این است که اگر یک عامل هوشمند بتواند اسکریپت استخراج بینقصی بنویسد، کاهش ۹۸ درصدی در مصرف پنجره زمینه امکانپذیر است. این ابزار تغییر میدهد که عاملها چگونه با خروجیهای حجیم ابزارها برخورد میکنند. به جای انتقال کامل یک اسنپشات ۵۶ کیلوبایتی از یک صفحه به محیط گفتگو، عامل یک اسکریپت کوچک مینویسد که در یک زیرپردازش (Subprocess) اجرا شده و تنها دادههای مورد نیاز را بازمیگرداند.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی هزینههای استنتاج اشاره کردیم، جابهجایی پردازش از مدلهای گرانقیمت به CPUهای ارزانقیمت محلی، ترند اصلی سال ۲۰۲۶ است. این ابزار در زمانی عرضه شده که توسعهدهندگان به سمت عاملهای خودمختارتری مثل Claude Code، Cursor و Gemini CLI و همچنین Codex و دهها ابزار دیگر حرکت میکنند. هدف نهایی این است که مرحله «خلاصهسازی» از پنجره زمینه گرانبهای LLM به CPU ارزان ماشین محلی منتقل شود. این رویکرد پاسخی به چالشهایی است که حجم بالای زمینه در کدنویسی AI ایجاد کرده و منجر به افزایش نویز در پاسخها شده است.
زمینه و پیشینه پروژه
پروژه context-mode اخیراً مورد توجه زیادی قرار گرفته است. این پروژه در یک روز جمعه در گیتهاب ترند شد و در همان روز ۹۰۴ ستاره دریافت کرد که مجموع ستارههای آن به نزدیک ۳۰,۰۰۰ عدد میرسد. این پروژه تحت لایسنس Elastic License 2.0 منتشر شده است و در ماه مارس از لایسنس اولیه خود (MIT) تغییر وضعیت داد.
مفهوم این ابزار در ماه فوریه بحثهای گستردهای را در Hacker News برانگیخت و یک رشته گفتگو (Thread) در این باره به ۵۷۰ امتیاز رسید. ارزش پیشنهادی اصلی این است که از بارگذاری فایلهای عظیم در پرامپت اجتناب شود و در عوض، بر اجرای محلی برای فیلتر کردن دادهها پیش از رسیدن آنها به مدل تکیه شود. این تلاش برای بهینهسازی حافظه در حالی صورت میگیرد که راهکارهای دیگری مانند لایههای تصویرسازی Baize برای درمان فراموشی عاملها در حال توسعه هستند.
جزئیات فنی و سازوکار
context-mode به عنوان پلی میان عامل و سیستم فایل محلی عمل میکند. بر اساس مستندات پروژه، وقتی عامل با یک فایل حجیم مواجه میشود، کل آن را نمیخواند؛ بلکه یک فراخوانی ابزار (Tool Call) برای نوشتن یک اسکریپت TypeScript ارسال میکند. این اسکریپت فایل را در محیط محلی پردازش کرده و فقط خلاصه مرتبط را در کنسول چاپ میکند.
برای خروجیهایی که همچنان حجیم هستند (بیش از ۵ کیلوبایت)، سیستم از یک شاخص جستوجوی تماممتن SQLite FTS5 استفاده میکند. این قابلیت به مدل اجازه میدهد بدون بارگذاری کل متن در پرامپت، بخشهای خاصی از داده را کوئری کند. همچنین یک حافظه نشست (Session Memory) طراحی شده است که قرار است در برابر فشردهسازی (Compaction) مقاوم باشد، هرچند این قابلیت هنوز در بنچمارکهای عملی به طور گسترده آزمایش نشده است.
واقعیتِ بنچمارک ۹۸ درصدی
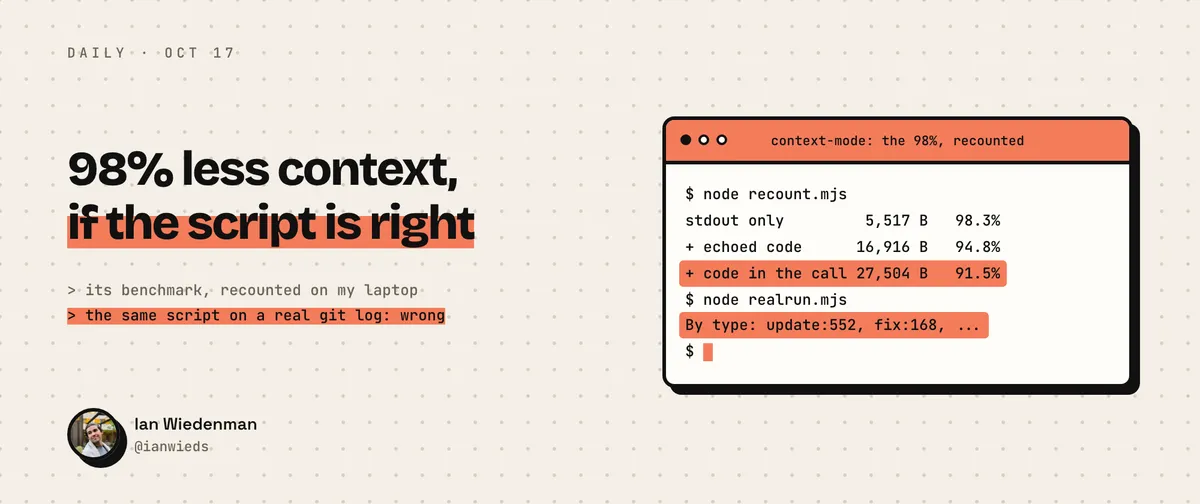
به نقل از گزارشی که در ۱۷ اکتبر ۲۰۲۶ منتشر شد، عدد خیرهکننده ۹۸٪ از بنچمارکی شامل ۱۴ سناریوی مختلف استخراج شده است. در این سناریوها، خروجیهای ذخیره شده ابزارها با اسکریپتهای خلاصهسازی دستنویس جفت شدهاند. موارد تست شامل این موارد بود:
- مستندات Context7
- اسنپشات Playwright از Hacker News
- ۲۰ مورد از Issueهای React
- یک اجرای تست (Test Run)
- لاگهای nginx
در این آزمایشها، ۳۱۴.۹ کیلوبایت داده خام به ۵,۵۱۷ بایت کاهش یافت. اما بررسی عمیقتر فایل tests/ecosystem-benchmark.ts یک نکته حیاتی را فاش میکند: اسکریپتهای استفاده شده در این بنچمارکها توسط انسانهایی نوشته شده بودند که قبلاً دادهها را دیده بودند. این یعنی نتایج نشاندهنده «بهترین حالت ممکن» (Best Case) هستند.
در دنیای واقعی، مدل باید خودش اسکریپت را بنویسد و خودِ این اسکریپت نیز توکن مصرف میکند. همچنین سرور فعلی، اسکریپت را در هر پاسخ ctx_execute_file بازمیگرداند، که شامل مسیر فایل و کد در یک بلوک (تا ۲۰۰۰ کاراکتر) است. با احتساب این عوامل، نرخ صرفهجویی تغییر میکند:
- فقط خروجی استاندارد (عدد README): ۵,۵۱۷ بایت (۹۸.۳٪ صرفهجویی)
- با احتساب مسیر و کد بازگشتی: ۱۶,۹۱۶ بایت (۹۴.۸٪ صرفهجویی)
- با احتساب کد در فراخوانی ابزار: ۲۷,۵۰۴ بایت (۹۱.۵٪ صرفهجویی)
برای کوچکترین مورد تست — یک لیست ۴۰۰ بایتی از درخواستهای شبکه — این چرخه در واقع ۲,۴۱۴ بایت هزینه داشت که ۶ برابر حجم داده اصلی بود که قرار بود کوچک شود.
خطر خطاهای خاموش
بزرگترین ریسک این است که مدل هرگز دادههای خام را نمیبیند. اگر عامل اسکریپتی اشتباه بنویسد، یک خلاصه غلط اما با اطمینان بالا دریافت میکند. این موضوع در تست لاگهای git مشاهده شد. اسکریپت بنچمارک از یک مکانیسم پارسینگ خاص استفاده میکرد: const type = l.split(" ")[4]?.replace(":", "") || "other";.
این کد فرض میکرد که پنجمین کلمه هر خط، نوع کامیت است؛ فرضی که تنها در صورتی درست است که نام نویسنده دقیقاً دو کلمه باشد. وقتی این اسکریپت روی تاریخچه واقعی context-mode (با ۲,۲۳۴ کامیت و ۲۰۳ کیلوبایت حجم) اجرا شد، شکستهای شدیدی رخ داد:
- ۳۰٪ از کامیتها (۶۷۹ مورد) به دلیل اینکه نویسندگان نامهای دوکلمهای نداشتند، اشتباه شناسایی شدند.
- در خطوطی مثل "ci: update install stats"، کلمه "update" به عنوان نوع کامیت خوانده شد چون نویسنده
github-actions[bot](یک کلمه) بود. - نامهای سهکلمهای باعث شدند نام خانوادگی نویسنده به عنوان نوع کامیت دستهبندی شود.
چون لاگهای ۲۰۳ کیلوبایتی هرگز وارد پنجره متنی نشدند، عامل راهی برای تأیید خطا نداشت و داده غلط را به عنوان حقیقت پذیرفت. همانطور که کاربر hereme888 در Hacker News اشاره کرد، بنچمارکها فرض میکنند مدل همیشه اسکریپت استخراج درستی مینویسد. نویسنده پروژه نیز اذعان کرده که هنوز بنچمارکهای رسمی روی «کیفیت پاسخها» اجرا نکرده است.
محدودیتهای ایندکسگذاری
سیستم جستوجوی SQLite نیز نقاط ضعفی دارد. در پردازش ۱۰۰ مورد از Issueهای React (با حجم ۳۰۳ کیلوبایت) که از طریق gh issue list --json دریافت شده بود، جستوجوی عبارت «ViewTransition bugs» منجر به صرفهجویی ۹۹.۴ درصدی (۱,۶۶۷ بایت) شد، اما اطلاعات کاربردی ارائه نکرد.
دلیل آن بود که ابزار gh دادههای JSON را در یک خط واحد چاپ میکند و سیستم تکهبندی (Chunker) دادهها را بر اساس بایت قطع کرد، نه اشیاء منطقی. در نتیجه، خروجی شامل ۵ مورد بود که همگی عنوان «Output» داشتند و هر کدام تکهای ۱۲۰ کاراکتری از JSON خام از وسط بدنه یک Issue بودند. هیچکدام از شمارههای واقعی Issueها در پاسخ ظاهر نشدند. اگرچه سیستم به مدل میگوید برای بخشهای کامل از ctx_search استفاده کند، اما این کار یک چرخه رفت و برگشتی (Round Trip) دیگر اضافه میکند و پاسخ اولیه تقریباً هیچ ارزشی ندارد.
پیادهسازی عملی
برای توسعهدهندگانی که میخواهند این الگو را پیاده کنند، درس اصلی این است که «تأیید» (Verification) را بر «صرفهجویی در بایت» اولویت دهند. یک رویکرد مستحکمتر شامل موارد زیر است:
- پردازش فایلمحور: عامل را مجبور کنید ابتدا خروجی را در یک فایل محلی بنویسد.
- خلاصهسازی اسکریپتی: اسکریپت خلاصه را روی آن فایل اجرا کنید.
- تأیید نمونهای: اسکریپت را مجبور کنید در کنار آمارها، چند خط نمونه از دادههای خام را چاپ کند تا خطاهای پارسینگ آشکار شوند.
در نهایت، کیفیت خروجی عامل اکنون مستقیماً به توانایی او در نوشتن کد دقیق گره خورده است، نه فقط توانایی استدلال روی متن. معامله روشن است: شما توکنها را ذخیره میکنید، اما ریسک خطاهای برنامهنویسی را میپذیرید. این بررسی با کلون کردن مخزن و بارگذاری اجراکننده و ذخیره جستوجو از طریق type stripping در Node 22 انجام شد، بدون اینکه عامل یا مدلی در حلقه باشد، زیرا ردیاب Issueهای گیتهاب این پروژه در حال حاضر خاموش است.
گام بعدی شما
- اگر از MCP استفاده میکنید، برای جلوگیری از خطاهای خاموش، از عامل بخواهید در کنار خلاصه، چند خط نمونه از دادههای خام (Raw Samples) را هم چاپ کند.
- برای فایلهای ساختاریافته (مثل JSON)، به جای تکیه بر جستوجوی متنی، اسکریپتهایی بنویسید که ابتدا ساختار فایل را تحلیل کنند.
- در محیطهای حساس، هرگز اجازه ندهید عامل بدون نظارت انسانی، تصمیمات حیاتی را بر اساس خلاصههای اسکریپتی بگیرد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو