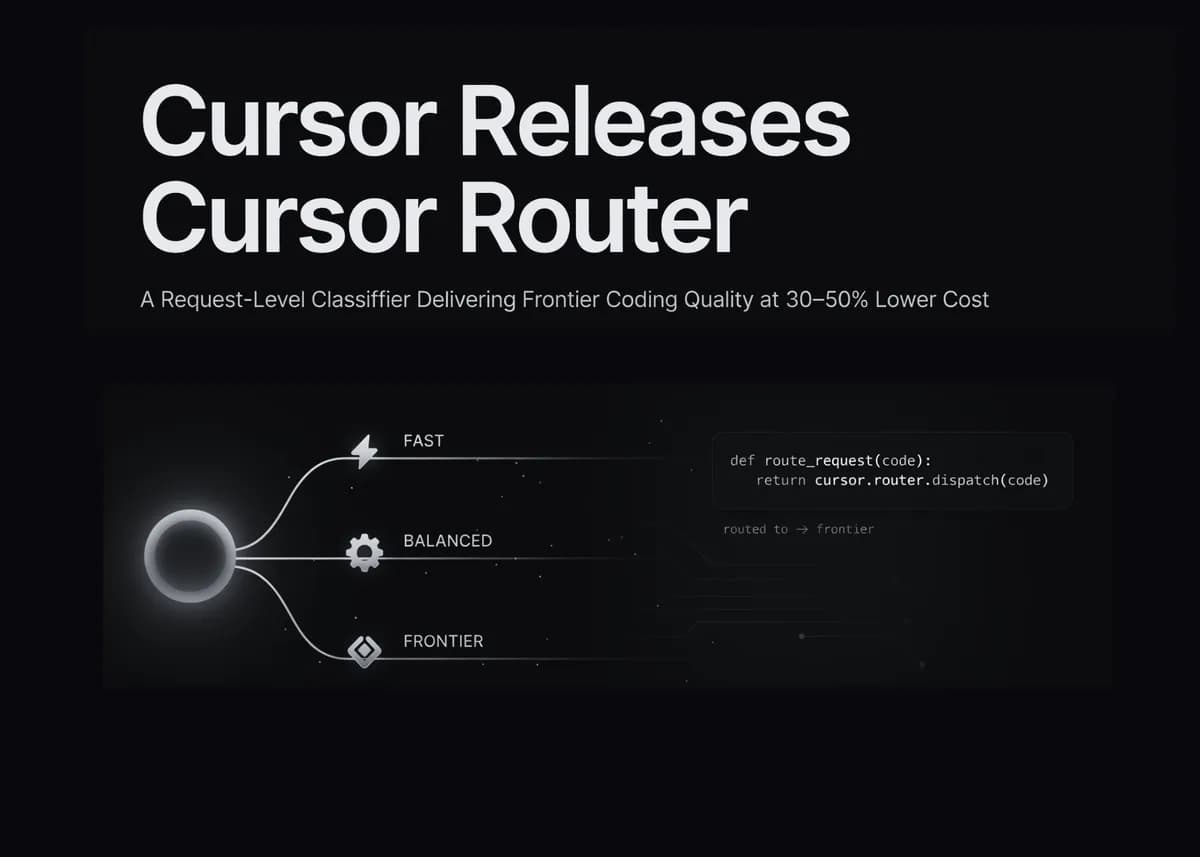
تصور کنید سیستمی داشته باشید که در آن کیفیت کدنویسی مدلهای پیشرو (Frontier) دیگر وابسته به پرداخت هزینههای گزاف این مدلها برای هر ضربه روی کیبورد نباشد. Cursor با معرفی Cursor Router، یک طبقهبندیکننده در سطح درخواست (Request-level classifier)، دقیقاً همین هدف را دنبال میکند. این ابزار هر پرامپت را پیش از آنکه به مدل برسد تحلیل میکند تا اطمینان حاصل شود که ارزانترین محاسبات ممکن، بدون قربانی کردن کیفیت خروجی، مورد استفاده قرار میگیرد. این سامانه اکنون به صورت عمومی برای طرحهای Teams و Enterprise در دسترس است.
بسیاری از توسعهدهندگان عادت دارند از یک مدل ردهبالا به عنوان «درایور روزمره» (Daily Driver) خود استفاده کنند؛ به این معنا که حتی کارهای روتین و ساده را با گرانترین نرخهای ممکن پرداخت میکنند. Cursor گزارش میدهد که تقریباً ۶۰ درصد از توسعهدهندگان این رفتار را دارند. این عدم تطابق باعث ایجاد الگویی از هزینهها میشود که در آن مخارج هوش مصنوعی سریعتر از بهرهوری واقعی رشد میکند. با بهرهگیری از روندهای صنعتی مانند «مسیریابی اوراکل» (Oracle Routing) — مشابه دینامیکهای Kimi K3 در مقابل Fable 5 که پیشتر پوشش دادیم — حالا Cursor در حال حرکت از یک انتخاب ایستا و ثابت مدل به یک سامانه توزیع پویا و عاملمحور (Agentic) است. این رویکرد یادآور تلاشهای دیگر در حوزه بهینهسازی است، جایی که استفاده از مسیریابهای معنایی در vLLM توانست عملکرد مدلهای پیشرو را در بنچمارکهای سخت به چالش بکشد.
مکانیسمهای طبقهبندی درخواست
طبق گزارش مربوط به تاریخ انتشار در ۲۲ ژوئیه ۲۰۲۶، این روتر یک مکانیزم ساده برای جایگزینی در صورت شکست (Fallback) یا تلاش مجدد (Retry) نیست. بلکه یک طبقهبندیکننده اختصاصی است که روی بیش از ۶۰۰ هزار درخواست واقعی (Live requests) آموزش دیده و از طریق آزمونهای A/B آنلاین در مقیاس میلیونها تعامل ارزیابی شده است. این سیستم برای «چرخش مدلها» (Model Churn) طراحی شده است تا Cursor بتواند با عرضه مدلهای جدیدتر در بازاری که مدلهای پیشرو هر ماه تغییر میکنند، روتر خود را بهروزرسانی کند.
برای هر درخواست ورودی، روتر چهار سیگنال مشخص را تحلیل میکند:
- پرسوجو (Query): متن تحتلفظی پرامپت (مثلاً یک درخواست کوتاه و مستقیم).
- زمینه (Context): تعداد و ماهیت فایلهای موجود در پنجره جاری (مثلاً اینکه آیا تنها یک فایل در زمینه قرار دارد یا خیر).
- پیچیدگی وظیفه: تشخیص اینکه آیا درخواست یک اصلاح ساده است یا یک تغییر ساختاری در کد.
- دامنه (Domain): زبان برنامهنویسی یا فریمورک خاصی که در درخواست دخیل است.
این ورودیها با دانش یادگرفتهشده سیستم از رفتار هر مدل خاص ترکیب میشوند تا تصمیم نهایی برای مسیریابی گرفته شود.
منطق مسیریابی سه لایهای
Cursor از سه قانون اصلی برای تعیین مقصد هر وظیفه استفاده میکند. این منطق تضمین میکند که لایه «مسائل دشوار» دستنخورده باقی بماند، در حالی که کارهای روتین از دایره قیمتهای گران مدلهای پیشرو خارج شوند:
- کارهای ساده: به سمت بهینهترین مدلها از نظر قیمت هدایت میشوند تا هزینههایی که پیشتر در نرخهای مدلهای پیشرو هدر میرفت، بازگردانده شوند. Cursor این بخش را لایهای مینامد که روتر دقیقاً برای بازپسگیری هزینههای آن خلق شده است.
- بهروزرسانیهای رابط کاربری (UI): به مدلی ارسال میشوند که بهترین «سلیقه» (Taste) یا قضاوت زیباییشناختی را دارد.
- مسائل معماری پیچیده با افق زمانی بلند: به مدلهای استدلالی (Reasoning) پیشرو سپرده میشوند. این قانون سوم است که وزن اصلی استدلال هزینهای را بر دوش میکشد، زیرا مسائل سخت هرگز به مدلهای پایینتر تنزل نمییابند.
بنچمارکهای عملکرد و هزینه
در آزمونهای A/B آنلاین، Cursor گزارش میدهد که عملکردی در سطح مدلهای پیشرو را با ۶۰ درصد صرفهجویی ارائه داده است. حسابهای سازمانی در دسترسی اولیه، کاهش هزینههای واقعی بین ۳۰ تا ۵۰ درصد را در مقایسه با استفاده انحصاری از مدل Opus 4.8 مشاهده کردهاند.
حالت Auto در Cursor سه تنظیم بهینهسازی را ارائه میدهد که کاربر را در امتداد «مرز پارتو» (Pareto Frontier) بین هزینه و هوشمندی حرکت میدهد:
- Auto Intelligence: از نظر رضایت کاربر در نزدیکی مدل Fable قرار میگیرد اما هزینه تیمها را حدود ۶۰ درصد کاهش میدهد. در مقایسه با Opus 4.8، این حالت رضایت کاربر را حدود ۱۵ درصد افزایش داده در حالی که هزینه تقریباً یکسان مانده است.
- Auto Balance: از نظر رضایت کاربر بالاتر از Opus 4.8 قرار میگیرد و هزینه را حدود ۳۶ درصد کاهش میدهد. در برابر GPT-5.6 Sol، رضایتی مشابه با نرخ هزینه کمتر ارائه میکند.
- Cost Mode: به عنوان حالتی توصیف شده که کیفیت خوبی ارائه میدهد و به بالاترین هوشمندی موجود میرسد اما مصرف توکنها را بهینه میکند. البته Cursor اعداد دقیقی از آزمونهای A/B برای این حالت منتشر نکرده است.
برای نمایش این تغییر کارایی، Cursor ارقام هزینه به ازای هر «کامیت» (Cost-per-commit) را منتشر کرد:
- Auto Balance: ۴.۶۳ دلار در هر کامیت
- Auto Intelligence: ۶.۷۶ دلار در هر کامیت
- Opus 4.8: ۷.۳۴ دلار در هر کامیت
- Fable 5: ۱۲.۶۹ دلار در هر کامیت
نکته جالب این است که گزارش شده GPT-5.6 Sol هزینه مشابه حالت Intelligence داشت اما رضایت کاربران پایینتری را به همراه داشت، هرچند Cursor رقم دقیق هزینه هر کامیت برای Sol را منتشر نکرد.
حل مشکل Cache-Miss (خطای حافظه موقت)
یک جزئیات فنی حیاتی این است که Cursor Router هم در آموزش و هم در ارزیابی، «آگاه به حافظه» (Cache-aware) است. در جریانهای کاری معمول LLM، تغییر مدل در میانه یک گفتگو باعث باطل شدن حافظه پرامپت (Prompt Cache) میشود که میتواند منجر به جهش هزینهها و افزایش تأخیر (Latency) شود. اکثر روترهای بازار این موضوع را نادیده میگیرند و صرفهجوییهای خود را بیش از حد گزارش میکنند.
Cursor طبقهبندیکننده خود را بهطور خاص روی مجموعهدادهای آموزش داده که در آن مسیریابی منجر به بروز Cache Miss میشود. بنابراین، صرفهجوییهای ۳۰ تا ۶۰ درصدی گزارششده، صراحتاً شامل هزینه این خطاها نیز میشود. این موضوع حیاتی است زیرا مسیریابی واقعی در طول یک گفتگوی کامل رخ میدهد — جایی که توسعهدهندگان کد مینویسند، سوالات تکمیلی میپرسند و با خطاها مواجه میشوند — نه در یک نوبت ایزوله و تکمرحلهای.
معیارهای کیفیت و استقرار
Cursor بهطور عمدی از ارزیابیهای آفلاین (Offline Evals) به عنوان معیار اصلی استفاده نکرد، زیرا این ارزیابیها از حجم نمونه کوچک، فاصله زیاد از کاربردهای دنیای واقعی و دشواری در تبدیل موفقیت به یک روباریک سخت رنج میبرند. در عوض، آنها از دو متریک زنده استفاده میکنند که در ۹ ماه گذشته برای هر عرضه مدل و هر تغییر در Harness به کار رفته است:
- رضایت کاربر (AFC): موفقیت عامل (Agent) که از طریق پاسخهای کاربر طبقهبندی میشود. حرکت کاربر به سمت ویژگی بعدی یک سیگنال مثبت قوی است و اصلاح پاسخ عامل، یک سیگنال منفی قوی تلقی میشود.
- نرخ ماندگاری (Keep Rate): اندازهگیری اینکه چه مقدار از کد تولید شده توسط عامل، در واقع در طول زمان در کدبیس باقی میماند.
این متریکها به عنوان نشانههای اعتبار معنادار تلقی میشوند زیرا پیش از خودِ محصول مسیریابی وجود داشتند.
کنترلها و محدودیتهای سازمانی
استقرار این ابزار برای طرحهای Teams و Enterprise در دسکتاپ، وب، iOS، CLI و SDK شرکت Cursor فعال است. این قابلیت برای تیمها بهصورت پیشفرض فعال شده است. مدیران سازمانی میتوانند سیستم را از طریق یک داشبورد با رابط مدیریتی تخصصی کنترل کنند که شامل موارد زیر است:
- فعالسازی به تفکیک هر تیم و هر گروه.
- محدودیت در مورد اینکه اعضا کدام حالتهای بهینهسازی را میتوانند انتخاب کنند.
- تعریف یک حالت پیشفرض قابل پیکربندی.
- لیستهای مجاز (Allow) و مسدود (Block) مدلها با گزینههای اجرای نرم (Soft) و سخت (Hard) برای استانداردسازی روی حالت Auto.
- تنظیمات رؤیتپذیری: مدل مسیریابیشده بهطور پیشفرض پنهان است و تیمهایی که خواهان شفافیت هستند باید آن را فعال کنند.
دو محدودیت برای بخش تامین کالا (Procurement) حیاتی است:
۱. الزام Grok 4.5: این مدل (منتشر شده در ۸ ژوئیه) به عنوان یک گزینه مسیریابی بهینه از نظر قیمت الزامی است و نمیتوان آن را از طریق لیست مسدودs خارج کرد. قیمت آن ۲ دلار برای هر میلیون توکن ورودی و ۶ دلار برای هر میلیون توکن خروجی است (نسخه Fast: ۴ دلار ورودی و ۱۸ دلار خروجی).
۲. صورتحساب متغیر: هر دو حالت Balance و Intelligence بر اساس نرخ مدل مسیریابیشده صورتحساب میشوند؛ به این معنی که هزینه واحد با هر تصمیم مسیریابی تغییر میکند و هزینه ثابت نیست.
این تغییر نشاندهنده گذاری از توسعه «مدلمحور» به ارکستراسیون «نتیجهمحور» است. با تبدیل مدل به یک کالا (Commodity) و روتر به مغز متفکر، Cursor در حال بهینهسازی مرز پارتو بین هزینه و هوشمندی است. برای تیمهای فنی، این ثابت میکند که گلوگاه بهرهوری در هوش مصنوعی دیگر تنها قابلیت مدل نیست، بلکه کارایی نحوه استقرار آن قابلیتها در حجم متنوعی از وظایف است. در حالی که Cursor بر روی مدلهای ابری تمرکز دارد، برای کسانی که به دنبال راهکارهای محلی هستند، باید به خاطر داشت که بودجه VRAM تعیینکننده اصلی در انتخاب سطح مدل کدنویسی محلی است.
توسعهدهندگان اکنون باید هزینههای فعلی خود را ارزیابی کنند تا ببینند آیا برای کدهای روتین و تکراری (Boilerplate) بیش از حد پرداخت میکنند یا خیر. میتوانید با فعال کردن Auto Balance در داشبورد Cursor، تغییر در هزینه هر کامیت خود را مانیتور کنید.
گام بعدی شما
- اگر از طرحهای سازمانی Cursor استفاده میکنید، حالت Auto Balance را فعال کنید تا کاهش هزینه در هر کامیت را مانیتور کنید.
- در داشبورد مدیریت، لیست مدلهای مجاز را بررسی کنید تا مطمئن شوید Grok 4.5 برای بهینهسازی هزینه فعال است.
- نرخ Keep Rate کدهای تولیدی خود را بررسی کنید تا متوجه شوید کدام سطح از هوشمندی برای پروژه شما «کافی» است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ برای درک اینکه این مسیریابیها چگونه بر فشار GPUهای مراکز داده اثر میگذارند، به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو