اگر برای طبقهبندی هزاران ردیف داده از مدلهای چت استفاده میکنید، احتمالاً بخش بزرگی از بودجه و زمان خود را صرف تولید توکنهای بیهوده میکنید. جایگزینی مدلهای زاینده با مدلهای تصمیمگیر، هزینههای عملیاتی شما را به یکسوم کاهش میدهد.
طبق گزارشهای فنی، یک مدل تصمیمگیر تخصصی میتواند دادهها را ۳ برابر سریعتر و با یکسوم هزینه یک مدل چت زاینده طبقهبندی کند. راهنمای پیادهسازی مدل Jev از شرکت TypeSafe نشان میدهد که با جایگزینی خط لوله طبقهبندی مبتنی بر چت با این مدل، نیاز به تجزیه متن (Parsing) و توکنهای خروجی گرانقیمت بهطور کامل حذف میشود.
بسیاری از توسعهدهندگان در حال حاضر با مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — به عنوان ابزاری همهکاره برای هر وظیفه هوش مصنوعی برخورد میکنند. آنها معمولاً از یک مدل چت میخواهند که برچسبها را در قالب JSON برگرداند. این کار سیستم را مجبور میکند تا متن را توکن به توکن تولید کند. این رویکرد باعث ایجاد تأخیر (Latency) میشود و نیازمند یک لایه پردازشی است تا برچسب واقعی را از میان نثر تولید شده استخراج کند. حتی وقتی از مدل چت «میزان اطمینان» را میپرسیم، مدل صرفاً عددی مثل «۰.۸» را به عنوان بخشی از متن تولید شده مینویسد، نه اینکه یک اندازهگیری ریاضی واقعی ارائه دهد.
تصور کنید برای مرتب کردن نامهها، از یک شاعر بخواهید نامهای بنویسد و در آن توضیح دهد هر پاکت متعلق به کدام دسته است. شما زمان و هزینه زیادی را صرف شعر میبینید، در حالی که فقط به یک برچسب دستهبندی ساده نیاز داشتید. مدلهای تصمیمگیر این مشکل را حل میکنند؛ آنها طبقهبندی را به جای تولید جمله، به مجموعهای از سؤالات «بله/خیر» تبدیل میکنند که پاسخ آنها یک عدد است. این رویکرد بخشی از یک روند گستردهتر است که در آن مدلهای تصمیمگیر محدود در حال جایگزینی LLMها در حلقههای عاملهای هوش مصنوعی هستند تا کارایی عملیاتی افزایش یابد.
همانطور که در تحلیلهای قبلی ما درباره بهینهسازی استنتاج مدلها اشاره کردیم، انتخاب ابزار مناسب برای هر وظیفه، کلید مقیاسپذیری است.
سازوکار مدلهای تصمیمگیر
برخلاف مدلهای مولد، Jev (که از طریق OpenRouter با همان کلید API در دسترس است) متنی تولید نمیکند. این مدل برای هر سؤال مشخص، یک احتمال کالیبرهشده بین ۰ و ۱ برمیگرداند. این تغییر در معماری مزایای فنی فوری و قابل توجهی ایجاد میکند:
- توکن خروجی صفر: چون مدل اعداد را برمیگرداند و نه متن، توکنهای خروجی رایگان هستند.
- عدم نیاز به تجزیه (Parsing): پاسخ در قالبی ساختاریافته میرسد که مستقیماً با الزامات کد برنامه سازگار است. هیچ نثری برای تجزیه وجود ندارد و نیازی به پاکسازی دادهها نیست.
- اطمینان کالیبرهشده: امتیاز ۰.۷ واقعاً نشاندهنده یک احتمال ریاضی است. این به توسعهدهندگان اجازه میدهد آستانههای دقیقی برای برچسبگذاری تعیین کنند. عبارت «اگر حداقل ۰.۷ بود برچسب بزن» اکنون معنای ریاضی واقعی دارد.
- پردازش موازی: چندین برچسب را میتوان در یک پاس درخواست ارزیابی کرد، بهجای اینکه برای هر کدام پرامپتهای متوالی فرستاد. سه برچسب در واقع سه سؤال در یک درخواست هستند که بهطور موازی پاسخ داده میشوند.
مورد پژوهی: اپلیکیشن Todo
برای اثبات این ادعا، از یک اپلیکیشن مدیریت کارهای روزمره (Todo) استفاده شد که با Next.js ساخته شده و از Postgres به عنوان پایگاهداده استفاده میکند و قابلیت جستوجوی معنایی دارد. این پروژه بر اساس پیادهسازی قبلی جستوجوی معنایی در همین اپلیکیشن بنا شده است.
هدف این بود که هر یادداشت بهطور خودکار در دستههای «خواربار»، «کارهای خانه» یا «کاری» قرار بگیرد بدون اینکه کاربر دخالتی کند. سیستم بهگونهای طراحی شده است که کاربر مجبور نباشد هیچ برچسبی را بهصورت دستی انتخاب کند.
مثالهایی از طبقهبندیهای مورد نظر:
- «خرید نان و تخممرغ» $
ightarrow$ خواربار - «شستن ظرفها» $
ightarrow$ کارهای خانه - «آماده کردن اسلایدها برای جلسه دوشنبه» $
ightarrow$ کاری - «تمدید پاسپورت» $
ightarrow$ هیچکدام از موارد فوق
جزئیات پیادهسازی
برای استقرار این سیستم در محیط عملیاتی، فرآیند از یک خط لوله (Pipeline) مشخص پیروی میکند:
گام ۱: بهروزرسانی طرح پایگاهداده
پایگاهداده باید مکانی برای ذخیره نتایج داشته باشد. از یک Migration برای افزودن ستون tags به جدول todos استفاده میشود:alter table todos add column if not exists tags text[];
این ستون nullable است، به این معنی که اگر طبقهبندی با شکست مواجه شود، یادداشت صرفاً بدون برچسب میماند. برای کسانی که از ابتدا شروع میکنند، میتوان از فایل migrations/reset.sql برای بازسازی کل جدول استفاده کرد، هرچند این کار تمام یادداشتهای موجود را حذف میکند.
گام ۲: تعریف برچسبها به صورت سؤال
برچسبها به صورت سؤالات بله/خیر به زبان طبیعی تعریف میشوند که مدل آنها را میخواند. مدل سؤال را مستقیماً میخواند، بنابراین باید بهگونهای نوشته شود که انگار از یک انسان سؤال میپرسید. در کد منبع، اینها به این صورت تعریف شدهاند:
- خواربار: «آیا این مورد مربوط به خرید غذا، نوشیدنی یا لوازم خانه از یک فروشگاه یا بازار است؟»
- کارهای خانه: «آیا این یک کار است که در خانه یا اطراف آن انجام میشود، مانند نظافت، لباسشویی، ظرفشویی، آشپزی، تعمیرات یا بیرون بردن زبالهها؟»
- کاری: «آیا این مورد به یک شغل یا حرفه مربوط است، مانند جلسات، گزارشها، ایمیلها به همکاران یا ضربالاجلها؟»
در یک اپلیکیشن در سطح تولید (Production-grade)، این برچسبها معمولاً در جدول جداگانهای به نام labels قرار میگیرند و از یک جدول رابط (Join table) برای اتصال به todos استفاده میشود تا کاربران بتوانند نام آنها را تغییر داده و مدیریت کنند.
گام ۳: اجرای درخواست تصمیمگیری
برنامه «وضعیت» (عنوان یادداشت) و سؤالات را به مدل typesafe/jev-1.14 از طریق نقطه اتصال API OpenRouter در آدرس https://openrouter.ai/api/alpha/decisions ارسال میکند.
مدل Jev از انواع مختلف سؤالات پشتیبانی میکند. در حالی که نوع «choice» دقیقاً یک گزینه را انتخاب میکند، نوع «noul» به یک سؤال بله/خیر با یک احتمال پاسخ میدهد. چون یک یادداشت میتواند همزمان هم «خواربار» و هم «کارهای خانه» باشد (مثلاً «خرید مایع ظرفشویی») یا هیچکدام نباشد، هر برچسب در یک درخواست، noul مخصوص به خود را دریافت میکند.
برای یادداشتی مثل «خرید مایع ظرفشویی»، درخواست شامل سه سؤال مجزای نوع noul است. مدل برای هر کدام یک احتمال برمیگرداند:
- خواربار: ۰.۹۶
- کارهای خانه: ۰.۹۲
- کاری: ۰.۰۹
با استفاده از یک TAG_THRESHOLD (آستانه برچسب) برابر با ۰.۷، کد این نتایج را فیلتر میکند. چون هر دو مورد خواربار و کارهای خانه بالای ۰.۷ هستند، یادداشت هر دو برچسب را دریافت میکند. پسپردازش صرفاً یک فیلتر ساده روی کلیدهای پاسخ است. مقدار ۰.۷ عددی است که با بررسی چشمی تعدادی از یادداشتها انتخاب شده است؛ بالا بردن این عدد باعث کاهش برچسبهای اشتباه میشود اما احتمال از دست دادن برچسبهای درست را زیاد میکند و پایین آوردن آن اثر معکوس دارد.
گام ۴: تضمین تابآوری سیستم
به دلیل اینکه فراخوانی AI معمولاً چند صد میلیثانیه زمان میبرد، این عملیات قبل از درج در پایگاهداده اجرا میشود. این کار تضمین میکند که یادداشت با برچسبهای متصل به خود ذخیره شود. برای جلوگیری از اینکه AI باعث شکست در قابلیت اصلی (ایجاد یادداشت) شود، چندین حفاظ پیاده شده است:
- محدودیت زمانی (Timeout): یک
AbortSignal.timeout(3_000)فراخوانی را پس از ۳ ثانیه قطع میکند تا کاربر منتظر نماند. اگر ارائهدهنده کند باشد، کاربر حداکثر ۳ ثانیه بیشتر از حالت عادی منتظر میماند. - مدیریت خطا: اگر ارائهدهنده در دسترس نباشد یا خطا برگرداند، تابع
classifyخطایی را پرتاب میکند که توسط سیستم گرفته و ثبت (Log) میشود. - مدیریت اعتبار: اگر کلید OpenRouter اعتبارش تمام شده باشد، API خطای ۴۰۲ برمیگرداند که به عنوان یک خطای استاندارد مدیریت میشود.
- تخریب تدریجی (Graceful Degradation): در هر سناریوی شکست، یادداشت صرفاً با مقدار
tags = nullدرج میشود. کاربر همچنان یادداشت خود را دریافت میکند، فقط بدون برچسب میماند. هیچ نشانهای در صفحه نمایش داده نمیشود که برچسبگذاری شکست خورده است و دمو تلاشی برای تلاش مجدد (Retry) نمیکند.
گام ۵: بهرهبرداری از برچسبها
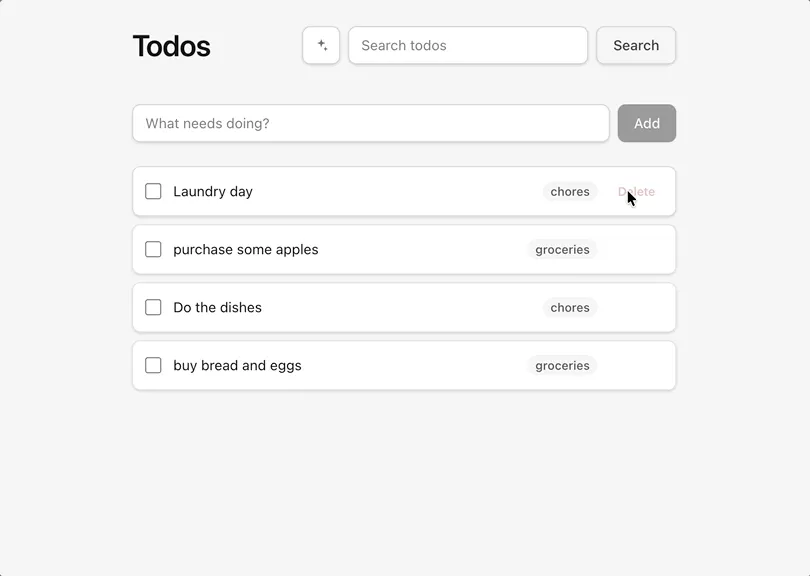
پس از ذخیره، برچسبها مانند یک ستون معمولی دیتابیس با آنها برخورد میشود. در دمو، هر یادداشت برچسبهای خود را به صورت تراشههای کوچک (Chips) در کنار عنوان نمایش میدهد. یادداشتهایی با آرایه خالی یا null چیزی نشان نمیدهند. چون API لیست یادداشتها از قبل ستون tags را برمیگرداند، هیچ درخواست اضافی برای نمایش آنها نیاز نیست.
بنچمارک عملکرد
در یک بنچمارک غیررسمی (Trust me bro) شامل ۸ وظیفه که هر کدام ۳ بار روی یک لپتاپ از طریق Wi-Fi اجرا شدند، مدل Jev 1.14 با مدل gpt-5.6-luna شرکت OpenAI که از یک طرح JSON سختگیرانه استفاده میکرد، مقایسه شد. نتایج تفاوت فاحشی را در بهرهوری نشان داد:
- تأخیر: پاسخ Jev تقریباً ۳۰۰ میلیثانیه بود، در حالی که مدل GPT حدود ۱,۰۰۰ میلیثانیه زمان برد. این بهینهسازی در زمان پاسخدهی یادآور مکانیزمهای فیلتر سختگیرانه در Gemma 4 است که تأخیر را در دستگاههای محلی به ۸۵ میلیثانیه رساند.
- هزینه: هزینه Jev تقریباً ۰.۰۱۶ دلار به ازای هر ۱,۰۰۰ یادداشت بود، در مقابل ۰.۰۴۴ دلار برای مدل چت.
- صحت: هر دو مدل برچسبهای یکسانی را انتخاب کردند و هیچکدام فرمت خروجی را به هم نزدند، اما فقط Jev یک اندازهگیری واقعی از میزان اطمینان ارائه داد.
تحلیل تحریریه
این تغییر رویکرد، نشاندهنده حرکتی به سمت «بهینهسازی اندازه» (Right-sizing) اجزای هوش مصنوعی است. سالهاست که صنعت بهطور پیشفرض از قدرتمندترین مدلهای چت موجود برای هر کاری استفاده میکند، فارغ از اینکه وظیفه چیست. این موضوع باعث ایجاد یک «مالیات پنهان» از تأخیرهای غیرضروری و هزینههای محاسباتی بالا شده است.
برای توسعهدهندگان عملی، این یعنی دستور «افزودن هوش مصنوعی» دیگر لزوماً به معنای «افزودن یک چتبات» نیست. با انتخاب مدلها بر اساس شکل پاسخ مورد نیاز — بردار معنایی (Embeddings) برای جستوجو، مدلهای تصمیمگیر برای برچسبگذاری و مدلهای چت برای تولید نثر — مهندسان میتوانند سیستمهایی بسازند که هم پایدارتر باشند و هم در مقیاس بالا بهطور قابل توجهی ارزانتر تمام شوند. با این حال، رقابت در این حوزه شدید است و برخی بنچمارکها نشان میدهند که مدلهای طبقهبندی پیشآموزشدیده در برخی موارد از مدلهای تصمیمگیر پیشی گرفتهاند.
در گام بعدی، توسعهدهندگان باید طبقهبندیهای فعلی خود را که بر پایه پرامپتهای چت هستند ارزیابی کنند تا ببینند کجا یک مدل تصمیمگیر مبتنی بر احتمال میتواند خطاهای تجزیه متن را حذف کرده و صورتحسابهای API را کاهش دهد.
گام بعدی شما
- طبقهبندیهای فعلی خود را که بر پایه پرامپتهای چت هستند بررسی کنید و مواردی که خروجی آنها فقط یک برچسب است را شناسایی کنید.
- مدلهای تصمیمگیر را برای حذف لایههای پیچیده تجزیه متن (Parsing) در خط لوله دادههای خود تست کنید.
- آستانه اطمینان (Confidence Threshold) را برای کاهش نرخ خطای برچسبگذاری در محیط عملیاتی تنظیم کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو