اگر امروز برای هر تصمیم کوچک در یک عامل هوش مصنوعی — از انتخاب ابزار گرفته تا ارزیابی ریسک — به مدلهای زبانی سنگین تکیه میکنید، با یک دیوار مقیاسپذیری برخورد کردهاید. شرکت TypeSafe با معرفی مدل Jev، این پارادایم را به چالش میکشد تا شهود سریع را از استدلال کند تفکیک کند.
بیشتر گردشکارهای عاملمحور (Agentic) فعلی از یک مدل مولد واحد بهعنوان «مغز» برای تمام مراحل استفاده میکنند. در این ساختار، مدل زبانی ابزار را انتخاب میکند، نتایج را ارزیابی میکند، تصمیم میگیرد که آیا باید ادامه دهد و در نهایت پاسخ را تولید میکند. طبق گزارشهای فنی، این فرآیند انعطافپذیر است اما با افزایش تعداد فراخوانیها، حجم زمینه (Context) و تکرار تلاشها (Retries)، تأخیر و هزینهای عظیم ایجاد میکند. هر تصمیم اضافی، زمان و هزینهای را پیش از رسیدن پاسخ مفید به کاربر میافزاید.
صنعت اکنون به سمت معماری «هوش تفکیکشده» حرکت میکند که در آن وظایف شناختی مختلف توسط کلاسهای متفاوتی از مدلها مدیریت میشوند. مدل Jev پیشنهاد میکند که یک عامل در هر نقطه نیاز به یک سطح از هوش ندارد. در عوض، توسعهدهندگان باید از مدلهایی برای «قضاوتهای محدود» (Bounded Judgments) استفاده کنند که مجموعه پاسخهای آنها تعریفشده است و مدلهای مولد را برای استدلالهای باز و تولید زبان رزرو کنند.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی استنتاج در مدلهای کوچک اشاره کردیم، تفکیک لایههای تصمیمگیری کلید کاهش تأخیر است. Jev بر اساس مفهوم تفکر سیستم ۱ (سریع و غریزی) و سیستم ۲ (کند و منطقی)، بهعنوان لایه سیستم ۱ عمل میکند. در حالی که یک مدل سیستم ۲ مانند GPT-4 یا Claude استدلالهای پیچیده و باز را مدیریت میکند، Jev تصمیمات محدود و تکراری را بر عهده میگیرد که نرمافزار میتواند مستقیماً آنها را مصرف کند. این رویکرد از انباشت تأخیر در «حلقه عامل» (Agent Loop) پیش از مشاهده نتیجه توسط کاربر جلوگیری میکند.
مکانیسم قضاوتهای محدود
مدل Jev که در سپتامبر ۲۰۲۶ عرضه شد، نخستین مدل سیستم ۱ شرکت TypeSafe است. این مدل متن تولید نمیکند؛ بلکه یک وضعیت (مانند دادههای کاربر یا پیام پشتیبانی) را میپذیرد و پاسخهای تایپشدهای را همراه با احتمالات مربوطه برمیگرداند. بر اساس مستندات رسمی TypeSafe، این مدل بر سه رکن اصلی استوار است:
- انتخاب (Choice): گزینش از میان مجموعهای از گزینههای پیشتعریفشده.
- امتیاز (Score): رتبهبندی یک مورد بر اساس یک معیار مرتبشده.
- نول (Noul): تخمین احتمال درست بودن یک گزاره خاص.
این ساختار اجازه میدهد سیستم چندین پرسش مستقل را در یک درخواست واحد بپرسد. برای مثال، یک عامل خدمات مشتری میتواند بهطور همزمان تیم مسیریابی صحیح، فوریت پاسخ و اینکه آیا درخواست استرداد وجه داده شده است یا خیر را تعیین کند. در حالی که یک مدل چت میتوانست این سه وظیفه را انجام دهد، اما باید نتایج را به صورت یک پاسخ ساختاریافته ارائه میکرد. در مقابل، Jev فقط آن تصمیمات محدود را ارائه میدهد و تصمیمگیری درباره اقدام بعدی را بر اساس این نتایج به کد اپلیکیشن میسپارد.
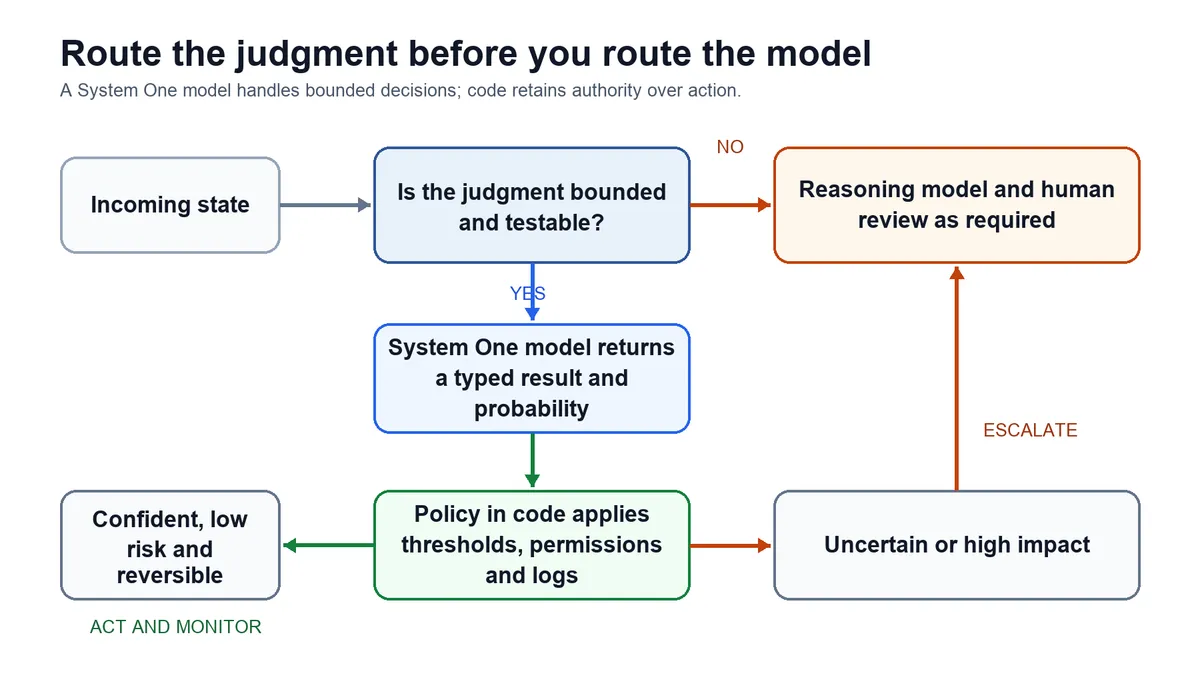
چرخش معماری: مدل در برابر سیاست
نوآوری کلیدی در اینجا نه اندازه مدل، بلکه مرز بین «تخمین» و «سیاست» است. اکثر بحثهای حوزه هوش مصنوعی مدلهای بزرگ را با مدلهای کوچک مقایسه میکنند، اما Jev مرز متفاوتی را پیشنهاد میدهد: برخی مراحل شامل تولید زبان هستند، در حالی که مراحل دیگر قضاوتهای محدودی هستند که نرمافزار میتواند آنها را مصرف کند.
در این معماری، مدل یک تخمین ارائه میدهد (مثلاً «۸۵٪ احتمال ریسک بالا») و نرمافزار سیاست تجاری را اعمال میکند. اگر احتمال تخمینشده از یک آستانه (Threshold) آزمایششده فراتر رود و اقدام مورد نظر کمریسک و بازگشتپذیر باشد، گردشکار ادامه مییابد. اما در صورت وجود عدم قطعیت یا پیامدهای جدی، سیستم نظارت انسانی را درخواست میکند. در اینجا یک مدل استدلالی (Reasoning Model) ممکن است در بررسی عدم قطعیت کمک کند، اما جایگزین تأیید انسانی نمیشود.
این رویکرد با ابزارهای مسیریابی مدل مانند RouteLLM متفاوت است. در حالی که RouteLLM بین یک مدل زبانی قوی و ضعیف برای تعادل هزینه و کیفیت انتخاب میکند، Jev قضاوتهای محدودی تولید میکند که کد میتواند مستقیماً از آنها استفاده کند. این قضاوتها میتوانند هم از مسیریابی مدل و هم از سایر تصمیمات داخلی عامل پشتیبانی کنند. این امر باعث میشود آستانههای ایمنی، مجوزها و قوانین تجاری در کد باقی بمانند، نه در داخل یک پرامپت.
چرا حلقههای عامل برای این مدلها مناسباند؟
حلقههای عامل بهدلیل نیاز به تصمیمات کوچک متعدد پس از درخواست کاربر و پیش از خروجی نهایی، برای این قضاوتها ایدهآل هستند. این تصمیمات شامل موارد زیر است:
- تصمیمگیری درباره اینکه از کدام ابزارها استفاده شود.
- رتبهبندی رکوردهای بازیابیشده.
- ارزیابی ریسک.
- تعیین اینکه آیا شواهد کافی برای توقف حلقه وجود دارد یا خیر.
به دلیل تکرار این مراحل، تأخیرها در طول زمان انباشته میشوند. LangChain پیش از این Jev را برای مدیریت مسیریابی مدل و بررسی فراخوانی ابزارها ادغام کرده است. در این چیدمان، Jev لبههای گردشکار را مدیریت میکند و مدل مولد بر برنامهریزی و تولید محتوا تمرکز میکند. این یک مورد استفاده واقعی است که در آن Jev مدلهای چندمنظوره را تکمیل میکند، نه اینکه جایگزین آنها شود.
علاوه بر این، موازیسازی پرسشها نحوه تجزیه وظایف را تغییر میدهد. توسعهدهندگان میتوانند یک دستور مبهم را به چندین پرسش ارزیابی مجزا تبدیل کنند. این کار میتواند منجر به توالی بسیار کوتاهتری از فراخوانیهای مدل و گردشکاری شود که ارزیابی آن با استفاده از منطق تجاری صریح برای ترکیب قضاوتها آسانتر است.
یکپارچهسازی و عملکرد
شرکت TypeSafe گزارش میدهد که Jev به زمان پاسخدهی بین ۷۰ تا ۵۰۰ میلیثانیه دست یافته است. این شرکت ادعا میکند در ارزیابیهای داخلی به صرفهجویی قابلتوجهی در هزینه و بهبود سرعت رسیده است، هرچند اشاره میکند که این دستاوردها ممکن است در سقف انتظارات دنیای واقعی باشند.
باید توجه داشت که تستهای عمومی فعلی از احتمالات مرجع مدلهای پیشرو (Frontier Models) استفاده میکنند، نه برچسبهای داده مرجع (Ground-truth). بنابراین، نتایج برای شکلدهی به فرضیات مناسباند اما جایگزین تست مستقل روی حجم کاری واقعی نمیشوند. علاوه بر این، Jev باید چیزی بیش از انطباق با طرح (Schema Compliance) را نشان دهد؛ اثربخشی آن به کاهش تأخیر کلی سیستم، تولید تخمینهای احتمالی مفید و پایداری در ورودیهای متغیر بستگی دارد.
ریسک خطاهای «تایپ-سیف»
توسعهدهندگان باید بین «انطباق با طرح» (Schema Compliance) و «صحت معنایی» تمایز قائل شوند. چون فضای خروجی Jev پیشتعریفشده است، نمیتواند پاراگرافی غیرقابل تجزیه یا فیلدی ساختگی برگرداند، اما همچنان میتواند «با اطمینان اشتباه کند»؛ یعنی سطح ریسک یا دپارتمان غلطی را اختصاص دهد در حالی که خروجی از نظر فنی کاملاً تایپ-سیف است.
TypeSafe تأکید میکند که کالیبراسیون (Calibration) در گروههای پیشبینی اندازهگیری میشود، نه در موارد تکی. این یعنی تیمها باید پیش از استقرار در گردشکارهای حساس، بهطور مستقل بررسی کنند که آیا احتمالات پیشبینیشده با نتایج مشاهدهشده در دادههای خاص خودشان مطابقت دارد یا خیر.
استراتژی پیادهسازی
برای تیمهایی که این رویکرد را میپذیرند، توصیه میشود ابتدا از تصمیمات حساس مانند تأییدات پزشکی یا تعلیق حسابها اجتناب کنند و بر وظایف رایج و بازگشتپذیر تمرکز نمایند:
- مسیریابی تیکتها.
- دستهبندی اسناد.
- انتخاب مدل.
- تضمین کیفیت کمریسک.
برای تشخیص کارآمدی این روش، توسعهدهندگان باید چهار پرسش را پاسخ دهند:
۱. آیا خروجی تعداد محدودی پاسخ احتمالی دارد؟
۲. آیا میتوانید معیارهای قضاوت را بهطور شفاف بیان کنید؟
۳. آیا نتایج قابل اندازهگیریاند؟ (پیشبینی، احتمال، اقدام و نتیجه را ردیابی کرده و کالیبراسیون را مرتباً بررسی کنید).
۴. آیا در صورت شکست فرآیند خودکار، برنامه جایگزینی دارید؟ (تعیین کنید چه زمانی از مدل استدلالی استفاده شود یا انسان درگیر شود).
تحلیل باید کل گردشکار را با معیارهایی چون دقت تصمیم، نرخ امتناع یا ارجاع به انسان، زمان کل پردازش پایان-به-پایان، هزینه هر وظیفه موفق و تأثیر اشتباهات بسنجد. تستها باید در شرایط نامساعد، از جمله تغییر در واژگان، حذف دادههای مرتبط، دستههای کمتکرار و ورودیهای خصمانه اجرا شوند؛ زیرا یک طبقهبند بهینه که هزینههای پاییندستی را افزایش دهد، بهینهسازی واقعی نیست.
درس بلندمدت
اگر Jev موفق شود یا جایگزین شود، پرسش معماری اصلی باقی میماند: آیا لازم است هر تصمیم ماشینمحور در قالب زبان تولیدشده رندر شود؟ در بسیاری از موارد، پاسخ «خیر» است.
در محیط عملیاتی، یک سامانه میتواند از مدلهای مولد برای تفسیر، برنامهریزی و توضیح استفاده کند و از مدلهای تصمیمگیر محدود برای مسیریابی، امتیازدهی و کنترل دسترسی. در این حالت، کد همچنان مقادیر آستانه و مجوزها را دیکته میکند و انسانها مسئول تصمیماتی میمانند که بر زندگی دیگران اثر میگذارد.
این همان روش ساخت سامانههای قابلاعتماد است. پیشرفت بعدی در عملکرد عاملها احتمالاً به انتخاب دقیق نقاطی بستگی دارد که تفکر در آنها زمانبر است، در حالی که سایر بخشها تصمیماتی سریع میگیرند یا اصلاً نیازی به اقدام ندارند.
گام بعدی شما
- شناسایی نقاط کور در حلقه عاملهای خود که در آنها مدلهای زبانی صرفاً برای تصمیمات Yes/No یا دستهبندی ساده استفاده میشوند.
- تست جایگزینی یک مدل مولد با یک طبقهبند (Classifier) سریع برای کاهش تأخیر در لایههای مسیریابی.
- تعریف آستانههای احتمالی (Probability Thresholds) در کد برای تفکیک تصمیمات خودکار از نظارت انسانی.
اما تأثیر این معماری بر هزینه استنتاج در مقیاس میلیونی حتی تکاندهندهتر است — به تحلیل ما دربارهی بهینهسازی GPUها در لایههای استنتاج مراجعه کنید.



گفتگو