اگر برای کاهش هزینههای API عاملهای کدنویس خود، خروجی ابزارها را خلاصه میکنید، احتمالاً دارید پولتان را دور میریزید. در مدل DeepSeek V4 Pro، تلاش برای حذف چند هزار توکن، اغلب منجر به هزینهای میشود که بسیار بیشتر از مقدار صرفهجویی شده است. یک سری آزمایشها که در ۲۱ ژوئیه ۲۰۲۶ انجام شد، نشان میدهد که هزینه بازنویسی یک پرامپت کششده (Cached Prompt) اغلب بر صرفهجویی حاصل از حذف توکنها غلبه میکند.
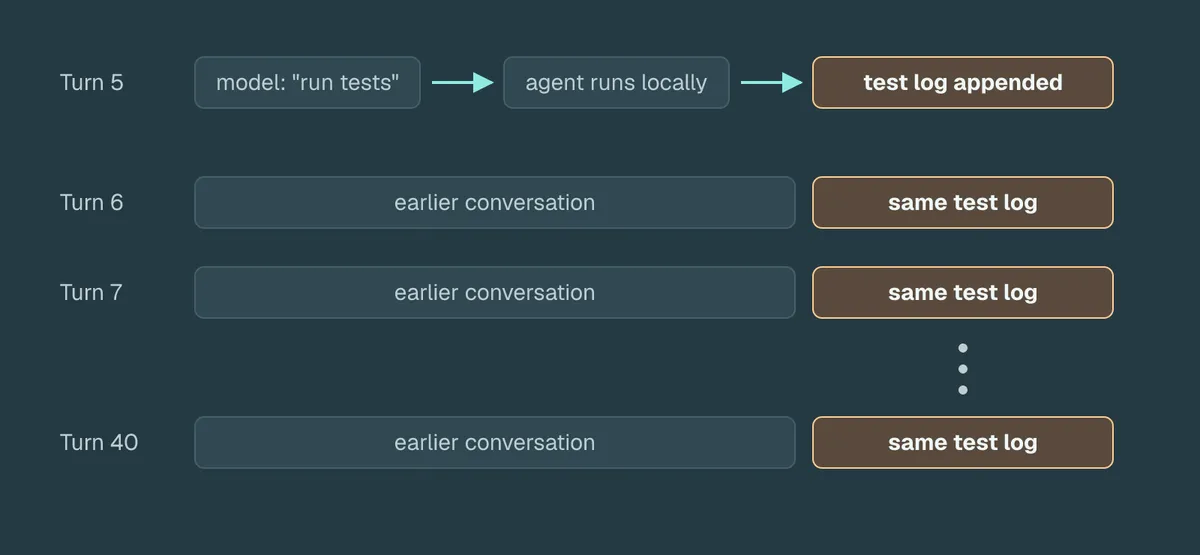
عاملهای کدنویس معمولاً در هر نوبت، کل تاریخچه گفتگو شامل تکتک نتایج ابزارها را مجدداً ارسال میکنند. مدل پشت این عامل نمیتواند مستقیماً فایلها را بخواند یا دستورات را اجرا کند؛ بلکه درخواست فراخوانی ابزار میدهد، عامل آن را بهصورت محلی اجرا کرده و خروجی را به تاریخچه گفتگو اضافه میکند. در هر درخواست بعدی، عامل کل گفتگوی قابل مشاهده را به مدل بازمیگرداند. هر درخواست، لاگها را دوباره بهعنوان ورودی ارسال میکند. این موضوع باعث ایجاد صورتحسابهای سنگین ورودی میشود، زیرا با پر شدن پنجره متنی (Context Window)، خروجیها در هر نوبت دوباره محاسبه و صورتحساب میشوند. این مسئله بهطور خاص برای چارچوبهایی (Harnesses) صادق است که تاریخچه را از طریق APIهای سبک Chat Completions یا Messages ارسال میکنند. در مواردی که ارائهدهنده مالک تاریخچه است (مثلاً OpenAI Responses با استفاده از previous_response_id)، ابزاری مثل Torana نمیتواند موارد قبلی را بازنویسی کند و فشردهسازی بومی ارائهدهنده یک مکانیسم مجزا است.
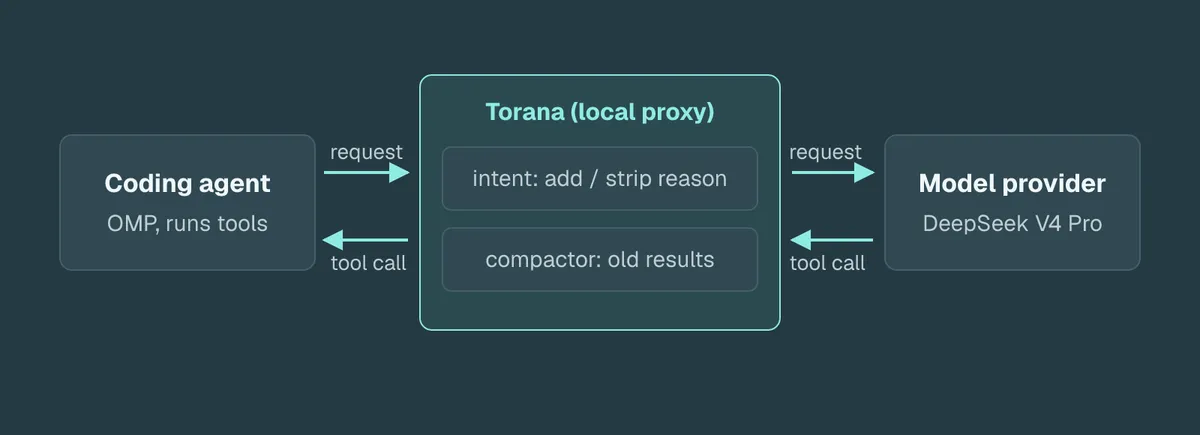
در اینجاست که Torana، یک چارچوب مبتنی بر افزونه، تلاش کرد این فرآیند را خودکار کند. هدف این بود که از یک مدل ارزانتر برای خلاصهسازی خروجی ابزارها پیش از آنکه مدل اصلی یا همان «مغز» آنها را بخواند، استفاده شود. اما اقتصاد جدید قیمتگذاری API، ریاضیات این موضوع را تغییر داده است. این رویکرد در تضاد با برخی استراتژیهای سنتی است که فشردهسازی زمینه را راهکاری برای کاهش ۵۰ درصدی هزینهها میدانستند، اما در مدلهای جدید با کشینگ تهاجمی، نتایج متفاوت است.
معماری فشردهسازی
برای اینکه خلاصهها مفید باشند، سیستم باید بداند مدل دقیقاً به چه چیزی اهمیت میدهد. Torana یک «افزونه قصد» (Intent Plugin) پیاده کرد که تعاریف ابزار را تغییر میدهد تا برای هر فراخوانی ابزار، یک دلیل کوتاه درخواست شود. این دلیل پیش از آنکه چارچوب فراخوانی را ببیند حذف میشود، بنابراین عامل هرگز آن را نمیبیند، اما فشردهساز از این قصد ثبتشده استفاده میکند تا تصمیم بگیرد چه بخشهایی را نگه دارد. فیلد «دلیل» به طرحهای (Schemas) ابزاری که ارسال میشوند اضافه شده و از فراخوانیهای ابزاری که بازمیگردند حذف میشود.
آنچه شکست خورد: اولین تلاش
فرآیند توسعه یک شکست بحرانی را در اولین تلاش آشکار کرد. اولین فشردهساز، هر خروجی ابزاری که بیش از ۲,۰۰۰ کاراکتر بود را خلاصه میکرد. این کار بلافاصله عاملهای کدنویسی را مختل کرد (issue #166). از آنجا که عاملها برای ویرایش فایلها به جستجو و جایگزینی دقیق (Exact Search-and-Replace) متکی هستند، خلاصههای زبان طبیعی باعث شد عاملها جایگاه خود را در فایل گم کنند. وقتی خواندن یک فایل بهصورت خلاصه بازگشت، ویرایشها دیگر با متن مطابقت نداشتند. عامل دوباره فایل را میخواند، دوباره شکست میخورد و در یک حلقه تکرار گیر میکرد که به جای صرفهجویی، توکنهای بیشتری را میسوزاند. این چالشها نشان میدهد که چگونه عاملهای کدنویس میتوانند بهطور ناخواسته هزینهی توکن و بدهی فنی را افزایش دهند اگر ابزارهای بهینهسازی بهدرستی پیادهسازی نشوند.
استراتژی اصلاحشده
برای رفع این مشکل، طراحی دومی پیاده شد. این نسخه بهصورت پیشفرض همه چیز را دقیق نگه میدارد. سیاستها بهصورت ترتیبی، بر اساس اولین تطبیق و بدون حساسیت به حروف بزرگ و کوچک (Case-insensitive) اجرا میشوند. ابزارهایی که با هیچ سیاستی تطبیق نیابند، هرگز تغییر نمیکنند.
سیاستهای فشردهسازی
- حالت دقیق (Exact Mode): خواندن فایلها، تغییرات (Mutations)، Diffها، دستورات شکستخورده، خطاها، Stack Traceها و خروجیهای غیرصفر (Non-zero exits) بهاجبار دقیق میمانند. این کار پایداری عامل را تضمین کرده و از حلقههای بازخوانی که در تلاش اول دیده شد، جلوگیری میکند. خواندن منابع (Source reads) در پیکربندی پذیرفته شده اما در عمل بهصورت دقیق رفتار میکنند.
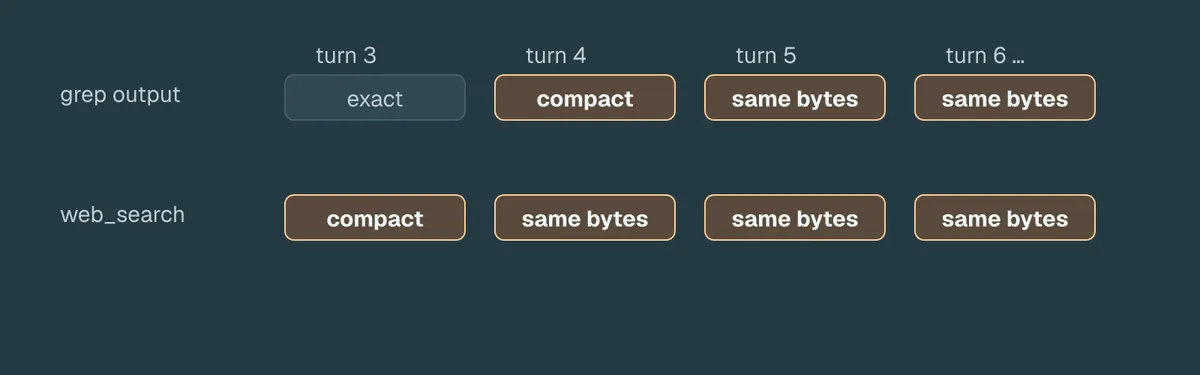
- حالت قطعی (Deterministic Mode): بخشهای محدود ابتدا و انتهای شواهد را به همراه اندازه، SHA-256، تعداد بایتهای حذفشده و یک دستور اجرای مجدد (Rerun instruction) نگه میدارد. با فعال بودن
first_passاین حالت از اولین باری که مدل خروجی را میبیند اعمال میشود تا از بازنویسی پرامپت در مراحل بعدی جلوگیری شود. نسخههای فشردهی کششده در درخواستهای بعدی همان بایتها را حفظ میکنند. - حالت کلیدواژه (Keyword Mode): توسط
keyword_compactorاجرا میشود و تنها خطوطی را نگه میدارد که با قصد اولیه مطابقت دارند، اما این کار تنها پس از آنکه مدل حداقل یکبار نسخه دقیق را دیده باشد، انجام میشود. - حالت مدل-محور (Model-Gated Mode): توسط
compactorاجرا میشود و از یک خلاصه هدایتشده توسط قصد از طریق یک مدل ارزانتر (DeepSeek V4 Flash) استفاده میکند. این حالت تنها پس از حداقل یکبار مواجهه دقیق و تنها زمانی فعال میشود که یک «دروازه اقتصادی» پیشبینی کند که صرفهجویی خالص حاصل خواهد شد.
تنظیمات آزمایش و متدولوژی
این آزمایش در ۲۱ ژوئیه ۲۰۲۶ با استفاده از OMP 16.2.9 بهعنوان چارچوب عامل کدنویس انجام شد. مدل هدف DeepSeek V4 Pro از طریق نقطه انتهایی https://api.deepseek.com/beta (در قالب سازگار با OpenAI) بود. خلاصهساز برای بازوی مدل-محور، DeepSeek V4 Flash در همان نقطه انتهایی بود. Torana روی کامیت e09d225 از PR #179 اجرا میشد. این PR شاخه آزمایشی بود و افزونهها بعدها به torana-plugins منتقل شدند.
قیمتگذاری و بازوهای آزمایش
در این تست از قیمتهای تاریخی جولای ۲۰۲۶ (به ازای هر میلیون توکن) استفاده شد. برای V4 Pro، قیمت برخورد با حافظه (Cache-hit) مبلغ $۰.۰۰۳۶۲۵ بود که تنها ۰.۸۳٪ قیمت عدم برخورد (Cache-miss) یعنی $۰.۴۳۵ بود.
جدول قیمتها (جولای ۲۰۲۶):
DeepSeek V4 Pro: ورودی (Miss) $۰.۴۳۵ | برخورد حافظه $۰.۰۰۳۶۲۵ | خروجی $۰.۸۷
DeepSeek V4 Flash: ورودی (Miss) $۰.۱۴ | برخورد حافظه $۰.۰۰۲۸ | خروجی $۰.۲۸
بازوی کنترل (Control Arm): Torana در مسیر درخواست بدون هیچ افزونه فشردهسازی.
بازوی قطعی (Deterministic Arm): استفاده از زنجیره
schema_translator$
ightarrow$intent$
ightarrow$keyword_compactor. پیکربندی شاملread*وview*بهصورت دقیق،web_searchبهصورت قطعی (با دستور اجرای مجدد برای بازیابی تمام نتایج) وgrep*بهصورت کلیدواژه بود. این تنظیمات باconfig.dogfood.jsonمطابقت داشت.بازوی مدل-محور (Model-Gated Arm): استفاده از زنجیره
schema_translator$
ightarrow$intent$
ightarrow$compactor. از V4 Flash بهعنوان خلاصهساز باexpected_applications: 6استفاده شد. خروجیهای شبیه به Grep واجد شرایط خلاصهسازی مدل بودند. از آنجا که DeepSeek هزینه جداگانهای برای نوشتن در کش ندارد، نرخ نوشتن در کش برابر با نرخ ورودی قرار داده شد.
پروتکل و حفاظها
طراحی شامل پنج وظیفه مخزنی (معماری، اقتصاد، بررسی رگرسیون، ایمنی — شامل تمرین تغییرات، پچها، خطاها و خروجیهای غیرصفر — و یک وظیفه استرس) بود که با ۵ تکرار در هر سه بازو اجرا شد و در مجموع ۷۵ جلسه را تشکیل داد. ترتیب بازوها در هر بلوک جفتشده (وظیفه $ imes$ تکرار) بهصورت تصادفی بود.
برای جلوگیری از هزینههای خارج از کنترل، حفاظهایی تعریف شد تا جلسات را در شرایط زیر متوقف کند:
- بعد از ۲۵ درخواست
- ۱۵۰ ثانیه بدون پیشرفت
- سه قصد ابزار معنایی یکسان
- سقف هزینه کل ۱۵ دلار
هزینه واقعی کل برای این آزمایش ۱.۹۰ دلار بود. هزینه از روی توکنهای Cache-miss، Cache-hit و خروجی گزارششده توسط ارائهدهنده، بهعلاوه استفاده از خلاصهساز محاسبه شد.
نتایج آزمایش
نتایج غافلگیرکننده بود. بازوی کنترل (بدون فشردهسازی) میانگین هزینهای معادل ۰.۰۲۴۸۲۰ دلار در هر جلسه با نرخ برخورد حافظه ۹۲.۲۳٪ داشت.
عملکرد بر اساس بازوها
- بازوی قطعی: در ۱۵ مورد از ۲۵ اجرا، خروجیها تغییر کردند و ۴,۸۰۹,۱۶۴ بایت از طریق ۳۹۹ کاربرد (۳۴ تغییر جدید، ۳۶۵ استفاده مجدد از کش) حذف شدند. با این حال، میانگین صرفهجویی جفتشده تنها $۰.۰۰۰۵۲۴ (حدود ۲.۱٪) بود، با فاصله اطمینان ۹۵٪ از -$۰.۰۰۳۷۱۴ تا +$۰.۰۰۳۷۲۵. میانگین صرفهجویی در واقع منفی (-$۰.۰۰۰۰۵۵۹) بود و تنها در ۱۳ مورد از ۲۵ جفت، ارزانتر تمام شد. میانگین صرفهجویی توکنهای ورودی جفتشده ۲۹,۱۱۷ توکن بود.
- بازوی مدل-محور: تنها چهار اجرا خروجی را تغییر دادند که همگی از طریق قانون قطعی بود (۶ تغییر، ۷۹ استفاده مجدد). میانگین صرفهجویی جفتشده $۰.۰۰۰۴۷۸ (حدود ۱.۹٪) با میانگین $۰.۰۰۱۵۶۹ بود و در ۱۵ مورد از ۲۵ جفت ارزانتر بود.
در بازوی مدل-محور، بررسی پیشپرواز (Preflight check) هیچ تماسی با خلاصهساز Flash برقرار نکرد. سیستم تشخیص داد که با شش کاربرد مورد انتظار در قیمت Cache-hit دیپسیک، هیچ پیشوند بازنویسیشدهای نمیتواند هزینه Cache-missهای حاصل از آن را جبران کند. توقفهای حلقه (پایان به دلیل سقف درخواستها) در بازوی کنترل و اجراهای بدون تغییر رخ داد که نشاندهنده نوسانات عامل بود و نه اثر فشردهسازی.
میانگین هزینه بر اساس وظیفه
تفاوت در تعداد فراخوانی ابزار و طول پاسخها بر ارزش توکنهای حذفشده از کش غلبه کرد:
- معماری: کنترل $۰.۰۲۶۰۴۰ | قطعی $۰.۰۲۲۹۸۴ | مدل-محور $۰.۰۲۵۹۹۳
- اقتصاد: کنترل $۰.۰۲۴۸۲۰ | قطعی $۰.۰۲۶۷۱۷ | مدل-محور $۰.۰۲۱۷۴۲
- بررسی رگرسیون: کنترل $۰.۰۳۳۶۷۲ | قطعی $۰.۰۳۴۲۷۸ | مدل-محور $۰.۰۳۲۴۱۱
- ایمنی: کنترل $۰.۰۱۷۶۴۰ | قطعی $۰.۰۱۵۱۴۲ | مدل-محور $۰.۰۱۷۲۹۷
- استرس: کنترل $۰.۰۲۲۲۵۶ | قطعی $۰.۰۲۷۲۶۰ | مدل-محور $۰.۰۲۱۵۰۵
مسئله اقتصاد حافظه (Cache Economics)
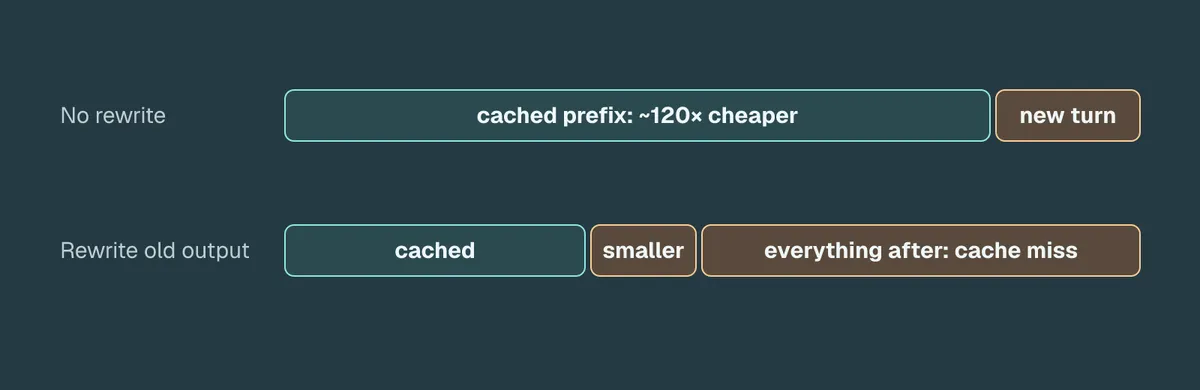
طبق نتایج، حدود ۹۲٪ از توکنهای ورودی در تمام بازوها Cache-hit بودند. در DeepSeek V4 Pro، یک برخورد حافظه تنها ۰.۸۳٪ هزینه یک عدم برخورد را دارد — یعنی تقریباً ۱۲۰ برابر ارزانتر است.
وقتی یک افزونه پیامی قدیمی را برای فشردهسازی بازنویسی میکند، پیشوند پرامپت را از آن نقطه به بعد تغییر میدهد. این کار باعث ابطال کش برای هر چیزی میشود که بعد از آن نقطه قرار دارد. مدل سپس باید قیمت کامل «عدم برخورد با حافظه» را بپردازد تا تاریخچه را بازسازی کند. حذف بایتها تنها زمانی سودمند است که صرفهجویی در نوبتهای بعدی، بیشتر از هزینهی Cache-missهای ایجاد شده باشد. با فاصله قیمتی ۱۲۰ برابری، بایتهای حذفشده ارزش بسیار کمی داشتند. این یک ویژگی از قیمتگذاری DeepSeek است؛ ارائهدهندگانی با قیمتهای گرانتر برای خواندن کش یا بدون سیستم کش، نتایج متفاوتی خواهند داشت.
شرط نقطه سربهسر (Break-Even)
شرط ریاضی برای اینکه فشردهسازی توجیهپذیر باشد عبارت است از: $N > (R \times \max(0, W - C) + S) / (D \times C)$، که در آن:
- $N$ = نوبتهای آینده
- $R$ = بازه کششده بازنویسی شده
- $W$ = نرخ نوشتن/ورودی ارائهدهنده
- $C$ = نرخ خواندن کش
- $D$ = توکنهای حذف شده در هر نوبت آینده
- $S$ = هزینه خلاصهساز
این مدل سادهشده فرض میکند $D \times C$ مثبت است و واحدها یکسان هستند. وقتی ورودیهای اقتصادی موجود نباشند یا سود خالص مثبت نباشد، دروازه هیچ کاری نمیکند که نتیجهای درست است.
تحلیل: کف هزینه جدید
این یافته، فرض بنیادی بهینهسازی عاملها را تغییر میدهد. برای سالها، صنعت بر استراتژیهای «رژیم توکنی» برای صرفهجویی در هزینه و فضای متنی تمرکز داشت. این آزمایش ثابت میکند که در عصر کشینگ تهاجمی پرامپت، تعداد توکنها دیگر محرک اصلی هزینه نیستند. در همین راستا، شرکتهایی مانند انویدیا نیز با معرفی «اتوماسیون منطق کنترل» سعی در بهینهسازی مصرف توکنها از طریق معماریهای متفاوت دارند.
برای توسعهدهندگان، این بدان معناست که ریسک شکستن منطق عامل از طریق خلاصهسازی، در حال حاضر هزینهای بیشتر از خودِ صورتحساب API دارد. «نقطه سربهسر اقتصادی» اکنون بیشتر به قیمت خواندن کش ارائهدهنده بستگی دارد تا طول خروجی ابزار.
محدودیتها و درسها
این مطالعه محدود به یک ارائهدهنده، یک چارچوب، پنج وظیفه، پنج تکرار برای هر وظیفه و قیمتهای جولای ۲۰۲۶ بود. مسیرهای عامل متغیر بود و بسیاری از جلسات درمانی بدون تغییر (no-ops) بودند. چندین مانع فنی برطرف شد:
- برخوردهای حافظه نامرئی: DeepSeek استفاده از کش را بهجای سبک OpenAI، بهصورت
prompt_cache_hit_tokensگزارش میکند. Torana اکنون هر دو را در پاسخهای استریمینگ، JSON و سرویس مدل میخواند. - خطاهای دروازه: یک باگ اولیه، کاندیدای خلاصهسازی بدون کش را بهاشتباه بهعنوان استفاده مجدد از کش برچسب میزد و باعث میشد Torana برای خلاصههای Flash هزینه بپردازد که در نهایت توسط دروازه رد میشدند. کاندیداهای بدون کش اکنون بهعنوان بازنویسی (Rewrite) در نظر گرفته میشوند.
- حلقههای نشانگر: یک تلاش آزمایشی با استفاده از نشانگرهای «بازخوانی» (reread) باعث شد عاملها محدودههای مختلفی از یک فایل را مکرراً فراخوانی کنند تا به سقف درخواست برسند. حذف موارد تکراری در آرگومانها کمک نکرد زیرا آفستها (Offsets) مدام تغییر میکردند.
مسیر پیش رو
نسخههای آینده فشردهساز از تصمیمات مبتنی بر اندازه به سمت طبقهبندی مبتنی بر ابزار حرکت خواهند کرد. با استفاده از مدلهای محلی کوچک مانند Jev یا Laya، سیستم برای هر فراخوانی ابزار تصمیم میگیرد که آیا خروجی باید دقیق بماند یا بهطور کامل حذف شود — مانند نادیده گرفتن لاگهای npm install یا خروجیهای Build که هیچ ارزش معنایی ندارند.
اگر در حال ساخت عامل هستید، اکنون باید پیش از پیادهسازی هرگونه منطق بازنویسی تاریخچه، نرخ Cache-hit خود را اندازهگیری کنید تا از پرداخت «مالیات بازنویسی» بدون هیچ سودی جلوگیری کنید. نتایج از سایر ارائهدهندگان، بهویژه کسانی که خواندن کش گرانتری دارند (issue #193)، مورد استقبال است. برای ساخت سیستم خود، با راهنمای نویسندگی افزونه شروع کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو