
تصور کنید یک معماری جستوجوی پیچیده را دارید که به دلیل محدودیتهای پنهان و نبودِ یک سیستم غربالگری استراتژیک، عملاً فلج شده است. این دقیقاً وضعیتی بود که یک عامل هوش مصنوعی در دنیای پیچیده بازی Slay the Spire تجربه کرد، تا اینکه افزایش ۱۰ برابری در بازدهی جستوجو، آن را از لبهٔ شکست نجات داد. جزئیات این بازیابی و بهینهسازی در گزارشی که در ۱۵ سپتامبر ۲۰۲۶ در dev.to منتشر شد، به تفصیل شرح داده شده است.
ساخت یک هوش مصنوعی برای بازیهای کارتمحور (Deck-builder) یک کابوس واقعی در زمینه «تخصیص اعتبار» (Credit Assignment) است. در بازیهایی مانند Slay the Spire، بازی کردن یک کارت در لحظهٔ حال، ممکن است تا پنج نوبت دیگر نتیجه دهد؛ به همین دلیل برای یک شبکه عصبی (Neural Network) — که شبیه نقشهٔ مترویی از سلولهای کوچک است و سیگنال را از ورودی به جواب میرساند — یادگیری از طریق آزمون و خطای ساده تقریباً غیرممکن است. برای حل این مشکل، توسعهدهنده به سراغ برنامهریزی مبتنی بر جستوجو رفت تا نوبتهای آینده را شبیهسازی کرده و بهینهترین مسیر را بیابد.
بازی کردن در این حالت شبیه پیشبینی تمام کارتهای احتمالی است که ممکن است بکشید و تمام حرکات احتمالی دشمن. برای انسان این فرآیند شهودی است، اما برای هوش مصنوعی، تعداد احتمالات بهصورت نمایی منفجر میشود. همانطور که در تحلیلهای قبلی ما دربارهی چالشهای استدلال در محیطهای پویا اشاره کردیم، این همان «تلهٔ اکتشاف» است که مراحل اولیه این پروژه را به بنبست کشاند.
مشکل گروه گرملینها
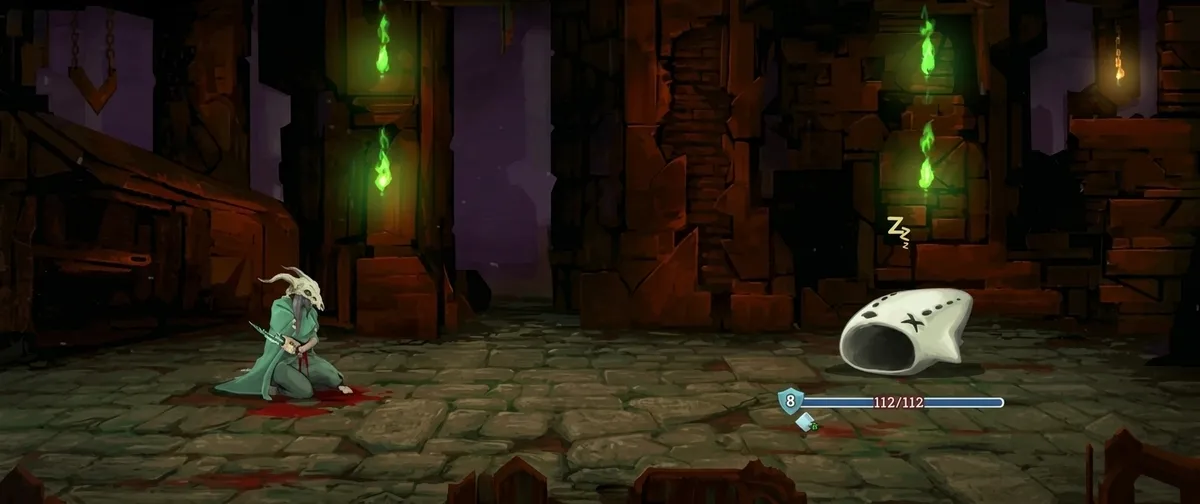
این چالش در رویارویی با «گروه گرملینها» (Gremlin Gang) کاملاً آشکار شد. این نبرد شامل ۴ دشمن است که از مجموع ۵ نوع گرملین انتخاب میشوند و امکان تکرار تا ۲ مورد از هر نوع وجود دارد. این مبارزه نیازمند برنامهریزی چند-نوبتی است زیرا هر دشمن اولویت متفاوتی را میطلبد:
- گرملین جادوگر (Gremlin Wizard): دو نوبت هیچ کاری نمیکند اما در نوبت سوم ضربهای بسیار مهلک میزند. او باید حتماً تا قبل از نوبت سوم کشته شود.
- گرملین سپر (Shield Gremlin): هیچ آسیبی وارد نمیکند مگر اینکه آخرین بازمانده باشد، اما به یکی دیگر از گرملینها سپر میدهد.
- گرملین چاق (Fat Gremlin): ضربات سختی نمیزند اما بازیکن را تضعیف (Weaken) میکند و حذف سایر گرملینها را سختتر میکند.
- گرملین موذی (Sneaky Gremlin): نامش گمراهکننده است، زیرا صرفاً هر نوبت به بازیکن ضربه میزند.
- گرملین دیوانه (Mad Gremlin): در ابتدا ضربات ضعیفی میزند اما هر بار که بازیکن به او ضربه بزند، قویتر میشود.
یک بازیکن انسانی ترکیب دشمنان را ارزیابی میکند. اگر جادوگر حضور داشته باشد، بازیکن ابتدا گرملینهای چاق و سپر را حذف میکند تا راه رسیدن به جادوگر باز شود و برای به حداقل رساندن آسیب کلی، چند ضربه از گرملین موذی را میپذیرد. اگر جادوگر نباشد، اولویت با حذف گرملین موذی است در حالی که بازیکن قدرت خود را برای مقابله با گرملینهای دیوانه و چاق بالا میبرد.
اما یک عامل هوش مصنوعی اغلب این ضرورت بلندمدت را نمیبیند. همچنین برنامه به نوع دست (Deck) بستگی دارد؛ مثلاً عتیقههای قدرتمند کاهش آسیب ممکن است به بازیکن اجازه دهد جادوگر را کاملاً نادیده بگیرد. شبکهای که صرفاً به وضعیت بازی و دسته کارتها نگاه میکند تا کارتها را یکییکی انتخاب کند، به دلیل مشکل تخصیص اعتبار، هرگز نمیتواند این استراتژیها را کشف کند.
شکست متدهای اکتشافی
توسعهدهنده برای هدایت جستوجو، سیستمی به نام AlphaStS ساخت که زیربنایی برای حلکنندههای سبک AlphaZero بود. AlphaStS از تمام کارتهای شخصیت Silent، دشمنان و رویاروییها پشتیبانی میکرد و به سیستم اجازه میداد حالتهای بازی را کپی کند، آینده را شبیهسازی کند و در صورت نیاز به عقب بازگردد.
به دلیل تصادفی بودن کارتهای کشیده شده (RNG)، شبیهسازی یک مبارزه تا پایان غیرممکن بود. بنابراین یک متد ارزیابی (Heuristic) طراحی شد که مجموعهای از قوانین و وزنها بود و به عنوان جایگزینی برای آموزشهای آتی عمل میکرد:
- پیروزی: ۱۰۰۰+ امتیاز.
- عوامل مثبت: میزان سلامتی (HP) بازیکن، مقدار سم (Poison) و اثرات منفی (Debuffs) روی دشمن.
- عوامل منفی: داشتن قدرت توسط دشمن Nob یا بیدار کردن زودهنگام Lagavulin.
- مقیاسبندی: مقدار دفاع (Block) با ضریب ۱.۵ برابر محاسبه میشد و سیستم فرض میکرد فارغ از نوع دست، هر نوبت ۱۲ واحد آسیب وارد میشود.
ساختار ساده بود: جستوجو تا رسیدن به سقف بودجهٔ محاسباتی ادامه مییافت. اگر پیروزی بدون از دست دادن سلامتی پیدا میشد، انتخاب میشد؛ در غیر این صورت، مسیری با بالاترین امتیاز ارزیابی برگزیده میشد و در نوبت بعد دوباره ارزیابی میشد.
با این حال، عملکرد این عامل در برابر bottled_ai (یک بات خبره) فاجعهبار بود. بات bottled_ai از یک جستوجوی BFS با سقف ۱۱,۰۰۰ حالت و یک فرآیند تصمیمگیری سلسلهمراتبی با ۵۰ قانون (مثلاً زنده بودن بهتر از مرده بودن است) استفاده میکند. در حالی که bottled_ai در ۲۶٪ بازیها پیروز میشد و به میانگین طبقه ۳۴.۰ میرسید، AlphaStS حتی با سقف ۱۰,۰۰۰ حالت برای مقایسه عادلانه، حتی یک بازی را هم نبرد و میانگین طبقه آن تنها ۱۸.۴ بود.
گلوگاه پنهان
بررسیها نشان داد که یک خطای بحرانی رخ داده است: دستیار هوش مصنوعی، یعنی Claude، بهطور پنهانی یک سقف ۵۱۲ حالتی برای عرض جستوجو اعمال کرده بود تا سرعت را بالا ببرد. این محدودیت باعث شده بود عامل اکثر حرکات ممکن را نادیده بگیرد و در مسیرهای غیربهینه گیر کند.
قبل از رفع این مشکل، توسعهدهنده متوجه شد که جستوجو «عزمش را بر حمله» کرده است. این موضوع منجر به تلاشی برای اطمینان از یکسان بودن رفتار بازی بدون رابط کاربری (Headless) و AlphaStS شد. یک تفاوت پیدا شد: AlphaStS روی درجه سختی Ascension 20 (سختترین حالت) تنظیم شده بود، که محیط شبیهسازی را خطرناکتر از بازی واقعی میکرد. پس از دو هفته و ۱۵۰ کامیت برای همراستا کردن این دو، نتایج همچنان ناامیدکننده بود:
- قبل از اصلاح: میانگین طبقه ۱۸.۴، پیروزی ۰٪، سرعت ۲۳۷ گام در ثانیه
- بعد از اصلاح: میانگین طبقه ۱۹.۳، پیروزی ۰٪، سرعت ۲۱۵ گام در ثانیه
- BFS خبره: میانگین طبقه ۳۴.۰، پیروزی ۲۶٪، سرعت ۱۵ گام در ثانیه
حذف سقف، مشکل اکتشاف را حل کرد اما مشکل جدیدی ایجاد کرد: سرعت جستوجو بهشدت افت کرد. عامل داشت توان محاسباتی خود را صرف ارزیابی حرکات «احمقانه» میکرد؛ مثلاً انتخاب دریافت آسیب در حالی که کارت دفاعی در دست بود و انرژی کافی وجود داشت.
نقطه عطف: هرس غلبه
راه حل در «هرس غلبه» (Dominance Pruning) نهفته بود. در نظریه بازیها، یک حرکت بر حرکت دیگر «غلبه» دارد اگر در تمام سناریوها اکیداً بهتر باشد. برای مثال، اگر بازیکن انرژی اضافی دارد و مورد حمله است، دفاع کردن اکیداً بهتر از پذیرفتن آسیب است. توسعهدهنده قوانینی را تعریف کرد تا یک حالت بازی را بهطور قطعی پایینتر از حالت دیگر طبقهبندی کند.
این تغییر منجر به بهینهسازی عظیمی شد:
- کاهش حالتها: سیستم ۹۰ تا ۹۴٪ از حالتهای مورد بررسی را حذف کرد.
- افزایش سرعت: سرعت پردازش عامل ۱۰ برابر شد.
- بهبود عملکرد: «جستوجوی مستقیم با هرس غلبه» به میانگین طبقه ۲۸.۷ و نرخ پیروزی ۶.۷٪ (۲ بازی از ۳۰ بازی) رسید، در حالی که بودجه زمانی ۵ ثانیه برای راهروها و ۲۰ ثانیه برای باسها در نظر گرفته شده بود.
برای نزدیکتر شدن به بازی انسانی، توسعهدهنده تمرکز را از حالتهای با امتیاز بالا به حالتهایی تغییر داد که تعداد «نوادگان» زنده بیشتری داشتند (گزینههای بیشتر). همچنین یک متد گرهگشایی سادهتر اضافه شد:raw = (player_hp / max_hp) - (total_enemy_hp / total_enemy_max_hp) + (total_poison / total_enemy_max_hp) + min(block, incoming_dmg) / max_hp
تست و مقایسه متدهای ارزیابی
برای جداسازی مشکل، توسعهدهنده ارزیابهای مختلف را در برابر جستوجوی AlphaStS مقایسه کرد تا بفهمد شکست مربوط به معماری است یا متد ارزیابی. نتایج ناامیدکننده بود:
- BFS خبره (bottled_ai): میانگین طبقه ۳۴.۰، پیروزی ۲۶٪، سرعت ۱۵ گام/ثانیه
- AlphaStS + مقایسهگر bottled_ai: میانگین طبقه ۱۷.۱، پیروزی ۱٪، سرعت ۲۷ گام/ثانیه
- AlphaStS + ارزیاب دستی: میانگین طبقه ۱۸.۴، پیروزی ۰٪، سرعت ۲۳۷ گام/ثانیه
- AlphaStS + ارزیاب یادگیرنده: میانگین طبقه ۱۶.۸، پیروزی ۰٪، سرعت ۱۴۷ گام/ثانیه
این نتایج تأیید کرد که مشکل اصلی خودِ جستوجو بود، نه سیستم امتیازدهی. حتی استفاده از مقایسهگر بات خبره در چارچوب AlphaStS نتایج خوبی نداد، که ثابت کرد جستوجو به حالتهای لازم نمیرسید.
آموزش ارزیاب نهایی
با اینکه جستوجو بالاخره نتایج متنوع و موفقی را میدید، توسعهدهنده مجموعهای از پرسپترونهای چندلایه (MLP) با معماری ۶۳۸->۲۵۶->۱۲۸->۱ آموزش داد. این ارزیاب یادگیرنده روی نمونهای از ۸۹,۰۰۰ حالت استخراج شده از ۳۰ بازی آموزش دید.
تستهای اولیه روی ۵ سید (Seed) با بودجه ۳ ثانیه/۱۰ ثانیه امیدوارکننده بود و به میانگین طبقه ۳۱.۲ رسید که تقریباً با bottled_ai برابری میکرد و بسیار سریعتر بود. اما در تستهای گستردهتر روی ۳۰ بازی با بودجه ۵ ثانیه/۲۰ ثانیه، این برتری از بین رفت. ارزیاب یادگیرنده روی عدد ۲۸.۸ تثبیت شد، در حالی که میانگین کلی ۲۷.۲ بود. MLP راه سریعتری برای رسیدن به نتیجه بود، اما اساساً از بهترین نتیجه قبلی پیشی نگرفت.
معیارهای نهایی عملکرد
مقایسه تکرارهای نهایی، تأثیر بودجه و هرس را نشان داد:
- ارزیاب دستی: میانگین طبقه ۱۹.۳، پیروزی ۰٪، بودجه ۵۰۰ میلیثانیه
- ارزیاب دستی (بودجه بیشتر): میانگین طبقه ۲۴.۰، پیروزی ۰٪، بودجه ۵ ثانیه راهرو / ۲۰ ثانیه باس
- جستوجوی مستقیم با هرس غلبه: میانگین طبقه ۲۸.۷، پیروزی ۶.۷٪، بودجه ۵ ثانیه راهرو / ۲۰ ثانیه باس
این مسیر یک حقیقت بنیادی در طراحی عاملهای هوش مصنوعی را نشان میدهد: محاسبات خام و متدهای پیچیده نمیتوانند جایگزین هرسِ تخصصی بر اساس دامنه مسئله شوند. با آموزش دادن به هوش مصنوعی که «چه چیزهایی را نبیند»، عملکرد واقعاً تغییر کرد.
برای کسانی که در حال ساخت عاملهایی در محیطهای پیچیده هستند، گام بعدی بررسی این است که چگونه کشف این قوانین غلبه را بهجای کدنویسی دستی، خودکار کنند.
گام بعدی شما
- اگر در حال ساخت عاملهایی برای محیطهای پیچیده هستید، بهجای افزایش قدرت سختافزاری، روی تعریف قوانین «غلبه» برای حذف حالتهای غیربهینه تمرکز کنید.
- بررسی کنید که آیا مدلهای زبانی در هنگام تولید کد برای شما، محدودیتهای پنهانی (مانند سقف تعداد تکرار یا طول خروجی) اعمال نکردهاند که باعث کاهش کیفیت استدلال شود.
- برای بهبود ارزیابها، از ترکیب قوانین سخت (Hard Rules) و مدلهای یادگیری ماشین (MLP) استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو