
تنوع خلاقانه در برترین مدلهای هوش مصنوعی جهان در حال ناپدید شدن است. طبق یافتههای یک مطالعه سیستماتیک از دانشگاه دوک (Duke University)، مدلها با تکامل خود به سمت مجموعهای مشترک از پاسخها حرکت میکنند و این موضوع میتواند دامنه ایدههایی را که کاربران در جلسات طوفان فکری یا تولید محتوا با آنها مواجه میشوند، بهشدت محدود کند.
این روند در حالی رخ میدهد که صنعت در رقابتی تنگاتنگ برای دستیابی به مجموعهدادههای بزرگتر و بهینهسازیهای تهاجمیتر است. در حالی که هدف اصلی این رقابت افزایش توانمندیهای کلی مدلها بوده است، اما به نظر میرسد پیامد ناخواسته آن، از دست رفتن «شخصیت» منحصربهفرد یا رویکردهای واگرایی است که پیشتر خانوادههای مختلف مدلها را از هم متمایز میکرد. این پدیده که «تکفرهنگی الگوریتمی» (Algorithmic Monoculture) نامیده میشود، اکنون از طریق تستهای تجربی روی نسلهای مختلف مدلها کمیسازی شده است.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن و اثر دادههای مصنوعی اشاره کردیم، تکرار الگوها میتواند منجر به ایجاد نقاط ضعف سیستمی شود؛ در اینجا نیز تکرار در سطح معنایی رخ داده است.
شواهد همگرایی
پژوهشگران ۶۹ نسخه از مدلهای متعلق به ۱۲ خانواده ارائهدهنده را که بین مارس ۲۰۲۳ تا ژوئیه ۲۰۲۶ منتشر شدهاند، مورد آزمایش دادند. این ارائهدهندگان شامل Anthropic، Google، Meta، OpenAI، DeepSeek، Mistral AI، Cohere، MiniMax، Moonshot AI، Qwen، xAI و Z.ai بودند.
برای اندازهگیری خلاقیت، تیم تحقیق از دو متدولوژی مجزا استفاده کرد:
- آزمون کاربردهای جایگزین (AUT): یک تست کلاسیک روانشناسی برای سنجش تفکر واگرا که از مدل میخواهد کاربردهای غیرمتعارف برای اشیای روزمره پیدا کند. در این مطالعه بهطور خاص از اشیایی مانند کتاب، کفش و چکش استفاده شد. ساختار ثابت این تست، روشی کنترلشده برای مقایسه ایدهها در میان مدلهای مختلف فراهم کرد.
- Infinity-Chat100: مجموعهای از ۱۰۰ پرامپت استخراجشده از مجموعهای از گفتگوهای واقعی کاربران با مدلهای زبانی. این تستها وظایف خلاقانه کممحدودیتتری مانند تولید محتوا، حل مسئله، طوفان فکری و ایدهپردازی را پوشش میداد.
جزئیات متدولوژی فنی
برای اطمینان از استحکام نتایج، پژوهشگران یک خط لوله فنی دقیق را اجرا کردند:
- تنظیمات نمونهبرداری: تمام پاسخها از طریق API سرویس OpenRouter جمعآوری شدند. برای به حداکثر رساندن آزادی خلاقانه، هر دو پارامتر دما (Temperature) و top-p روی عدد یک تنظیم شدند.
- گروهبندی زمانی: ۲۷ ماه انتشار به ۹ بازه زمانی تقسیم شدند. مدلها بر اساس ماه انتشار مرتب شدند تا بررسی شود آیا نسلهای جدیدتر پاسخهای مشابهتری تولید میکنند یا خیر.
- نگاشت معنایی: پاسخها با استفاده از مدل all-MiniLM-L6-v2 (یک sentence-transformer) به بردار معنایی (Embedding) تبدیل شدند. این کار به تیم اجازه داد تا «فاصله معنایی» بین پاسخها را بهصورت عددی اندازهگیری کند.
- نمونهبرداری متوازن: برای جلوگیری از تسلط ارائهدهندگانی که بهروزرسانیهای مکرر و بیشتری داشتند بر دادهها، تحلیل ۱۰۰۰ بار با استفاده از نمونههای متوازن از هر ارائهدهنده تکرار شد.
- تحلیل رگرسیون: تیم از رگرسیون خطی برای ردیابی این فاصلهها در طول زمان استفاده کرد. یک شیب منفی و مداوم در نمودارها نشان داد که مدلهای ارائهدهندگان مختلف در حال شبیتر شدن به یکدیگر هستند.
دامنه و توزیع مدلها
این مطالعه بازه زمانی گستردهای از مارس ۲۰۲۳ تا ژوئیه ۲۰۲۶ را پوشش داد. پژوهشگران اشاره کردند که تقویم انتشار برخی ارائهدهندگان در این دوره بهشدت فشرده شده است و این عاملی بود که باید در محاسبات نهایی لحاظ میشد.
لیست مدلها جامع بود و نسخههای مختلف سیستمهای مطرح را شامل میشد:
- OpenAI: شامل GPT-3.5-Turbo، GPT-4، GPT-4.1، GPT-4o، GPT-5، GPT-5.1، GPT-5.2، GPT-5.3-Chat، GPT-5.4، GPT-5.5 و GPT-5.6-Sol. این تسلط گسترده OpenAI در بازار با تغییرات اخیر در رفتار کاربران همراه شده است، بهطوری که سهم ChatGPT از ترافیک ارجاعی هوش مصنوعی به ۶۲.۶٪ کاهش یافت و نشاندهنده توزیع بیشتر کاربران میان مدلهای رقیب است.
- Anthropic: شامل Claude-3-Haiku، Claude-Fable-5، Claude-Opus-4، Claude-Opus-4.1، Claude-Opus-4.5، Claude-Opus-4.6، Claude-Opus-4.7 و Claude-Opus-4.8.
- Google: شامل Gemini-2.5-Pro، Gemini-3-Flash-Preview، Gemini-3.1-Pro-Preview و Gemini-3.5-Flash.
- Meta: شامل Llama-3.1-70B-Instruct، Llama-3.2-3B-Instruct، Llama-3.3-70B-Instruct و Llama-4-Maverick.
- Mistral AI: شامل Mistral-Large، Mistral-Large-2407، Mistral-Large-2512، Mistral-Medium-3، Mistral-Medium-3.5، Mistral-Medium-3.1، Mistral-Small-24B-Instruct-2501، Mistral-Small-2603، Mistral-Small-3.1-24B-Instruct، Mistral-Small-3.2-24B-Instruct و Mixtral-8x22B-Instruct.
- سایرین: مدلهای DeepSeek (Chat، V3.1-Terminus، V3.2، V4-Pro)، MiniMax (01، M1، M2، M2.1، M2.5، M2.7، M3)، Qwen (2.5-72B-Instruct، Qwen3-Max، Qwen3.5-Plus-20260420، Qwen3.6-Max-Preview، Qwen3.7-Max)، xAI (Grok-4.20، Grok-4.3، Grok-4.5) و Z.ai (GLM-4.5، GLM-4.6، GLM-4.7، GLM-5، GLM-5.1، GLM-5.2).
کمیسازی افول خلاقیت
با تبدیل پاسخها به بردارهای عددی با استفاده از all-MiniLM-L6-v2، پژوهشگران توانستند ردیابی کنند که آیا مدلها از نظر معنایی از هم فاصله میگیرند یا در حال ادغام هستند.
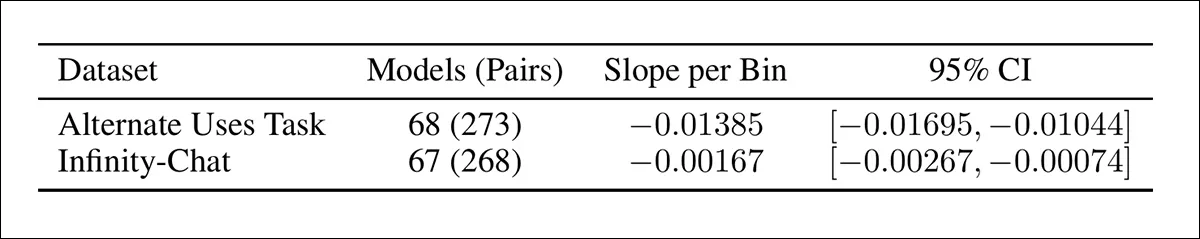
در آزمون AUT، نتایج تکاندهنده بود. میانگین فاصله معنایی بین پاسخهای ارائهدهندگان مختلف از حدود ۰.۵۰ در قدیمیترین مدلها به زیر ۰.۴۰ در جدیدترین نسخهها کاهش یافت. این یک کاهش آماری معنادار در تنوع ایدههاست، آن هم در حالی که مدلها صراحتاً از آنها خواسته شده بود «اصیل» باشند.
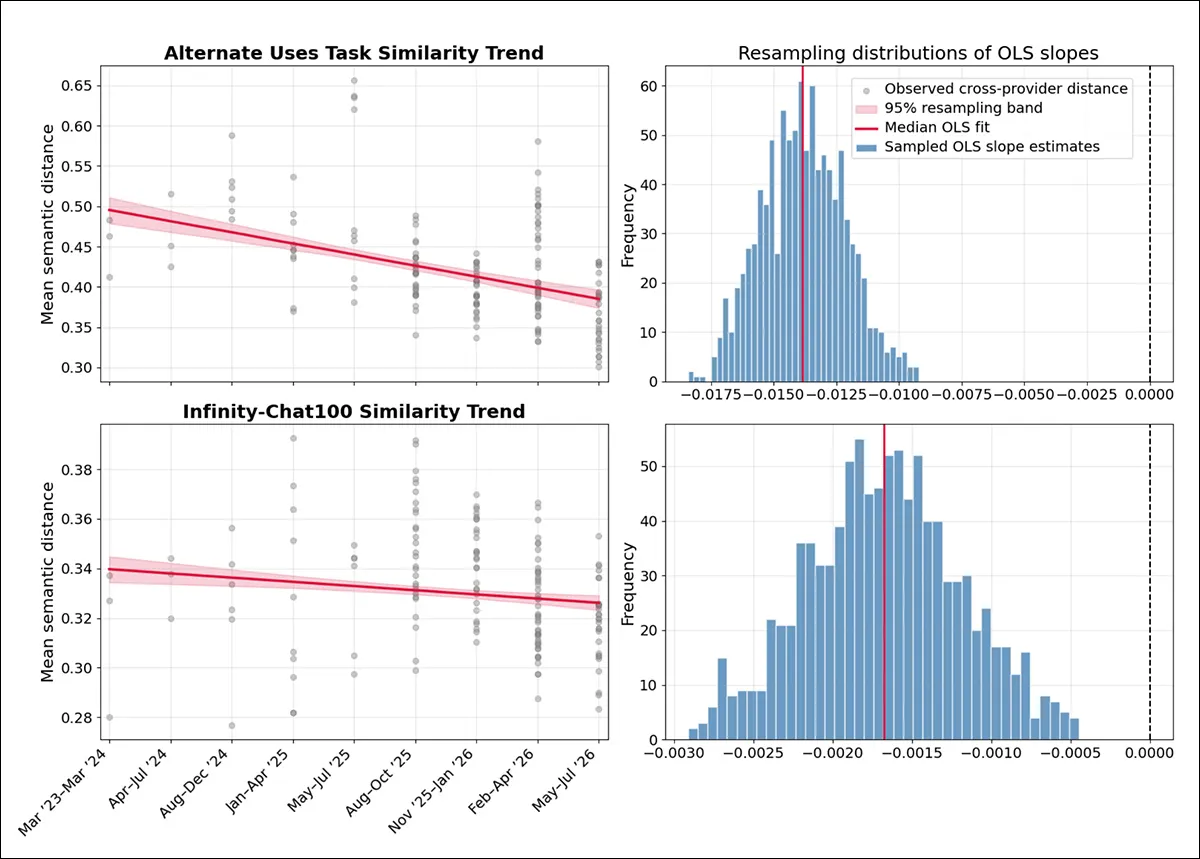
در متن مقاله ذکر شده است: «میزان کاهش در AUT بهویژه به دلیل هدف این آزمون قابل توجه است. AUT صراحتاً تفکر واگرا را میسنجد و از مدلها میخواهد کاربردهایی تا حد ممکن بدیع و غیرمنتظره تولید کنند؛ یعنی دقیقاً همان جایی که انتظار میرود خروجیها با هم متفاوت باشند.»
در تستهای Infinity-Chat100 نیز روند مشابه اما کمشدتتری دیده شد و میانگین فاصله از ۰.۳۴ به کمی بالای ۰.۳۲ رسید. با این حال، پژوهشگران اشاره کردند که این همگرایی در مدلهای منتشرشده از سال ۲۰۲۵ به بعد بهطور قابلتوجهی واضحتر شد. این موضوع نشان میدهد که خروجیهای خلاقانه بهطور کلی در حال شبیتر شدن هستند، نه فقط در یک نوع تست خاص.
ناهنجاری «فانوس دریایی»
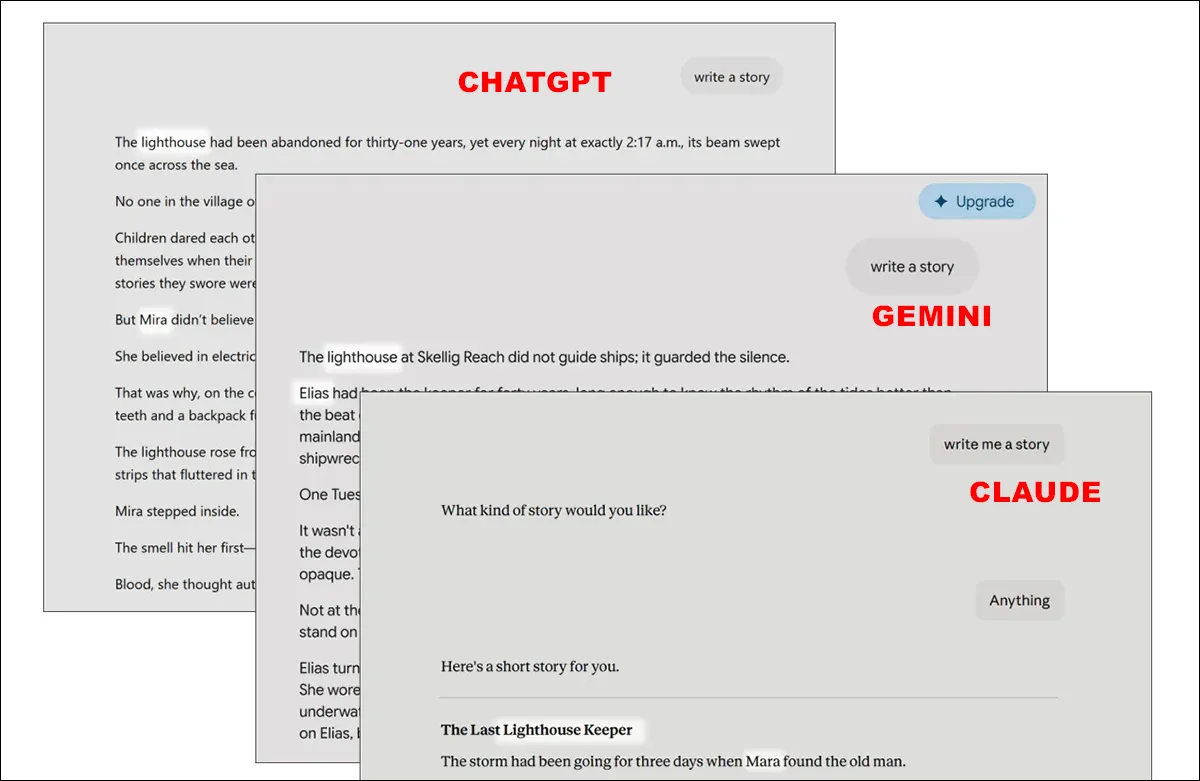
مطالعه دوک بر پایه مشاهدات پراکنده قبلی بنا شده است. به گزارش مطالعهای از دانشگاه کرنل (Cornell University) در مه ۲۰۲۶، یک وسواس مشترک عجیب در LLMهای مختلف مشاهده شده است؛ مدلها در پاسخ به پرامپتهای باز، بهطور غیرعادی به «نگهبانان فانوس دریایی» و نامهای قدیمی و نابهنگام مانند «مارا» و «الیاس» علاقه نشان میدهند.
این «وسواس برخوردکننده» نشان میدهد که مدلها نهتنها در منطق، بلکه در استعارههای معنایی عجیب نیز همگرا شدهاند. هنوز هیچ سرنخی درباره علت وقوع این اتفاق در دادههای آموزشی متنوع مدلها یافت نشده است. برخی نویسندگان حتی کتابهایی با محوریت این وسواسهای مشترک هوش مصنوعی منتشر کردهاند و این همگرایی را به یک «میم» (Meme) در جامعه AI تبدیل کردهاند.
چرا این اتفاق میافتد؟
نویسندگان دو نیروی اصلی را عامل این یکنواختی میدانند:
۱. همپوشانی دادههای آموزشی: وقتی ارائهدهندگان از مجموعهدادههای عظیم یکسانی استفاده میکنند یا از دادههای مصنوعی (Synthetic Data) تولیدشده توسط مدلهای پیشرو دیگر تغذیه میکنند، پایگاه دانش زیربنایی یکسان میشود. نویسندگان اشاره میکنند که ما در حال رسیدن به پایان اولین نسل «خالص» از دادهها هستیم.
۲. اهداف بهینهسازی مشابه: اکثر ارائهدهندگان برای بنچمارکهای یکسان و الگوهای ترجیح انسانی (RLHF) بهینهسازی میکنند و مدلها را به سمت یک مرکز «ایمن» یا «متوسط» از بازنمایی معنایی سوق میدهند.
به نقل از نویسندگان: «بدنه رو به رشدی از آثار آکادمیک نشان میدهد مدلهای مولدی که روی دادههای همپوشان آموزش دیده و با اهداف مشابه بهینه شدهاند، مفاهیم و روابط معنایی را به روشهای مشابهی سازماندهی میکنند و در نتیجه خروجیهای مشابهی تولید میکنند.»
پیامدها برای خلاقیت انسانی
پژوهشگران نگراناند که این همگرایی، دامنه احتمالات پیش روی کاربران را محدود کند. اگر LLMها بهعنوان شریک خلاق برای ایدهپردازی یا نوشتن مقاله استفاده شوند، فقدان تنوع در خروجی آنها ممکن است وسعت تفکر انسان را نیز تنگتر کند.
آنها این پرسش حیاتی را مطرح میکنند: «اگر استفاده از LLM برای کارهای خلاقانه مانند نوشتن مقاله باعث کاهش فعالیت مغزی شود، آیا استفاده از مدلهایی که هر روز کمتر خلاق میشوند، اثرات منفی بر خلاقیت انسان را تشدید نمیکند؟»
علاوه بر این، این روند چالش جدیدی برای تشخیص محتوا ایجاد میکند. با یکنواخت شدن متنهای تولیدشده، ناشران و مربیان ممکن است شاهد افزایش «تصادفات داستانی» باشند؛ جایی که آثار بهظاهر انسانی، ساختارها یا ویژگیهای تماتیک یکسانی دارند چون همگی توسط مدلهای همگرا تولید شدهاند. این موضوع بهویژه در حالی اهمیت مییابد که ناشران بهطور فزایندهای کتابهایی را که مشکوک به نوشته شدن توسط هوش مصنوعی هستند، پس میگیرند.
تحلیل فنی
از منظر فنی، این تغییر نشان میدهد که ما به نقطه بازده نزولی در تنوع معماری رسیدهایم. وقتی دادههای آموزشی و توابع پاداش تقریباً یکسان باشند، بازنماییهای داخلی مفاهیم بهناچار همراستا میشوند.
این موضوع یک پرسش بنیادین را برای این حوزه ایجاد میکند: آیا این یکنواختی یک محصول موقت از قوانین مقیاسپذیری فعلی است یا ویژگی اجتنابناپذیر مدلهای آماری زبان؟ نویسندگان اشاره میکنند که هنوز مشخص نیست این وضعیت یک نقص گذرا در تکنولوژی در حال توسعه است یا یک ویژگی ساختاری که در آینده تشدید میشود.
در حالی که برخی شواهد نشان میدهد مدلها ممکن است در نهایت دوباره به سمت ویژگیهای «محصور» و متمایز خود حرکت کنند، اما مسیر فعلی به سمت یک خروجی یکپارچه و کمتر خلاقانه است. برای مقابله با این وضعیت، صنعت باید از بهینهسازیهای ساده فراتر رفته و به سمت روشهای آموزشی حرکت کند که صراحتاً «واگرایی» و «نوآوری» را بهجای صرفاً دقت یا مفید بودن، پاداش دهند. جایگزینی سادهای مثل تغییر در علائم نگارشی (مانند خط تیره) مشکل را حل نمیکند؛ در عوض، موارد تکراری بهصورت عمومی و شرمآور ظاهر خواهند شد.
منتظر پژوهشهای آتی درباره اهداف آموزشی «حفظکننده تنوع» یا ظهور مدلهای تخصصی باشید که روی مجموعهدادههای بسیار گزینششده و غیرهمپوشان آموزش دیدهاند تا این تکفرهنگی را بشکنند.
گام بعدی شما
- در پروژههای ایدهپردازی، از ترکیب چندین مدل با معماریهای کاملاً متفاوت (مثلاً یک مدل تجاری و یک مدل بازمتن کوچک) استفاده کنید تا از تکفرهنگی معنایی فاصله بگیرید.
- برای خروجیهای خلاقانهتر، از تکنیکهای مهندسی پرامپت (Prompt Engineering) برای اجبار مدل به اتخاذ نقشهای غیرمتعارف یا استفاده از استعارههای دور از انتظار بهره ببرید.
- نتایج بنچمارکهای جدید را با دقت بررسی کنید تا ببینید آیا بهبود نمرات با کاهش تنوع پاسخها (Over-optimization) همراه بوده است یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و اثر آنها بر سرعت استنتاج مراجعه کنید. در این راستا، تفاوتهای عملیاتی مدلها نیز بسیار چشمگیر است؛ برای مثال، هزینه استنتاج Claude Opus 5 دویست برابر بیشتر از DeepSeek V4 Flash است که نشان میدهد همگرایی در خروجیها لزوماً به معنای همگرایی در هزینههای زیرساختی نیست.



گفتگو