اگر امروز یک عامل هوش مصنوعی میسازید که باید از میان دهها ابزار، گزینه درست را انتخاب کند، احتمالاً با بحران «تطابق واژگانی» (Lexical Trap) دستوپنجه نرم میکنید. این تله زمانی رخ میدهد که عبارتبندی کاربر دقیقاً با توصیف ابزار مطابقت نداشته باشد. تصور کنید کاربر میگوید «رزرو من را لغو کن»، اما ابزار شما با توصیف «حذف رزرو» تعریف شده است؛ در این حالت، سیستمهای سنتی بهسادگی شکست میخورند.
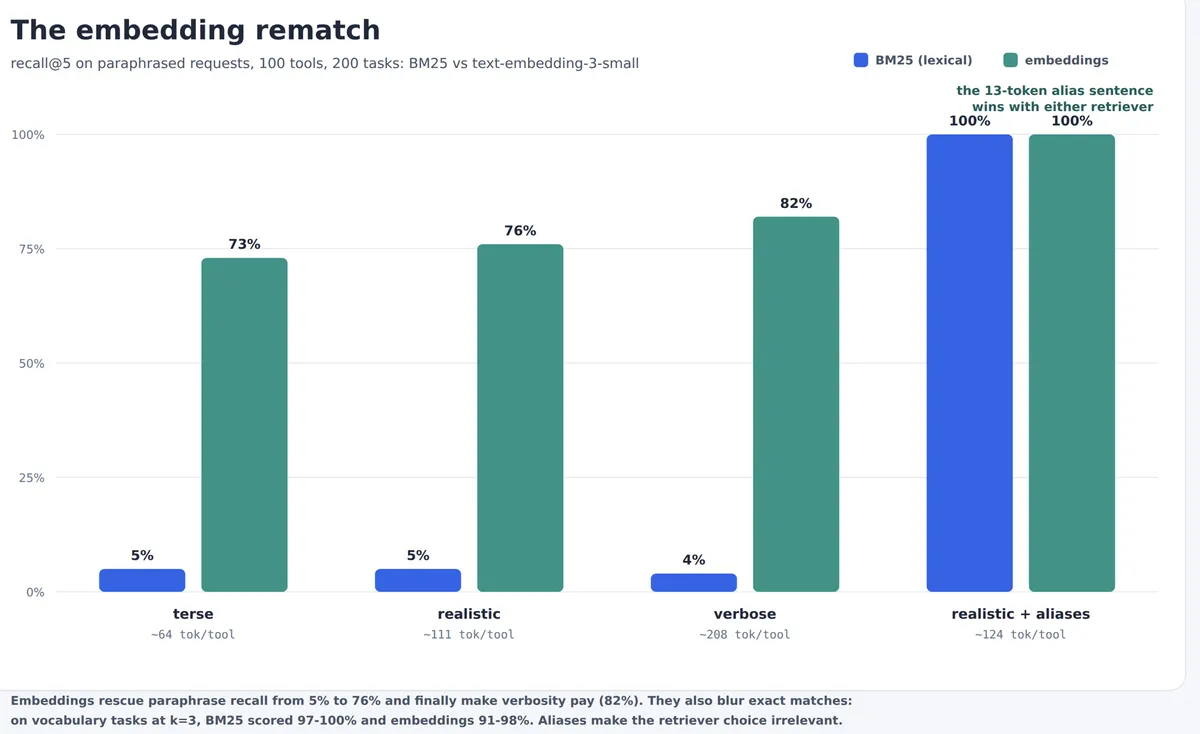
طبق گزارشی که در ۱۴ اکتبر ۲۰۲۶ منتشر شد، استفاده از مدل text-embedding-3-small روی پلتفرم Azure OpenAI توانست نرخ بازیابی (Recall) — یعنی توانایی مدل در یافتن ابزار درست — را برای درخواستهای بازنویسیشده از ۵٪ فاجعهبار به ۷۶٪ ارتقا دهد.
این جهش به دلیل جایگزینی جستوجوی متنی با بردار معنایی (Embedding) رخ داده است؛ چیزی شبیه به کارت معرفی عددی برای هر واژه که میگوید این کلمه «همسایهی» چه کلمات دیگری است. برای درک عمیقتر این فرآیند، میتوانید سازوکار تبدیل معنای متن به مختصات برداری را بررسی کنید که توضیح میدهد چگونه مفاهیم به نقاطی در فضای ریاضی تبدیل میشوند. در حالی که ابزارهای قدیمی مثل BM25 فقط به دنبال کلمات یکسان میگردند و چون کلمات «لغو» و «حذف» همپوشانی ندارند، شکست میخورند، بازیابی معنایی میفهمد که این عبارات در یک محله مفهومی زندگی میکنند.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی بازیابی در سیستمهای RAG اشاره کردیم، تفاوت بین «کلمه» و «معنا» مرز بین شکست و پیروزی عاملهای هوش مصنوعی است. در این راستا، رویکردهایی مانند تحلیل ریسک در MEMORA نشان میدهند که چگونه عبور از بازیابی ساده دادهها به سمت درک عمیقتر میتواند نتایج را بهبود بخشد.
زمینه و جزئیات آزمایش
برای اثبات این ادعا، پژوهشگر یک آزمون مجدد (Rematch) را با استفاده از همان ۱۰۰ ابزار و ۲۰۰ وظیفه از آزمایش قبلی اجرا کرد. این ساختار شامل چهار وضعیت مختلف برای توصیفات بود و یک «k-sweep» برای اندازهگیری این موضوع انجام شد که گسترش لیست کوتاه (Shortlist) چگونه بر نتایج اثر میگذارد.
ابزار تست برای این آزمایش خاص، فایل measure/eval_recall_embed.py در مخزن همراه است. در حالی که آزمایش قبلی بر پایه BM25 بود، این نسخه هر سند ابزار و هر درخواست کاربر را به بردار تبدیل کرده و آنها را بر اساس شباهت کسینوسی (Cosine Similarity) رتبهبندی میکند.
به نقل از گزارش منتشر شده در dev.to، نتایج این آزمایش تضاد جالبی را بین دقت و انعطافپذیری نشان میدهد:
تحلیل عملکرد بازیابی
- درخواستهای بازنویسیشده: بردار معنایی در حالت k=5 به نرخ بازیابی ۷۶٪ رسید، در حالی که BM25 تنها ۵٪ موفق بود. این موضوع تأیید میکند که بردارها در جایی که تطابق واژگانی شکست میخورد، بازنویسیها را نجات میدهند.
- واژگان دقیق: در مواردی که کاربر دقیقاً از کلمات توصیف ابزار استفاده کرد، BM25 با نرخ ۹۷ تا ۱۰۰٪ در k=3 برنده شد، در حالی که بردار معنایی به ۹۱ تا ۹۷٪ کاهش یافت. این اتفاق به این دلیل میافتد که بردارها میتوانند تطابقهای دقیق را «تار» کنند و گاهی یک گزینه شبیه را بالاتر از گزینه دقیق رتبهبندی کنند.
- تأثیر حجم متن: توصیفات طولانیتر به بازیابی معنایی کمک کردند (۸۲٪ در برابر ۷۳٪ برای توصیفات موجز در k=5). هر جمله اضافه، «سطح معنایی» بیشتری ایجاد میکند تا بردار پرسوجو بتواند روی آن فرود بیاید. اما برای BM25، دو برابر کردن تعداد توکنها هیچ سودی نداشت.
- پیروزی نامهای مستعار: افزودن یک جملهٔ جایگزین (Alias) ۱۳ توکنی به هر ابزار، نرخ بازیابی را در تمام شرایط و مقادیر k به ۹۹ تا ۱۰۰٪ رساند، فارغ از اینکه از چه روش بازیابی استفاده شود.
یک یافته شگفتانگیز این است که خطاهای معنایی معمولاً «نزدیک به هدف» (Near Misses) هستند. وقتی لیست کاندیدها از ۳ به ۱۰ مورد افزایش یافت، بازیابی بردار معنایی از ۵۹٪ به ۹۴٪ جهش کرد. در مقابل، خطاهای واژگانی اغلب «غیبت مطلق» هستند؛ گسترش لیست برای BM25 تنها نرخ را از ۳٪ به ۱۰٪ رساند، زیرا ابزار درست بهندرت در نزدیکی بالای رتبهبندی بود.
تأثیر بر موفقیت نهایی (End-to-End)
این شکاف در بازیابی، تفاوت عظیمی در موفقیت نهایی فراخوانی ابزار ایجاد میکند. با ضرب کردن نرخ بازیابی در نرخ انتخاب برای درخواستهای بازنویسیشده با توصیفات واقعگرایانه، نتایج چنین است:
- BM25: بازیابی ۵٪ × انتخاب ۹۳٪ ≈ ۵٪ موفقیت کلی.
- بردار معنایی: بازیابی ۷۶٪ × انتخاب ۹۳٪ ≈ ۷۱٪ موفقیت کلی.
- استفاده از Alias: بازیابی ۱۰۰٪ × انتخاب ۹۷٪ ≈ ۹۷٪ موفقیت کلی.
با این حال، consequentialترین کشف، قدرت «جمله نام مستعار» است. با افزودن تنها یک جمله ۱۳ توکنی از عبارتبندیهای جایگزین به هر ابزار، نرخ بازیابی در همه شرایط به ۹۹-۱۰۰٪ رسید، بدون توجه به نوع بازیاب.
این موضوع فرض فنی را برای توسعهدهندگان کاتالوگ ابزار تغییر میدهد: اگر مالک توصیفات هستید، اصلاح کلمات بسیار ارزانتر از نگهداری یک خط لوله برداری (Vector Pipeline) است. شما با کسری از هزینه عملیاتی و بدون هیچ زیرساخت اضافی، به بازیابی کامل میرسید.
اما برای کسانی که مدیریت درگاهها یا کاتالوگهایی را بر عهده دارند که توصیفاتش توسط تیمهای ثالث (مانند سرورهای MCP) ارائه میشود، خط لوله بردار معنایی تنها توصیه صادقانه است. این روش یک شکست مطلق را به یک هزینه قابل مدیریت روی عملکرد تبدیل میکند. این رویکرد مکمل روشهایی است که در سیستمهای اصلاح خودکار رفتار عاملها برای کاهش خطاهای فراخوانی ابزار به کار میروند.
محدودیتهای صادقانه مطالعه
باید به محدودیتهای این بنچمارک توجه کرد. این مطالعه تنها از یک مدل (text-embedding-3-small) استفاده کرده است؛ استفاده از مدلهای بزرگتر یا رتبهبندهای ترکیبی (Hybrid Ranker) ممکن است این شکافها را کمتر کند. علاوه بر این، بازنویسیها بهصورت الگویی (Template-generated) تولید شدهاند که آنها را رامتر از عبارتبندیهای واقعی کاربران میکند. همچنین در حالی که کاتالوگ ۱۰۰ ابزار داشت، ایندکس برداری در مقیاس ۱۰۰۰ ابزار جذابتر میشود، جایی که تحمیل انضباط در نوشتن Alias بین چندین تیم دشوار میگردد.
در نهایت، دادهها ثابت میکنند که بردار معنایی یک تور نجات قدرتمند است، اما بیشترین بازگشت سرمایه (ROI) از انضباط زبانی ساده حاصل میشود. اول کلمات را اصلاح کنید، و تنها زمانی به سراغ ایندکس برداری بروید که کلمات دیگر در اختیار شما نباشند.
برای تست این یافتهها، توسعهدهندگان میتوانند به مخزن همراه دسترسی پیدا کنند که شامل اسکریپت eval_recall_embed.py برای بردارها و measure/eval_recall.py برای BM25 است تا آزمایشهای k-sweep خود را اجرا کنند.
گام بعدی شما
- اگر از BM25 برای انتخاب ابزار استفاده میکنید، ابتدا برای هر ابزار یک جملهٔ «نام مستعار» شامل کلمات کلیدی جایگزین اضافه کنید.
- برای کاتالوگهای ابزاری که توسط تیمهای مختلف مدیریت میشوند، یک لایه بردار معنایی را برای جلوگیری از شکستهای مطلق در بازیابی پیادهسازی کنید.
- از اسکریپت
eval_recall_embed.pyدر مخزن همراه برای تست نرخ بازیابی مدلهای خود در مقیاسهای مختلف k استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو