تصور کنید یک استراتژی امنیتی سختگیرانه در یک پروژه باعث پیروزی شما شود، اما دقیقاً همان رویکرد در پروژهای مشابه منجر به شکست شود. این تضاد دقیقاً همان جایی است که استراتژیهای استاندارد «تولید بازیابیافزا» (RAG) شکست میخورند؛ زیرا RAG صرفاً هر دو نتیجه را بدون توضیح دلیل تفاوت آنها برمیگرداند. برای حل این مشکل، یک توسعهدهنده MEMORA را ساخت؛ یک عامل حافظهمحور برای مدیریت درخواستهای پیشنهاد (RFP) که طراحی شده تا بر اساس شواهد، باورهای خود را شکل دهد و در صورت نیاز آنها را اصلاح کند.
زمینه و بستر تضاد
در یک پروژه آزمایشی که شامل ۲۳ مورد RFP ساختگی بود، یک پیشنهاد با اولویت امنیت در سیستم بهداشتی Meridian Valley پیروز شد، اما دقیقاً همین رویکرد در گروه پزشکی Cedar Ridge منجر به شکست شد. دلیل این تغییر نتیجه، زمانبندی بود: در حالی که زمانبندی Meridian انعطافپذیر بود، Cedar Ridge اصرار داشت که پروژه باید در یک ضربالاجل سختگیرانه ۹۰ روزه فعال شود. برنامه امنیتی پیشنهادی که ۷ ماه زمان میبرد، به سادگی نمیتوانست این شرط را برآورده کند.
اگر شما هر دو پیشنهاد را در یک پایگاه داده برداری (Vector Database) قرار دهید و عبارت «امنیت-اول» (security-first) را جستجو کنید، هر دو نتیجه را دریافت میکنید. این پاسخ از نظر فنی درست است اما در عمل بیفایده است، زیرا کاربر همچنان باید خودش تصمیم بگیرد که کدام درس برای مناقصه فعلی کاربرد دارد. هدف MEMORA این بود که عاملی ایجاد کند که به جای صرفاً بازگرداندن تضاد، آن را «نگه دارد»؛ یعنی باوری درباره دلیل پیروزی یا شکست یک پیشنهاد شکل دهد و با رسیدن شواهد جدید، آن باور را اصلاح کند.
بسیاری از عاملهای هوش مصنوعی با حافظه به عنوان یک کتابخانه استاتیک از اسناد برخورد میکنند. MEMORA این رویکرد را تغییر میدهد. این سیستم از Hindsight برای بانک حافظه و از Groq (که مدل openai/gpt-oss-120b را اجرا میکند) برای استدلال استفاده میکند و منطق پیرامونی آن توسط زبان پایتون فراهم شده است. این رویکرد یادآوریکننده سیستم DealMind AI است که از حافظه بازگشتی برای شناسایی تضادهای رفتاری مشتریان استفاده میکرد تا الگوهای پیچیده را فراتر از جستجوی ساده شناسایی کند.
به نقل از گزارش فنی منتشر شده در ۲۹ سپتامبر ۲۰۲۶، این عامل از طریق یک حلقه معماری خاص عمل میکند:
جزئیات فنی
- جذب گزینشی (Selective Ingestion): عامل پیشنهادهای گذشته را در بانک حافظه Hindsight جذب میکند. نکته کلیدی این است که عامل عمداً فیلد
lessons_learned(درسهای آموخته شده) را جذب نمیکند. یک تست رگرسیون برای اعمال این محدودیت تعبیه شده تا اطمینان حاصل شود که عامل صرفاً نتیجهگیریهای انسانی را بازیابی نمیکند، بلکه خودش آنها را شکل میدهد. - تحلیل پیشمرگ (Premortem Analysis): پیش از نوشتن هر پاسخ جدید، تابع
premortem()تاریخچه مرتبط را فراخوانی کرده و ریسکها را همراه با برچسبهای شواهدی و بلوکی از تضادهای شناختهشده بازمیگرداند. - حل تضاد (Conflict Resolution): وقتی عامل یک پیروزی و یک شکست برای یک استراتژی مشابه مییابد، یک «راهکار حل» ذخیره میکند. برای مثال، مناقصه سوم برای Bayshore Regional Health تضاد Cedar Ridge را حل کرد: استراتژی امنیتی دوباره پیروز شد، اما این بار زمانی که به صورت یک «هسته امن فازبندیشده ۶۰ روزه» ارائه شد. اکنون عامل هشدار میدهد که استراتژی امنیتی در ضربالاجلهای سخت ریسکی است، مگر اینکه فازبندی شود.
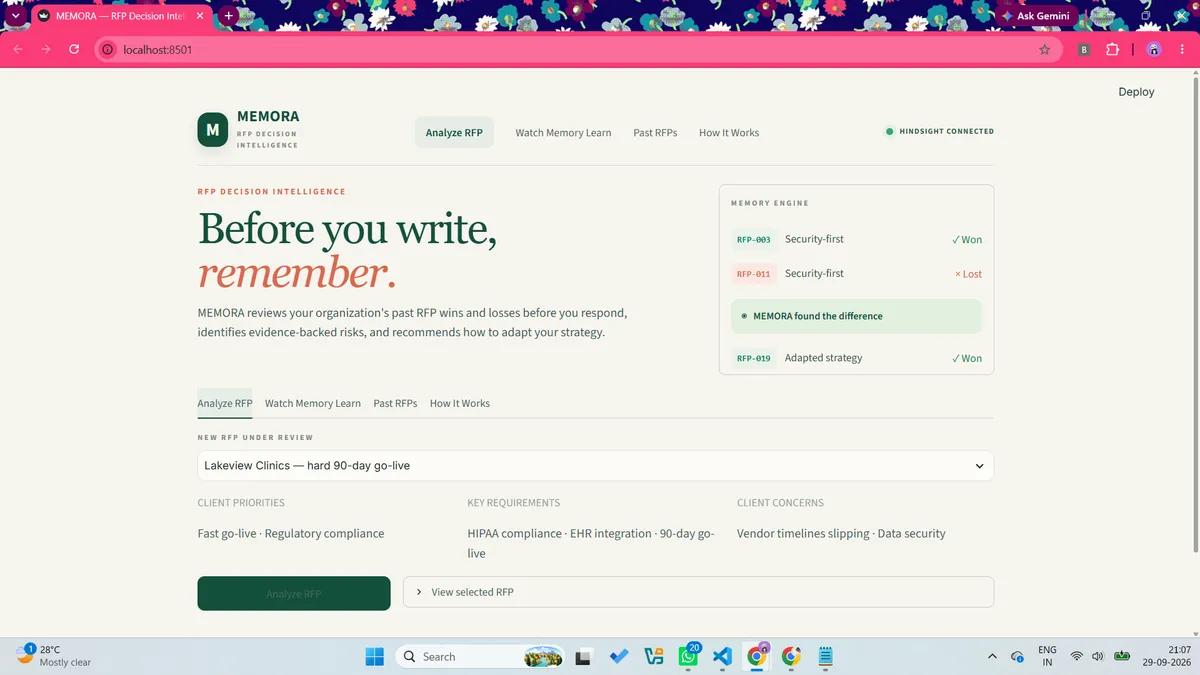
برای اثبات اینکه عامل واقعاً یاد میگیرد، توسعهدهنده از یک اسکریپت سه مرحلهای به نام learning_demo.py استفاده کرد. این اسکریپت از یک بانک مجزا استفاده میکند و تاریخچه را تکه به تکه آشکار میکند:
- مرحله ۰: دادههای Cedar Ridge و Bayshore پنهان هستند. تحلیل پیشمرگ فقط ریسکهای کلی را برمیگرداند و به پیشنهادهای نامرتبط مانند RFP-002، RFP-009 و RFP-023 استناد میکند.
- مرحله ۱: دادههای Cedar Ridge (شناسه RFP-011) اضافه میشود. بلافاصله یک ریسک جدید ظاهر میشود که به RFP-011 استناد کرده و وضعیت واقعی را بازتاب میدهد: کلینیکهای جدید و ضربالاجل ۹۰ روزه.
- مرحله ۲: دادههای Bayshore (شناسه RFP-019) اضافه میشود. متن ریسک تکامل مییابد و استراتژی امنیتی را مستقیماً به ریسک زمانبندی گره میزند و به طور همزمان به RFP-003 و RFP-011 استناد میکند.
یک جزئیات مربوط به قابلیت اطمینان، نیاز به اصلاح کد داشت: بانکهای Hindsight به طور نامحدود باقی میمانند. برای جلوگیری از اینکه یک RFP از اجرای قبلی، خط مبنای (Baseline) مرحله «قبل از یادگیری» را آلوده کند، دمو اکنون در ابتدای هر اجرا با دستور memory.client.delete_bank(bank_id=DEMO_BANK) خود را ریست میکند.
یک باگ بحرانی، ضعف بزرگی را در مدلهای زبانی بزرگ (LLM) آشکار کرد: عامل شروع به استناد به شناسههای RFP واقعی کرد، حتی زمانی که آنها در حافظه نبودند. علت این اتفاق، مثالهای JSON موجود در پرامپت بود که از شناسههای واقعی مانند «RFP-011» به عنوان جایگذار (Placeholder) برای فرمتبندی استفاده کرده بود. مدل اینها را به عنوان شواهد واقعی تلقی کرد. راهکار این بود که از جایگذارهای جعلی مانند «RFP-XXX» استفاده شود و یک تست واحد (Unit Test) اضافه شود که اگر هر شناسهی واقعی در مثالهای پرامپت ظاهر شود، تست را با شکست مواجه کند.
محدودیتهای صادقانه
باید پذیرفت که سیستم سیمکشی تضادها در حال حاضر یک مهندسی ساده است. از آنجایی که برخی از خاطرات بازیابی شده فاقد ارجاع دقیق بودند، توسعهدهنده تابع _known_conflicts() را نوشت تا تضادهای پیروزی/شکست و راهکارهای آنها را به صورت قطعی (Deterministic) از دادهها بخواند. همچنین، دمو RFPهای پنهان را از این بلوک قطعی فیلتر میکند تا وضعیت «هنوز یاد نگرفته» را شبیهسازی کند. علاوه بر این، ۲۳ مورد RFP دستنویس، ساختگی هستند؛ در حالی که در دنیای واقعی، دلایل پیروزی یا شکست مناقصات به ندرت به سادگی یک ضربالاجل زمانی هستند.
این تغییر در رویکرد، حافظه عامل را از «بازیابی ساده» به «اصلاح فعال باورها» منتقل میکند. برای متخصصان، این بدان معناست که ارزش یک عامل هوش مصنوعی دیگر تنها در دادههایی که میتواند پیدا کند نیست، بلکه در «هارنس» (Harness) یا چارچوبی است که برای تست این موضوع به کار میرود که آیا خروجی مدل با رسیدن شواهد جدید واقعاً تغییر میکند یا خیر.
در حالی که نسخه فعلی از دادههای ساختگی استفاده میکند، هدف نهایی ایجاد یک حلقه بسته است که در آن نتایج واقعی مناقصات به طور خودکار منطق داخلی عامل را بهروزرسانی کنند. کد این پروژه در github.com/manimounika-gubbala/MEMORA در دسترس است. برای پیادهسازی این سیستم، توسعهدهندگان باید از قرار دادن دادههای واقعی در مثالهای پرامپت اجتناب کنند و از چارچوب تست «پنهانسازی-اجرا-افشا» (hide-run-reveal) استفاده کنند تا تأیید شود که عامل واقعاً در حال یادگیری است و نه صرفاً بازیابی داده.
گام بعدی شما
- اگر توسعهدهنده هستید، برای جلوگیری از توهم مدل، هرگز از دادههای واقعی در مثالهای JSON پرامپت استفاده نکنید.
- برای تست یادگیری عاملها، از متد «پنهانسازی-اجرا-افشا» استفاده کنید تا مطمئن شوید مدل در حال استدلال است، نه فقط بازیابی.
- بررسی کنید آیا میتوانید لایه حل تضاد MEMORA را روی دادههای واقعی مناقصات سازمان خود پیاده کنید.
اما این تنها بخشی از معماری حافظه است؛ برای درک اینکه چگونه پنجرههای متنی در حال جایگزینی با بانکهای حافظه پویا هستند، تحلیل ما درباره پروتکل MCP را بخوانید.



گفتگو