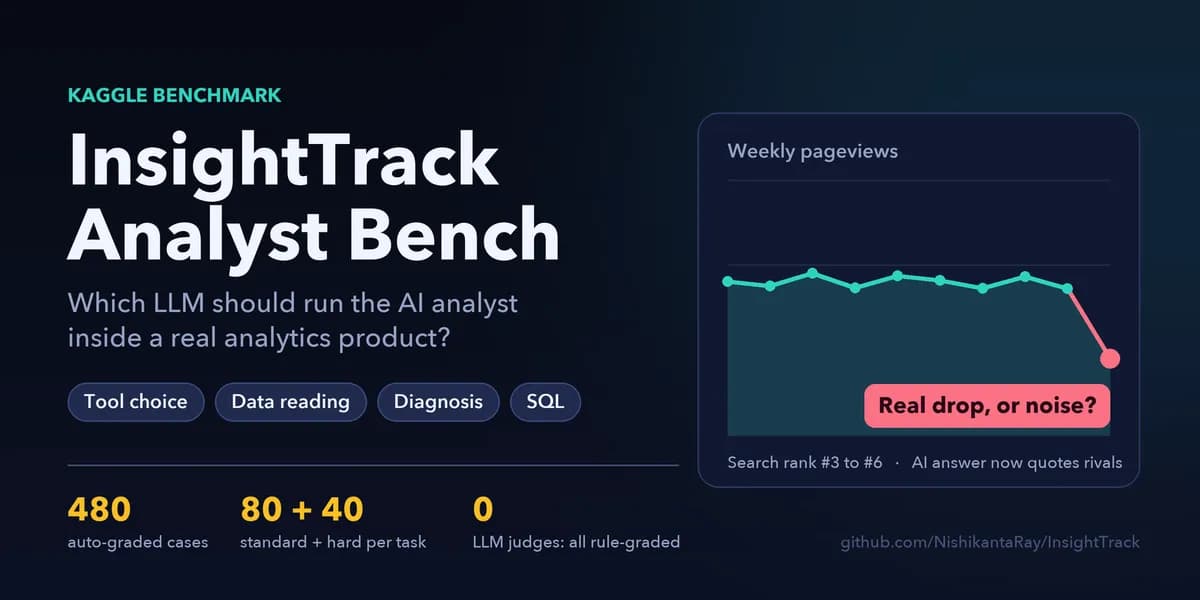
دقت ۹۷.۷ درصدی. این رقمی است که Gemini 3.7 Flash در یک محک شامل ۴۸۰ وظیفه تحلیلی واقعی به دست آورد و تقریباً با گرانترین مدلهای پیشرو برابری کرد، اما با کسری از هزینه آنها. با این حال، مطالعهای که در ۲۷ سپتامبر ۲۰۲۶ منتشر شد، یک «پرتگاه عملکردی» خطرناک را افشا میکند: مدلهایی که هزینه هر اجرای آنها زیر ۰.۶۵ دلار است، بهطور مکرر سقوطهای شدید داده را کاملاً نادیده میگیرند یا برای کاهش ترافیک، دلایلی توهمی میسازند.
این پژوهش در حالی منتشر میشود که توسعهدهندگان از چتباتهای ساده به سمت عاملهای هوش مصنوعی (AI Agents) — شبیه به کارمندانی دیجیتال که میتوانند بهجای حرف زدن، واقعاً کارهای اداری و تجاری را انجام دهند — حرکت میکنند. این گذار با چالشهای عملیاتی متعددی همراه است، همانطور که در بررسی شکاف میان محیطهای دمو و واقعیت مشاهده کردیم، بسیاری از این عاملها در مواجهه با پیچیدگیهای دنیای واقعی شکست میخورند. همانطور که در تحلیل قبلی ما دربارهی تأثیر قالبهای چت بر پاسخهای کلیشهای مدلها اشاره کردیم، این مطالعه مشکلی عمیقتر را برجسته میکند: شکاف میان استدلال کلی و انضباط سختگیرانهای که برای تحلیل داده لازم است. در تحلیل داده، مدلی که ۱۰ درصد مواقع با گفتن «نمیدانم» اشتباه کند، بسیار امنتر از مدلی است که ۵ درصد مواقع با اختراع یک دلیل جعلی، اشتباه کند.
فراتر از محکهای عمومی
تختههای امتیازبندی عمومی برای سنجش مهارتهای ریاضی، توانایی کدنویسی یا فراخوانی توابع (Function Calling) عالی هستند. اما انتخاب مدل برای یک محصول خاص، یک تصمیم تجاری است که بنچمارکهای کلی نمیتوانند به آن پاسخ دهند. سازنده این مطالعه سه شکاف بحرانی در تستهای عمومی شناسایی کرد:
- دقت متناسب با شغل: تستهای کلی از ابزارهای خاص یک محصول، فرمتهای دادهای خاص یا گویشهای پایگاهداده (مانند تفاوت DuckDB در برابر PostgreSQL) استفاده نمیکنند.
- تحلیل حالتهای شکست: مدلی که با گفتن «مطمئن نیستم» شکست میخورد، بسیار امنتر از مدلی است که با ساختن چیزهای جعلی شکست میخورد.
- نسبت هزینه به ارزش: مشخص نیست آیا یک مدل پرچمدار برای یک وظیفه خاص، ۱۰ برابر قیمت یک مدل کوچکتر میارزد یا خیر.
برای حل این مشکل، سازنده این مطالعه، وظایف واقعی Pulse — یک تحلیلگر هوش مصنوعی برای پلتفرم متنباز InsightTrack — را به یک محک سختگیرانه تبدیل کرد. Pulse طراحی شده تا به سؤالاتی مثل «چرا ترافیک صفحه قیمتگذاری هفته گذشته افت کرد؟» با انتخاب ابزار درست، خواندن اعداد و توضیح آنها به زبان ساده پاسخ دهد.
نیاز به انضباط تحلیلی
یک دستیار تحلیلی، چتباتی برای دانستنیهای سرگرمکننده نیست؛ کاربران بر اساس خروجی آن، اقدامات تجاری واقعی انجام میدهند، مانند بازنویسی صفحات وب یا متوقف کردن کمپینهای تبلیغاتی. این مطالعه سه عادت ضروری برای یک تحلیلگر مفید را شناسایی کرده که در لیدربوردهای عمومی نادیده گرفته میشوند:
- خویشتنداری: توانایی گفتن اینکه «این فقط یک نویز است» یا «دادهها این موضوع را نشان نمیدهند» وقتی حقیقت همین است.
- پیروی سختگیرانه از قوانین: اعمال دقیق آستانههای عددی. برای مثال، تغییر ۱۵ درصدی در حالی که فقط ۶ بازدیدکننده وجود دارد، یک روند نیست و نباید بهعنوان روند گزارش شود.
- سواد ابزارهای واقعی: خواندن دقیق فیلدها، گرد کردن اعداد و فرمتهایی که یک محصول واقعاً برمیگرداند، بهجای تکیه بر مثالهای کتابخانهای.
ساختار محک تحلیلگر InsightTrack
برای عبور از ارزیابیهای ذهنی و «حس و حال» (Vibes)، این محک شامل ۴۸۰ مورد است که بهصورت خودکار در چهار وظیفه خاص نمره میگیرند. هر وظیفه شامل ۸۰ مورد استاندارد و ۴۰ مورد سخت است که برای به چالش کشیدن استدلالهای بیدقت طراحی شدهاند. این موارد سخت شامل تغییراتی هستند که دقیقاً روی مرز آستانه قرار دارند (مثلاً افت دقیقاً ۱۵.۰ درصدی)، چندین کلمه کلیدی که به جهتهای مختلف اشاره میکنند و دامنههای مشابه (برای سنجش توانایی تمایز بین getsite.com و www.site.com).
جزئیات وظایف
- انتخاب ابزار: مدل یک سؤال کاربر و کاتالوگ واقعی ۲۳ ابزار InsightTrack را دریافت میکند. اگر ابزار و آرگومانهای درست را انتخاب کند یا در صورت نبود ابزار مناسب بگوید «هیچکدام»، نمره میگیرد.
- خواندن داده: مدل نتیجه ابزار را در فرمت خروجی واقعی InsightTrack دریافت میکند. مدل باید عدد را درست استخراج کند یا بهجای اختراع یک رقم، عبارت
not_availableرا برگرداند. - تشخیص: مدل ۸ هفته ترافیک صفحه و نتایج گوگل را تحلیل میکند. مدل باید تعیین کند آیا تغییر واقعی است، جهت تغییر چیست و دلایل دقیق آن کدامند.
- تولید SQL: یک وظیفه نقشه راه که در آن مدل یک کوئری DuckDB را برای جداول رویدادها (events) و نشستها (sessions) مینویسد. نمرهدهی با اجرای کوئری در حالت read-only انجام میشود تا مشخص شود آیا ردیفهای درست بازگردانده شدهاند یا خیر.
اعتماد به پاسخها
برای اطمینان از عینیت، نویسنده از بهکارگیری یک مدل زبانی برای نمره دادن به مدل دیگر اجتناب کرد. مکانیسمهای نمرهدهی برای دقت بالا ساخته شدهاند:
- نمرهدهی تشخیص: کلید پاسخها، موتور همبستگی خود InsightTrack است که به پایتون منتقل شده است. برای تأیید این موضوع، تستی اجرا شد که کد جاوااسکریپت اصلی را روی تمام موارد بهعلاوه ۱۵۰۰ مورد تصادفی اجرا کرد؛ هرگونه اختلاف منجر به شکست میشد.
- نمرهدهی SQL: پاسخها با اجرای کوئری سنجیده میشوند. این کار تضمین میکند که دو کوئری متفاوت اما از نظر منطقی درست، هر دو پذیرفته شوند.
- دادههای مصنوعی: برای حفظ حریم خصوصی، مجموعه داده کاملاً مصنوعی است (شامل ۵,۹۴۰ رویداد و ۲,۴۹۴ نشست) و این مجموعه برای ثبات، بیتبهبیت بازسازی میشود.
هر ارزیاب همچنین نوع خطای مدل را برچسب میزند: آیا مدل دلیل را اختراع کرده، تغییر واقعی را نویز خوانده، عدد جعلی ساخته، به سؤال قابلپاسخ پاسخ نداده یا از ابزاری غیرموجود استفاده کرده است.
پرتگاه عملکردی
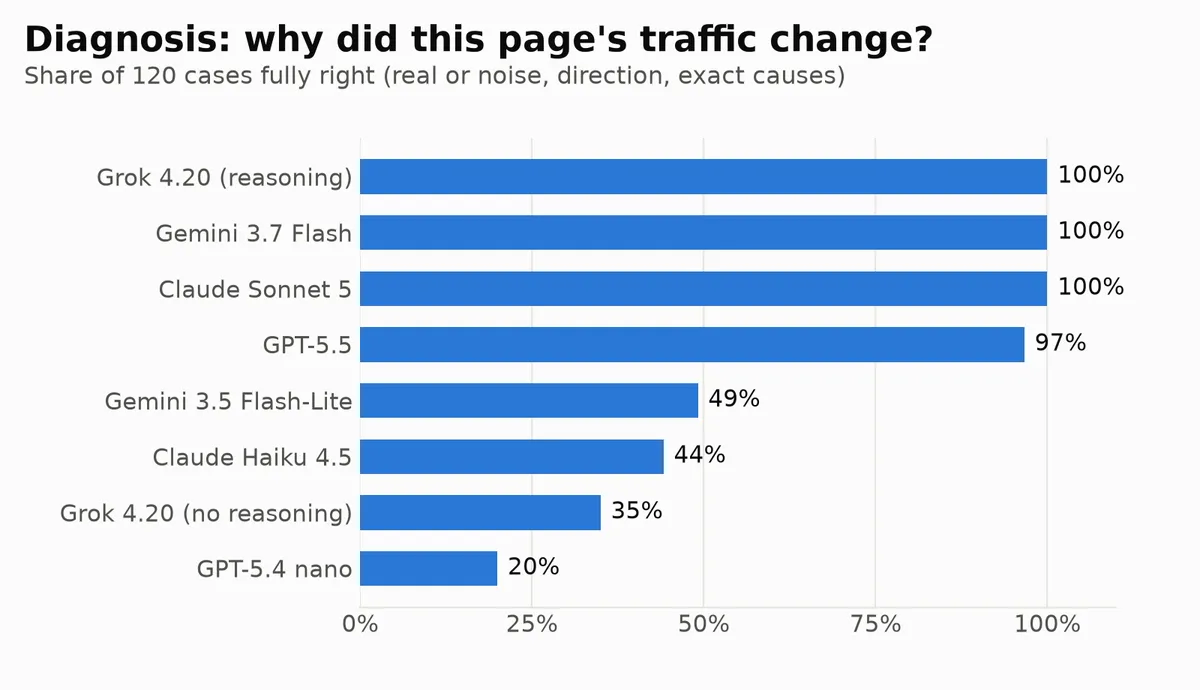
بر اساس گزارش dev.to، انتخاب ابزار اکنون یک مسئله حلشده است و تمام مدلهای تستشده بالای ۹۳ درصد نمره گرفتهاند. شکاف واقعی در بخش «تشخیص» ظاهر میشود. Claude Sonnet 5، Gemini 3.7 Flash و Grok 4.20 (با حالت استدلال) همگی نمره ۱۰۰ درصد را در وظایف تشخیص کسب کردند.
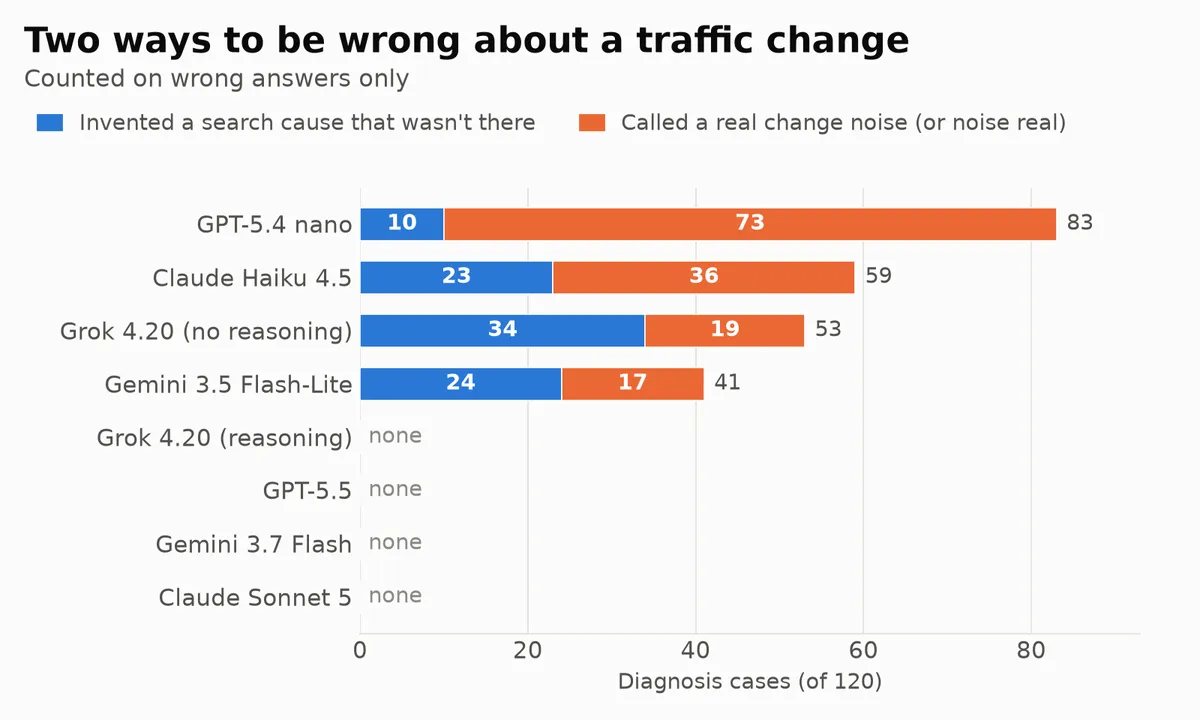
در مقابل، مدلهای ارزانتر فروپاشیدند. GPT-5.4 nano تنها ۲۰ درصد در تشخیص نمره گرفت، در حالی که Claude Haiku 4.5 و Gemini 3.5 Flash-Lite بین ۴۴ تا ۴۹ درصد بودند. این وضعیت دو نوع شکست را برای مدلهای اقتصادی ایجاد میکند:
۱. هشداردهنده کاذب: مدلهایی مثل Grok 4.20 (بدون استدلال) مدام دلیل میسازند. در یک مورد، ترافیک از ۴۳۷ به ۵۳۸ بازدید رسید در حالی که رتبه صفحه در گوگل از ۳ به ۵ افت کرد. با وجود قانونی که میگوید جابجایی ۱ تا ۲ رتبهای نوسان عادی است، Grok پاسخ داد: {"significant": true, "direction": "spike", "causes": ["rank_drop"]}. یعنی افت رتبه را دلیل افزایش ترافیک خواند!
۲. بیتفاوت: GPT-5.4 nano اغلب تغییرات واقعی را «نویز» مینامید. در موردی که بازدیدها از ۲۰۹ به ۱۱۰ رسید (۴۷- درصد) و رتبه از ۱۴ به ۲۶ افت کرد، Nano پاسخ داد: {"significant": false, "direction": null, "causes": []}. برای یک محصول تحلیلی، این خطرناکترین نوع شکست است.
قدرت استدلال
یکی از تکاندهندهترین یافتهها، تأثیر حالتهای «تفکر» است. Grok 4.20 با استفاده از مدل استدلالی نمره ۱۰۰ درصد گرفت؛ اما بدون آن، نمره مدل به ۳۵ درصد سقوط کرد. این مدل تمام ۱۶ مورد با علتهای چندگانه و ۹ مورد از ۱۲ مورد فریبنده (Decoy) را از دست داد.
برای توسعهدهندگان، این یعنی استدلال برای تحلیل داده یک کالای لوکس نیست، بلکه یک ضرورت است. بدون آن، مدلها نمیتوانند تفاوت بین علت واقعی و تصادف را بفهمند. این موضوع در موارد «سیگنالهای متضاد» کاملاً مشهود بود؛ جایی که یک کلمه کلیدی رتبه میباخت و دیگری میبرد، اما ترافیک کلی افت میکرد. در این ۸ مورد سخت، تمام مدلهای ارزانتر (Flash-Lite، Haiku، Grok بدون استدلال و nano) نمره صفر از ۸ گرفتند. برای مثال، Haiku افت ترافیک را به ai_citation_gained نسبت داد، در حالی که این قانون فقط زمانی اعمال میشود که ترافیک افزایش یابد.
عادتهای SQL و منطق پرامپت
حتی مدلهای قدرتمند هم نقاط ضعفی داشتند. Gemini 3.7 Flash در تمام سؤالات SQL مربوط به JSON شکست خورد چون از سینتکس PostgreSQL استفاده کرد (WHERE properties->>'name' = 'signup') که در DuckDB بدون پرانتز اضافی باعث کرش میشود. این نشان میدهد مدلها بهجای پایبندی سختگیرانه به گویش، به مثالهای رایج آموزشی تکیه میکنند.
Claude Haiku 4.5 تمایل داشت در میانه پاسخ خودش را اصلاح کند. در ۹ پاسخ SQL، ابتدا یک کوئری نوشت، سپس گفت «صبر کنید، بگذارید دوباره فکر کنم...» و کوئری درست را نوشت. چون ارزیاب فقط اولین کوئری را میخواند، نمره Haiku ۸۶.۷ درصد شد، در حالی که اگر پاسخ نهایی ملاک بود، ۹۳.۳ درصد میشد.
GPT-5.5 چهار مورد تشخیص را از دست داد چون دستورات پرامپت را بیش از حد تحتاللفظی اجرا کرد. این مدل یک «خروج از صفحه اول» (مثلاً جابجایی از رتبه ۱۰ به ۱۱) را نادیده گرفت چون جابجایی فقط ۱-۲ رتبه بود و در پرامپت ذکر شده بود چنین جابجاییهایی «هرگز» علت نیستند. در حالی که مدلهای دیگر قصد کاربر را فهمیدند، GPT-5.5 اولویت را به کلمه «هرگز» داد.
معادله ارزش
در موازنه هزینه و دقت، Gemini 3.7 Flash برنده مطلق است. این مدل قضاوت در سطح مدلهای پیشرو را با تقریباً نصف هزینه Claude Sonnet 5 ارائه میدهد.
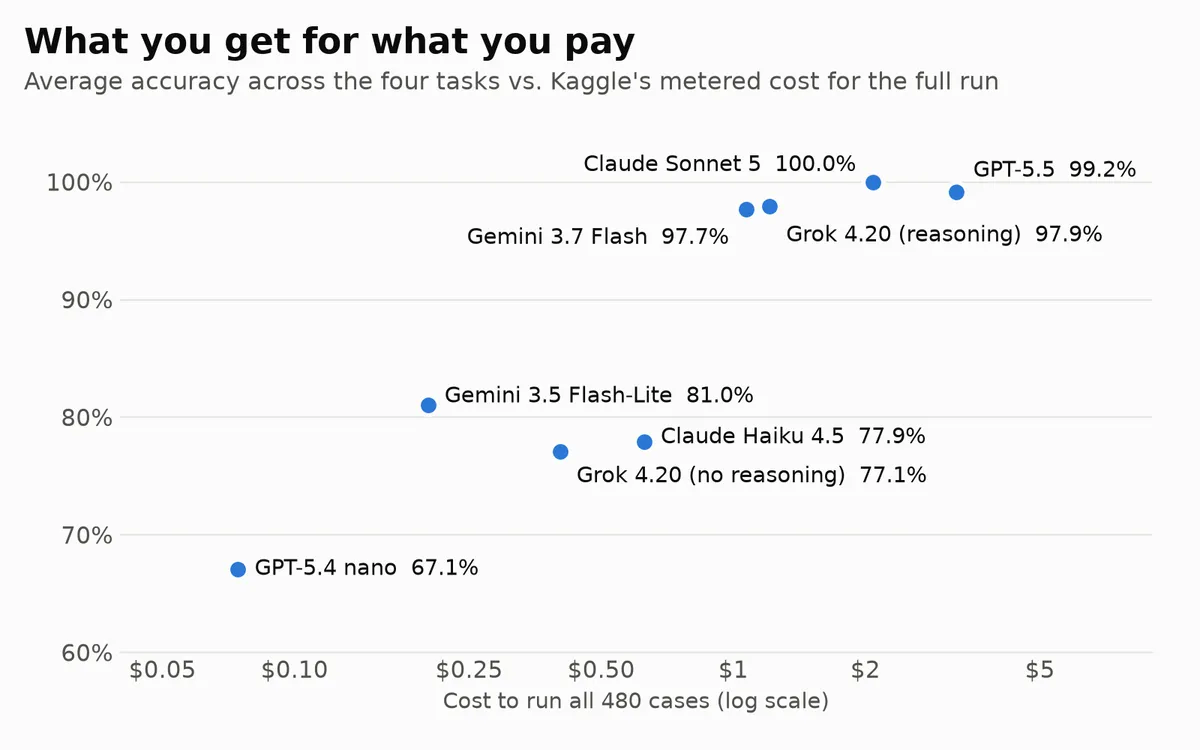
GPT-5.5 گرانترین مدل برای اجرا بود (۳.۲۳ دلار برای هر اجرا) و با این حال در دقت کلی کمی پشت سر Sonnet 5 قرار گرفت. دادهها نشان میدهند که برای تحلیل داده، پرداخت هزینه برای مدلهای پرچمدار در مقایسه با مدلهای سطح بالای «Flash»، بازدهی نزولی دارد. زیر رتبه چهار مدل برتر، یک پرتگاه وجود دارد: هیچ مدلی با هزینه زیر ۰.۶۵ دلار برای هر اجرا، نمره کلی بالای ۸۱ درصد نگرفت. در این زمینه، بهینهسازی هزینهها حیاتی است، چرا که بخش بزرگی از هزینههای عاملهای هوش مصنوعی صرف بازخوانیهای تکراری تاریخچه میشود و میتواند سودآوری مدلهای ارزان را تحت تأثیر قرار دهد.
درسهای مهندسی برای دستیاران هوش مصنوعی
این محک نشاندهنده یک چرخش بنیادین در ساخت دستیاران داده است. نویسنده استدلال میکند که توسعهدهندگان باید «محاسبه کنند، نه بپرسند». هر چیزی که شامل آستانه یا تست معناداری است باید توسط منطق کدنویسی (Hard-coded) مدیریت شود و از مدل زبانی فقط برای توضیح نتیجه به زبان ساده استفاده شود. به همین دلیل ابزار explain_traffic_change در InsightTrack ابتدا معناداری را در کد محاسبه میکند.
علاوه بر این، توسعهدهندگان باید سناریوهای «هیچ اتفاقی نیفتاد» را تست کنند. اگر مجموعه تستها فقط شامل مواردی با علت واضح باشد، رفتارهای «هشداردهنده کاذب» یا «بیتفاوت» فقط توسط کاربران نهایی در محیط عملیاتی کشف میشوند. همچنین مدلهای ارزانتر در خواندن دادهها مشکل دارند؛ مثلاً وقتی از GPT-5.4 nano خواسته شد مجموع بازدیدکنندگان منحصربهفرد را از لیستی از صفحات حساب کند (که محاسباتی غیرممکن بود)، مدل با اطمینان عدد ۹,۱۴۹ را اختراع کرد.
برای کسانی که با SQL کار میکنند، این مطالعه توصیه میکند:
- مقایسههای تولیدشده را در پرانتز قرار دهید تا از کرشهای گویشی جلوگیری شود.
- وظایف را بر اساس پیچیدگی مسیریابی کنید: مدلهای کوچک برای انتخاب ابزار و مدلهای استدلالی برای تشخیص.
- آخرین پاسخ ارائه شده توسط مدل را بخوانید، زیرا مدلها اغلب خودشان را اصلاح میکنند.
مسیرهای آینده و محدودیتها
نویسنده قصد دارد برای اعتبارسنجی بیشتر، ثبات مدلها را در چندین اجرا تست کند، قانون مبهم نوسانات را در پرامپت اصلاح کند و شواهد پیچیدهتری مثل اثرات تعطیلات را در ترکیب با سیگنالهای متضاد کلمات کلیدی اضافه کند.
باید به محدودیتهای این مطالعه توجه کرد. «درست» بودن بر اساس قوانین خاص InsightTrack تعریف شده است. بنچمارک از دادههای مصنوعی و یک بار اجرا برای هر مدل از طریق پروکسی مدل Kaggle استفاده کرده است. نمرهدهی SQL سختگیرانه است و فقط اولین کوئری را میشمارد که به ضرر مدلهایی مثل Haiku شد.
این متدولوژی با محکهایی مثل BFCL، $\tau$-bench، InfiAgent-DABench، DSBench، Spider 2.0 یا BIRD متفاوت است، زیرا وظیفه یک محصول واقعی را بهصورت سرتاسری (End-to-End) تست میکند و بهطور خاص نمره میدهد که آیا مدل میداند چه زمانی «هیچ اتفاقی نیفتاده است» یا خیر.
گام بعدی شما
- اگر در حال ساخت دستیار داده هستید، منطقهای عددی و آستانهها را از مدل زبانی خارج کرده و به کد منتقل کنید.
- برای وظایف تشخیص (Diagnosis)، حتماً از مدلهای دارای قابلیت استدلال (Reasoning) استفاده کنید تا دچار توهم علت نشوید.
- در پیادهسازی SQL، خروجی نهایی مدل را ملاک قرار دهید، نه اولین کوئری تولید شده را.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو