اگر امروز برای اجرای مدلهای زبانی هزینه میپردازید، احتمالاً متوجه شدهاید که سرعت پاسخدهی و هزینه استنتاج، بزرگترین موانع مقیاسپذیری کسبوکار شماست. حالا Gimlet Labs با جذب ۳۰۰ میلیون دلار سرمایه در دور سری B، ادعا میکند که راهکار این بنبست را در تغییر بنیادین سختافزار یافته است.
این سرمایهگذاری که توسط Andreessen Horowitz و کنسرسیومی عظیم از سرمایهگذاران تراز اول رهبری شده، یک شرطبندی استراتژیک روی این فرض است که رویکرد «یک سختافزار برای همه کارها» (one-size-fits-all) دیگر پاسخگو و پایدار نیست. این رویکرد در راستای استراتژیهای کلان سرمایهگذاران بزرگی است که به تازگی میلیاردها دلار برای زیرساختهای فیزیکی هوش مصنوعی اختصاص دادهاند تا گلوگاههای سختافزاری را برطرف کنند. در کنار Andreessen Horowitz، نامهای بزرگی چون Sapphire Ventures، Menlo Ventures، 645 Ventures، Arm، Eclipse، Emergence، Factory، Hudson River Trading، M12، OnePrime Capital، Prosperity7، QuantumLight، Samsung Ventures، Tiger Global Management، Triatomic، Wing Ventures و XTX Markets در این دور تأمین مالی حضور دارند.
طبق اعلام این شرکت، از ماه مارس تاکنون میلیاردها دلار درآمد قراردادی و ظرفیتهای عظیم مرکز داده به سبد آنها اضافه شده است. در حال حاضر، Gimlet با سرعتی بالا در حال مقیاسبندی به سمت مدیریت صدها مگاوات ظرفیت محاسباتی است.
بسیاری از شرکتهای هوش مصنوعی در حال حاضر برای استنتاج (Inference) — که مثل لحظهٔ نهایی آشپزی است، نه دورهی آموزش آشپز — از همان سختافزارهای سنگین آموزش مثل GPUهای ردهبالا استفاده میکنند. این روش بهشدت ناکارآمد است؛ زیرا نیازهای یک مدل در حین پردازش یک درخواست، بهطور مداوم تغییر میکند. این وضعیت درست مثل این است که برای جابهجایی یک تکه آجر، از یک جرثقیل غولپیکر استفاده کنید؛ کار انجام میشود، اما انرژی و زمان زیادی تلف میشود.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی هزینههای مدلهای بازمتن اشاره کردیم، صنعت در حال برخورد با یک دیوار فیزیکی است. Gimlet Labs استدلال میکند که استنتاج اکنون به بار کاری غالب در دنیای نرمافزار تبدیل شده است. به گزارش این شرکت، مراکز دادهٔ هوش مصنوعی در سال ۲۰۲۵ حدود ۱۸ گیگاوات ظرفیت مصرف کردهاند و پیشبینی میشود این تقاضا تا سال ۲۰۳۰ سه برابر شود. در واقع، برق به اصلیترین گلوگاه رشد و مقیاسپذیری هوش مصنوعی تبدیل شده است.
ابعاد بحران انرژی و توکن
تقاضا برای تولید توکن (Token) — تکههای کوچکی از متن که مدل مثل برشهای کیک میخورد — با سرعتی سرسامآور در حال رشد است. طبق دادههای منتشر شده، تولید ماهانه توکنها در ۱۲ ماه گذشته ۶ برابر شده و برخی پیشبینیها حاکی از آن است که تا سال ۲۰۳۰، این رقم ۲۰ برابر شود.
برای پشتیبانی از این رشد، صنعت یکی از جاهطلبانهترین پروژههای سرمایهگذاری تاریخ را آغاز کرده است. هزینهها در حال حاضر به سالانه نزدیک ۱ تریلیون دلار رسیده و انتظار میرود تا سال ۲۰۳۰ مجموعاً ۷ تریلیون دلار هزینه شود. این رشد خیرهکننده نیازمند تولید برق گسترده، افزایش ظرفیت شبکههای توزیع، ایجاد اتصالات جدید و تولید انرژی در پشت کنتور (behind-the-meter) است.
استراتژی چند-سیلیکونی (Multisilicon)
برای شکستن این بنبست، Gimlet Labs در حال ساخت یک «ابر چند-سیلیکونی» است. آنها بهجای تکیه بر یک نوع تراشه واحد، زیرساختی را ادغام میکنند که شامل موارد زیر است:
- GPU برای محاسبات موازی عظیم.
- محاسبات نزدیک به حافظه (Near-memory compute) برای کاهش جابهجایی دادهها.
- معماریهای جریان-داده (Dataflow) برای پردازش بهینه و جریانیافته.
- CPU برای منطقهای عمومی.
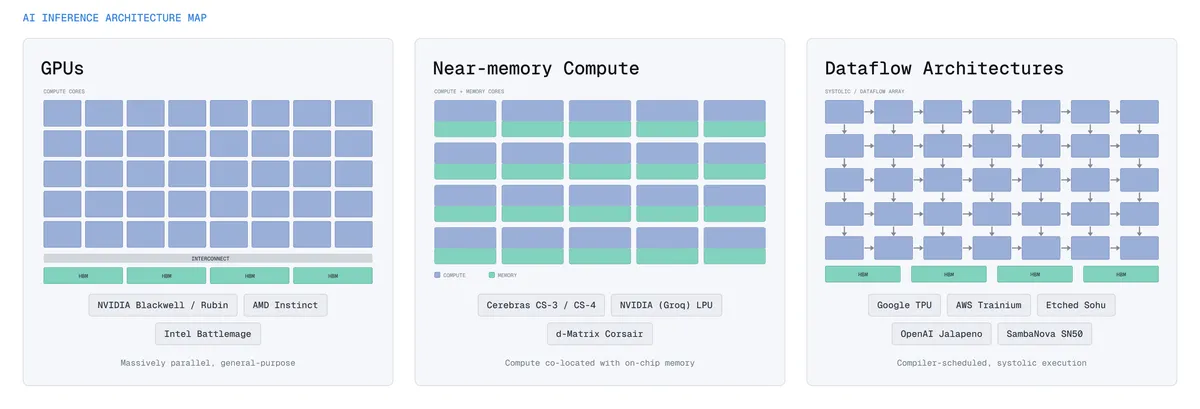
نوآوری اصلی در لایه نرمافزاری آنهاست که «تجزیه ناهمگن» (heterogeneous disaggregation) را انجام میدهد. این سیستم مدل هوش مصنوعی را ردیابی کرده، آن را به قطعات کوچکتر تقسیم میکند و سپس هر قطعه را روی معماری تراشهای زمانبندی میکند که برای آن عملیات خاص، بیشترین بازدهی را دارد. این تلاش برای بهینهسازی سختافزاری، مشابه رقابتهای شدیدی است که در بازار تراشههای تخصصی میبینیم؛ برای مثال ارزش شرکت Etched پس از تستهای سختافزاری موفق به دلیل تمرکز بر معماریهای بهینه برای استنتاج، جهش چشمگیری داشت.
حل تضاد میان توان عملیاتی و تأخیر
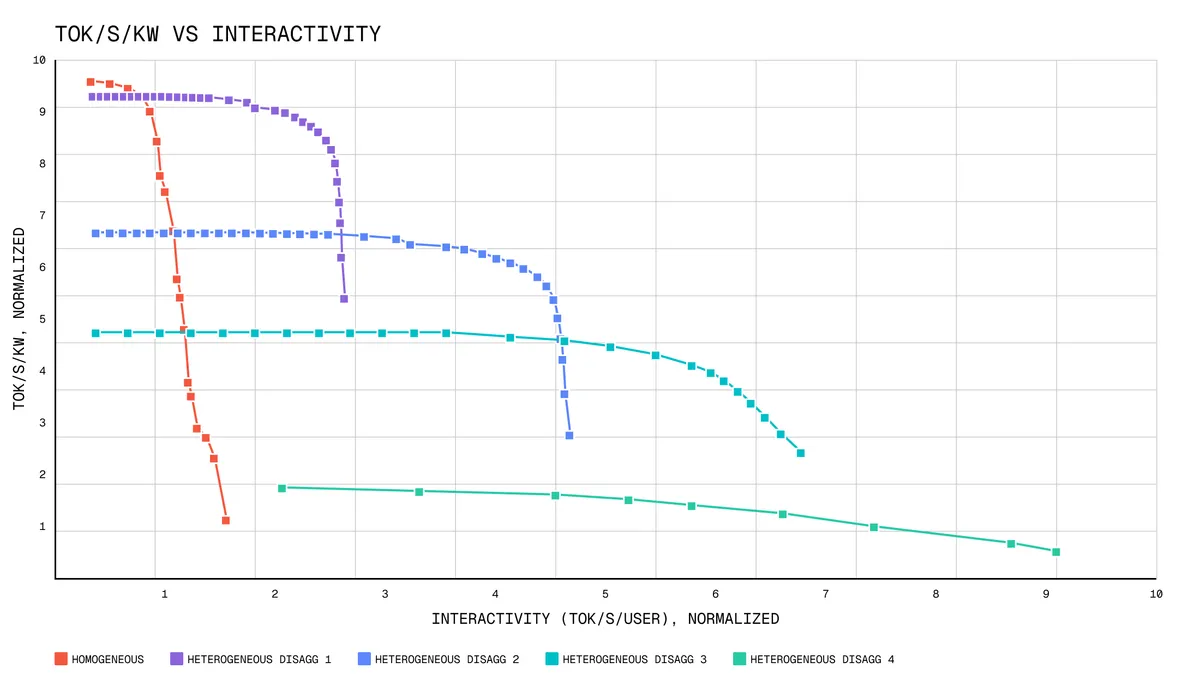
بهطور سنتی، توسعهدهندگان باید بین توان عملیاتی (Throughput - پردازش درخواستهای زیاد) یا تأخیر (Latency - زمان پاسخدهی سریع) یکی را انتخاب میکردند. این تضاد معمولاً با نمودار پارتو (Pareto chart) تعاملی-توان عملیاتی نشان داده میشود که نشان میدهد تیمها مجبور به پذیرش چه مصالحاتی هستند.
Gimlet Labs مدعی است که رویکرد تجزیه شده آنها در بارهای کاری پیشرفته، ۳ تا ۱۰ برابر سریعتر از سیستمهای سنتی و یکدست (homogeneous) است. این سرعت برای سه روند نوظهور حیاتی است:
۱. بارهای کاری عاملمحور (Agentic): عاملها (Agents) — مثل دستیاران هوشمندی که میتوانند بهتنهایی چندین مرحله را برای رسیدن به هدف طی کنند — نیاز به دهها فراخوانی متوالی مدل و تعامل با ابزارها دارند. اگر هر مرحله کند باشد، تأخیر کلی انباشته شده و عامل کند به نظر میرسد.
۲. مدلهای عظیم: مدلها در عرض چند سال از چند صد میلیارد پارامتر به ۳ تا ۱۰ تریلیون پارامتر رسیدهاند.
۳. پنجرههای متنی بزرگ: پنجره متنی (Context Window) — میزان متنی که مدل در لحظه در ذهن دارد — از حدود ۱۰۰ هزار توکن در سال ۲۰۲۳ به بیش از ۱ میلیون توکن در امروز رسیده است.
متدهای فنی تجزیه بار کاری
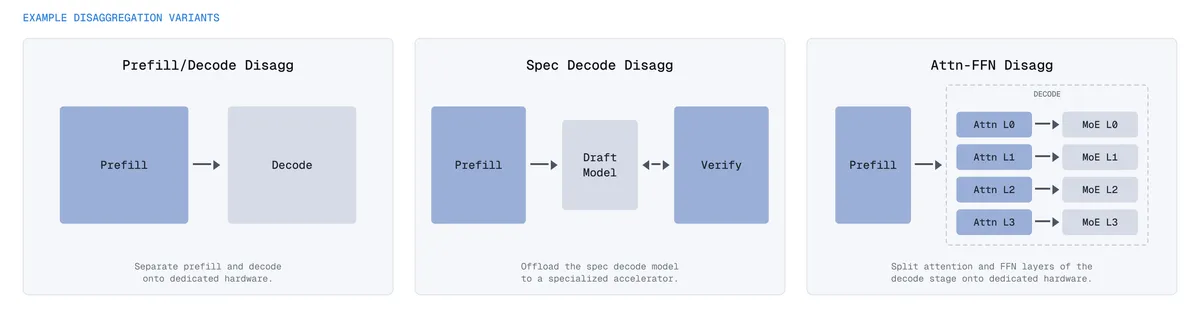
بر اساس مستندات Gimlet Labs، این شرکت از چندین روش برای تقسیم بار کاری استفاده میکند. مدلها ردیابی و تجزیه شده و بر اساس سختافزارهای موجود و توافقنامههای سطح خدمات (SLA) زمانبندی میشوند:
- تجزیه پیشپُرکردن/رمزگشایی (Prefill/Decode): شناختهشدهترین روش است. مرحله پیشپُرکردن (Prefill) که وابسته به قدرت محاسباتی (compute-bound) است روی یک مجموعه دستگاه و مرحله رمزگشایی (Decoding) که وابسته به پهنای باند حافظه (memory-bandwidth bound) است روی مجموعهای دیگر اجرا میشود. این روش کمترین تأخیر را ارائه میدهد.
- تجزیه رمزگشایی گمانهزنانه (Speculative-Decode): تکنیکی که در مقایسه با استقرارهای یکدست، سرعت بیشتر و توان عملیاتی بالاتری فراهم میکند.
- تجزیه توجه/FFN (Attention-FFN): روشی دیگر برای بهینهسازی اجزای ریاضی خاص مدل.
با بازتوزیع پویا، هیچ بخشی از سختافزار «سرگردان» یا بلااستفاده نمیماند. برای مثال، اگر بار کاری به نمونههای رمزگشایی بیشتری نیاز داشته باشد و سختافزار اصلی پر باشد، این نمونهها میتوانند روی سایر سختافزارهای موجود اجرا شوند. این قابلیت اجازه میدهد تا در همان مصرف انرژی قبلی، به سرعت ۵ تا ۱۰ برابر دست یافت.
چرخش اقتصادی زیرساخت
این رویکرد، صنعت را از مسیر استفاده مجدد از سختافزارهای استخراج رمزارز یا سختافزارهای آموزش برای استنتاج دور میکند. Gimlet Labs معتقد است زیرساخت هوش مصنوعی باید از پایه بازطراحی شود چون استنتاج اساساً با آموزش متفاوت است.
با ساخت زیرساختی که بهطور خاص برای استنتاج طراحی شده، Gimlet هدف خود را روی آن ۷ تریلیون دلار سرمایهگذاری تجمعی در زیرساختهای هوش مصنوعی تا سال ۲۰۳۰ قرار داده است. برای کاربر نهایی، این یعنی «تعاملی بودن» هوش مصنوعی بهبود مییابد. ما به سمتی میرویم که مدلهای تریلیون-پارامتری بدون نیاز به یک نیروگاه اختصاصی برای هر چند خوشه، فوراً پاسخ دهند.
با پذیرش این مدل چند-سیلیکونی توسط آزمایشگاههای پیشرو و مصرفکنندگان در مقیاس بزرگ، هزینه هر توکن بهشدت کاهش خواهد یافت. برنده نهایی مسابقه هوش مصنوعی کسی است که بتواند بیشترین توکن را به ازای هر کیلووات برق تولید کند.
منتظر انتشار گزارشات فنی آتی Gimlet درباره انواع جدید تجزیه بار کاری باشید، چرا که میتواند نحوه استقرار مدلهای پیشرفته در مقیاس بزرگ را دوباره تعریف کند.
گام بعدی شما
- اگر در حال طراحی سیستمهای عاملمحور هستید، روی کاهش تأخیر در فراخوانیهای متوالی تمرکز کنید.
- تغییرات قیمت APIهای مدلهای پیشرو را زیر نظر بگیرید تا اثر کاهش هزینه استنتاج را بسنجید.
- معماریهای جایگزین GPU برای استنتاج را در نقشه راه فنی خود بگنجانید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو