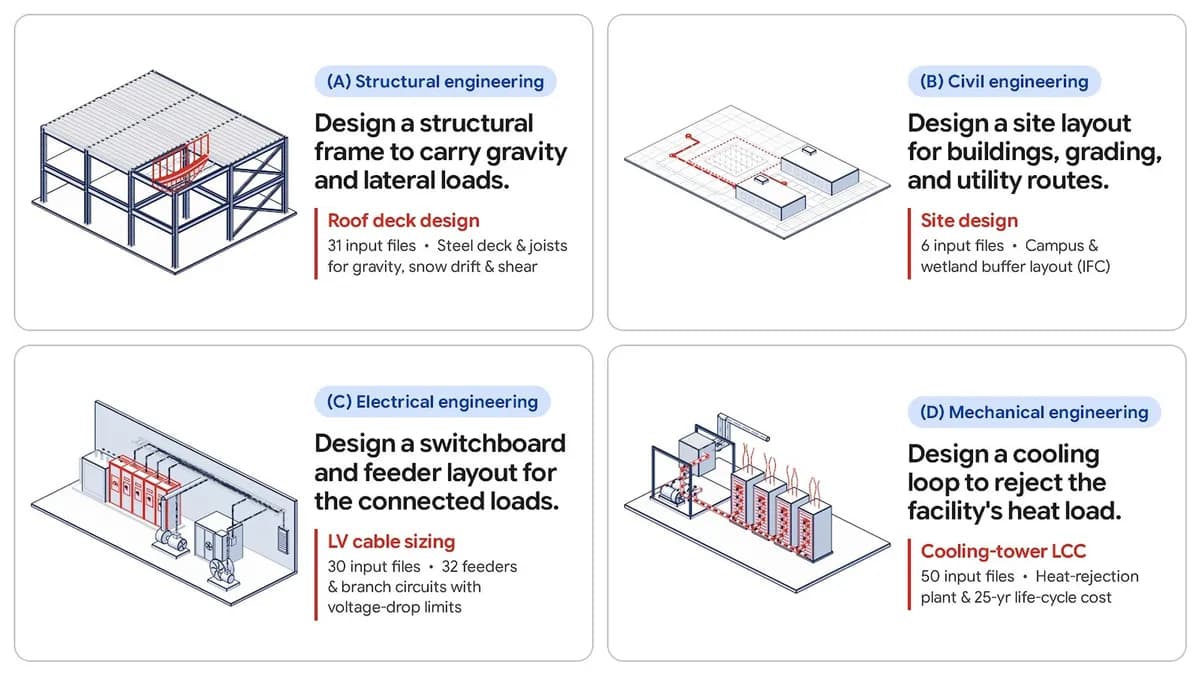
گوگل بنچمارک PLE را با ۸۵ وظیفه مهندسی مکانیک، الکتریکال، سیویلی و ساختاری منتشر کرد. قویترین پیکربندی، کلاد اپاس ۵.۵ در کلاد کد، ۹۱ درصد محدودیتهای منفرد را برآورده میکند اما تنها ۴۱ درصد تحویلها تمام گیتهای سخت ایمنی و امکانسنجی را میگذراند.
بنچمارک PLE: تحویلهای حرفهای به جای پرسشوپاسخ
PLE از عاملها میخواهد در پوشههای پروژه واقعی — PDF، اسپردشیت، طراحیهای CAD، مدلهای BIM — پیمایش کنند و یادداشتهای مهندسی، کتابچههای محاسبه و برنامههای تجهیزات را برای بازبینی مجوزدار آماده کنند. این رویکرد از محکهای پرسشوپاسخ کتابی فاصله میگیرد و انطباق بستهبندی کامل را معیار میگذارد.
ترکیب وظایف و روش امتیازدهی
بنچمارک شامل ۳۰ وظیفه مکانیک، ۲۷ وظیفه الکتریکال، ۱۸ وظیفه سیویلی و ۱۰ وظیفه ساختاری است. هر وظیفه در میانگین ۶۱ فایل دارد و کل ۵۱۷۰ فایل را پوشش میدهد. گوگل این محک را با مرکور (Mercor) روی پلتفرم آرشیپلاگو (Archipelago) ساخته است. مهندسین ممارس ۴۴ وظیفه را از ابتدا تا پایان نگارش کردهاند، شامل پوشههای پروژه، پرامپتها و رابریکهای (rubric) امتیازدهی وزنی. برای ۴۱ وظیفه همنوشته (co-authored)، یک خط لوله سازنده-حلکننده (Creator–Solver) خصمانه محیطها و گریدریهای (grader) اجرایی را از مواد واقعی قابلاجازه ساخته و متخصصان آنها را اعتبارسنجی و دشواری را افزایش دادهاند. هیچ اطلاعات مالکیتی یا محرمانه مشتری در وظایف وجود ندارد.
امتیازدهی دوگانه است:
- وظایف نگارششده توسط متخصص: رابریکهای وزنی بر اساس شواهد در فایلهای تحویلشده.
- وظایف طراحی همنوشته: انطباق محدودیت بهعلاوه اهداف اقتصادی؛ یک گیت سخت ایمنی ناموفق، تمام اعتبار هدف را منتفی میکند. همین مدل در محک دیگری نیز ارزیابی شده است؛ محققان SemiAnalysis در بنچمارک GDPx عملکرد کلود اپاس ۵.۵ را در ۱۱ وظیفه عاملانمحور سنجیدهاند.
نتایج پایه: شکاف انطباق ۵۰ درصدی
گوگل ۱۴ مدل با هفت هارنس (harness) عامل عمومی را روی یک مجموعه آزمون خصوصی (test set) ۵۶-وظیفهای ارزیابی کرد. هر مدل در هارنس بومی خود زیر ۵۰ درصد نمره گرفت، پیشرو کلاد اپاس ۵.۵ در کلاد کد با ۴۸.۳ درصد. در تمام ۸۵ وظیفه، همان پیکربندی به ۵۰.۶ درصد رسید، با میانگین ۲۷ میلیون توکن (token)، ۶۳ دقیقه و ۱۷.۱۸ دلار هر وظیفه به قیمتهای لیست (list prices). دو رقم پیشرو ارزیابیهای مختلف را توصیف میکنند: مجموعه آزمون پنهان با هارنسهای بومی در برابر بنچمارک کامل با جفت مدل-هارنس قویترین.
شکاف انطباق در وظایف همنوشته بیشترین وضوح را دارد. قویترین پیکربندی ۹۱ درصد محدودیتهای منفرد را برآورده کرد، اما تنها ۴۱.۳ درصد اقلام تحویل از هر گیت سخت ایمنی و امکانسنجی که برای اعتبار هدف لازم بود، عبور کردند. به زبان عملی، عاملها اغلب اکثر الزامات را درست میکنند بدون اینکه یک طراحی کاملاً مطابق تولید کنند. گوگل در موازی، محیط توسعه اندروید را نیز برای دهها عامل باز کرده تا اکوسیستم عاملهای کدنویسی در اندروید استودیو گسترش یابد.
واریانس اجرا و اثر انتخاب مدل
گوگل طیف حدود ۵۰ امتیازی در سراسر مدلها در برابر طیف میانه سه امتیازی در سراسر هارنسها برای یک مدل مشابه گزارش میدهد. نتایج وظایف منفرد بهشدت متغیر بود، با طیف میانگین سه-اجرایی ۱۵.۴ امتیاز برای یک سلول وظیفه-هارنس. آن واریانس (variance) از استفاده نویسندگان از میانگین اجراهای تکراری بهجای تلاشهای تکی حمایت میکند. ظرفهای حلکننده (solver containers) دسترسی به اینترنت نداشتند و به هر اجرا شش ساعت زمان عامل اجازه میداد. داوری رابیک و امتیازدهی اجرایی خارج از ظرف حلکننده رخ داد.
مسابقه باز: ارزیابی کل سیستم عامل
مسابقه PLE را به ۲۹ وظیفه توسعه عمومی و ۵۶ وظیفه آزمون پنهان تقسیم میکند. شرکتکنندگان هارنس عامل، انتخاب مدل و مصنوعات وظایف عمومی را ارسال میکنند. برگزارکنندگان مصنوعات را امتیازدهی میکنند، هارنس را روی وظایف عمومی نمونهبرداریشده مجدداً اجرا تا بازتولید (reproduction) را تایید کنند، سپس آن را سه بار روی وظایف پنهان برای نمره لیدربورد (leaderboard) اجرا میکنند. شرکتکنندگان میتوانند از ۱۳ مدل حمایتی گوگل بهصورت رایگان، کلید API تجاری، یا سرور خودمیزبان استفاده کنند. مخزن آپاچی ۲.۰ (Apache-2.0) شامل ورودیهای آغازین (starter entries) برای هارنسهای سفارشی و آداپتورهای (adapters) عاملهای موجود است.
پیامد برای اتوماسیون مهندسی
این بنچمارک ارزیابی عامل را حول انطباق بستهبندی کامل در برابر دقت پاسخ نهایی بازتعریف میکند. عاملی که ۹۰ درصد محدودیتها را برآورده کند اما یک بررسی ایمنی ساختاری را از دست بدهد، یک طراحی غیرقابلاستفاده تولید میکند — یک حالت شکست که محکهای سنتی پنهان میکنند. هزینه ۱۷ دلاری هر وظیفه و واریانس ۱۵ امتیازی بین اجراها، پایهای محسوس برای محاسبه ROI در گردشکارهای حرفهای فراهم میکند. برای سازمانهایی که هوش مصنوعی را برای اتوماسیون مهندسی ارزیابی میکنند، PLE اولین معیار استاندارد برای سنجش اینکه آیا یک عامل میتواند تحویلهای قابلاجازه (licensable deliverables) تولید کند، نه فقط متن قابلقبول، است.
وظایف عمومی و ظرف ارزیابی اکنون در مخزن رسمی در دسترس هستند. مهندسین و پژوهشگران هوش مصنوعی باید هارنسهای خود را در برابر ۲۹ وظیفه توسعه تست کنند تا بسنجند سیستمهایشان در طیف محدودیت-در-برابر-ایمنی کجا قرار میگیرند. لیدربورد با ورود ارسالها بهروزرسانی خواهد شد، یک نمای زنده از اینکه کدام معماریها شکاف انطباق را اولین میبندند، ارائه میدهد.
گفتگو