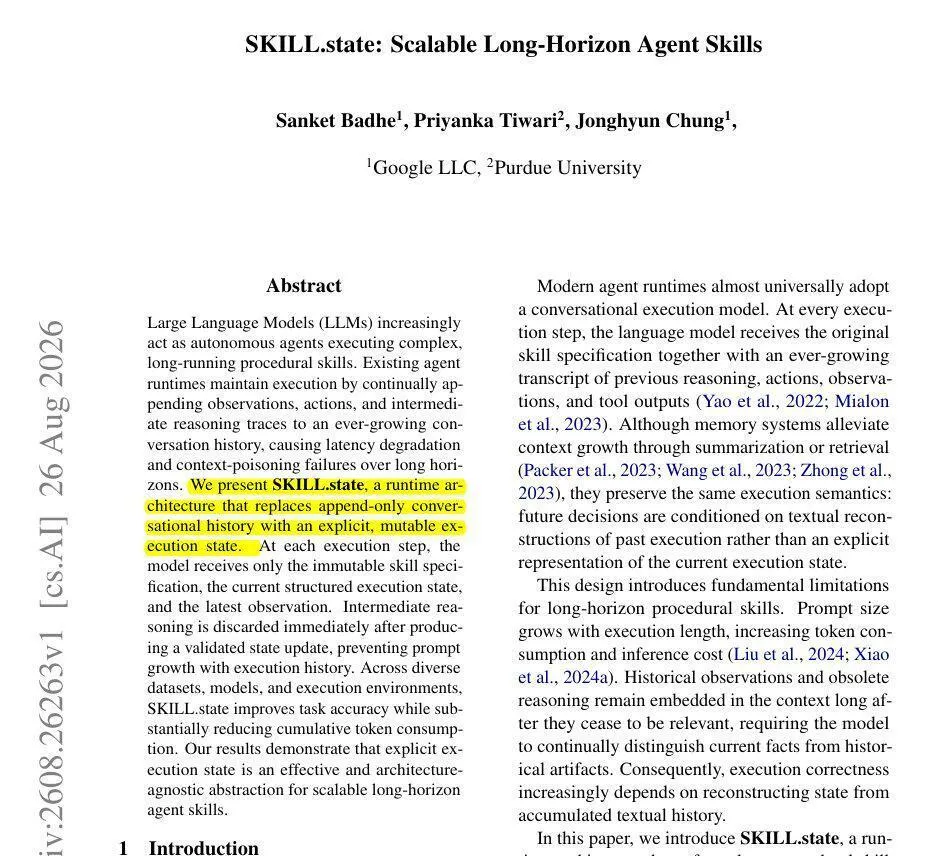
اگر امروز برای مدیریت پروژههای طولانی از عاملهای هوش مصنوعی استفاده میکنید، احتمالاً با کندی شدید و هزینههای نجومی در پایان هر جلسه مواجه شدهاید. گوگل با معرفی مکانیزم SKILL.state، این سد هزینه را با کاهش ۹۴ درصدی مصرف توکن در جلسات طولانی شکست داد. این عدد خیرهکننده، نتیجهی تغییر بنیادین در نحوه مدیریت حافظه توسط عاملهاست.
این متد اساساً نحوه مدیریت حافظه در عاملها را تغییر میدهد. به جای روش سنتی که در هر گام، تمام تاریخچه گفتگو دوباره به مدل تزریق میشود، گوگل از یک نمایش ساختاریافته برای مدیریت وضعیت استفاده میکند. این تغییر، پارادایم مدیریت جلسات طولانی در هوش مصنوعی زاینده (Generative AI) را دگرگون میکند و به جای تکیه بر حجم داده، بر کیفیت استخراج داده تمرکز دارد.
صنعت سالهاست با «مالیات پنجره زمینه» دستوپنجه نرم میکند. هرچه گفتگو طولانیتر شود، تعداد توکن (Token) — تکههای کوچکی از متن، مثل برشهای یک کیک طولانی که مدل تکهتکه میخورد — برای حفظ بستر متن بهصورت نمایی افزایش مییابد. این رشد نمایی، یک ناکارآمدی ذاتی در روشهای مبتنی بر تاریخچه است. نتیجه این است: هزینهها بالا میرود، پاسخها کند میشوند و مدل در نهایت به دلیل رسیدن به محدودیتهای حافظه، دچار افت عملکرد شدید میشود.
تصور کنید یک عامل مدیریت پروژه، هر بار که از او وضعیت کار را میپرسید، مجبور باشد تمام ایمیلها و پیامهای سه ماه گذشته را از اول بخواند تا بتواند یک پاسخ ساده بدهد. این دقیقاً همان روش سنتی است که در آن مدل در هر مرحله، کل تاریخچه را بازخوانی میکند. SKILL.state این روند را تغییر میدهد و به جای متن خام و طولانی، یک «وضعیت» (State) فشرده — شبیه به یک خلاصه مدیریتی و تقطیر شده از شرایط فعلی — را نگه میدارد. با جایگزینی کل تاریخچه گفتگو با یک نمایش ساختاریافته از وضعیت فعلی و آخرین مشاهده، سامانه از سربار محاسباتی پردازش جزئیات غیرمرتبط اجتناب میکند. همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی حافظه مدلها اشاره کردیم، حذف جزئیات غیرضروری، کلید مقیاسپذیری است.
چهار ستون بهرهوری توکن
به نقل از تحلیل فنی منتشر شده در ۳۰ اوت ۲۰۲۶ در وبسایت dev.to، این سامانه بر چهار محور اصلی استوار است که هر کدام نقش حیاتی در کاهش مصرف منابع دارند:
ردیابی وضعیت (State Tracking): سامانه تاریخچه کامل را با یک نمایش ساختاریافته از وضعیت فعلی و آخرین مشاهده جایگزین میکند. این کار دادههای تکراری را حذف کرده و اندازه ورودی را فوراً کوچک میکند. با تمرکز تنها بر اطلاعات ضروری، سامانه از سربار محاسباتی پردازش جزئیات بیربط میپرهیزد. این تحول بسیار کلیدی است؛ زیرا مستقیماً رشد نمایی توکنها را که در رویکردهای سنتی وجود داشت، خنثی میکند و به صرفهجوییهای محاسباتی قابل توجهی منجر میشود. زنجیره علت و معلولی در اینجا روشن است: اندازه ورودی کوچکتر منجر به کاهش مصرف منابع محاسباتی میشود و در نهایت منجر به کاهش ۹۴ درصدی توکن در جلسات طولانی میگردد.
بهروزرسانی پویا (Dynamic State Update): عامل در حین فرآیند استدلال، بهطور فعال تصمیم میگیرد که چه اطلاعاتی برای گامهای آینده ضروری است. مدل فقط این جزئیات حیاتی را در وضعیت مینویسد تا حافظه متورم و حجیم نشود. این مکانیسم از توانایی پیشبینی عامل برای پیشبینی نیازهای آتی استفاده میکند و تضمین میکند که وضعیت، در عین ایجاز، جامع باقی بماند. این حفظ گزینشی اطلاعات، تمایز اصلی این روش است که یکپارچگی بستر متن را حفظ کرده و در عین حال مصرف توکن را به حداقل میرساند. با ایجاد تعادل بین اختصار و بستر، سامانه مدیریت وضعیت مستحکمی را تضمین کرده و دقت را حفظ میکند.
حذف تاریخچه (History Discarding): پس از پردازش هر گام، تاریخچه خام گفتگو بهطور کامل پاک میشود. این یعنی چه جلسه ۱۰ گام باشد و چه ۱۰۰۰ گام، اندازه ورودی ثابت میماند و رشد نمیکند. این کار از رشد نمایی مصرف توکنها — که یک مشکل بحرانی در گفتگوهای طولانی است — جلوگیری کرده و پایداری در تقاضای محاسباتی ایجاد میکند. با جداسازی اندازه ورودی از طول جلسه، SKILL.state به سطحی از پیشبینیپذیری و کنترل بر مصرف منابع دست مییابد که برای استقرار در دنیای واقعی حیاتی است. این مکانیسم تضمین میکند که مصرف منابع بهصورت خطی با طول جلسه افزایش نیابد، زیرا در غیر این صورت هزینهها غیرقابل تحمل میشد.
بهرهوری در استنتاج (Token Efficiency): با پردازش تنها وضعیت تقطیر شده و مشاهده جدید، مدل از پردازش تکراری دادههای تاریخی اجتناب میکند. این رویکرد هدفمند، سربار عملیاتی را به حداقل رسانده و زمان پاسخدهی را تسریع میکند که مستقیماً به کاهش هزینههای عملیاتی منجر میشود. این تلاش برای بهینهسازی هزینهها در راستای رویکردهای مشابهی است که از طریق مسیریابی در گیتویها توانستند هزینه استنتاج عاملهای AI را کاهش دهند. نتیجه، یک عامل گفتگو کارآمدتر و مقیاسپذیرتر است که از پردازش تکراری دادههای قدیمی — که منبع اصلی ناکارآمدی در مدلهای سنتی است — دوری میکند. حذف این پردازشهای تکراری برای ارائه تجربههای کاربری بدون وقفه در برنامههای حساس به زمان، ضروری است.
بنچمارکهای عملکرد
گوگل این متد را با مدل Gemini-3-Flash آزمایش کرد. در یک محک ۱۰۰ گامهای، نتایج تکاندهنده بود: SKILL.state مصرف توکن را ۹۴٪ نسبت به روشهای سنتی کاهش داد. این کاهش شدید، اثربخشی این متد در بهینهسازی منابع محاسباتی را به اثبات میرساند.
نکته حیاتی این است که این بهرهوری، باعث «سادگی بیش از حد» یا نقص در تفکر مدل نشد. سامانه امتیاز صحت (Accuracy) ۰.۹۴ را حفظ کرد. این ثابت میکند که مدل میتواند بدون داشتن متن کامل و خام گفتگو، بهطور موثر عمل کند. این تعادل بین بهرهوری و عملکرد، یک الزام حیاتی برای کاربردهای واقعی است و نشان میدهد که متد مذکور بهطور موثری اطلاعات وضعیت را مدیریت کرده و نیازهای آینده را با کمترین میزان از دست دادن اطلاعات پیشبینی میکند. دقت بالا تایید میکند که دستاوردهای بهرهوری به قیمت کاهش کیفیت عملکرد به دست نیامدهاند.
ریسکهای «فراموشی»
این بهرهوری یک بهای دارد: مدل باید یک پیشبین بینقص باشد. اگر عامل در گام ۱۰ نتواند پیشبینی کند که چه اطلاعاتی در گام ۵۰ لازم است، دیگر راه بازگشتی نیست؛ چون تاریخچه پاک شده است و مدل نمیتواند به عقب نگاه کند. تکیه بر تواناییهای پیشبینی قدرتمند برای حفظ این سطح از بهرهوری ضروری است.
بر اساس مستندات پژوهشی، سه حالت شکست اصلی شناسایی شده است:
۱. وضعیتهای ناقص (Incomplete States): اگر دادههای حیاتی در وضعیت ثبت نشوند، عامل مجبور به بازیابی مجدد (Re-retrieve) آنها میشود. این بازیابی مجدد باعث جهش ناگهانی مصرف توکن شده و تمام دستاوردهای بهرهوری را از بین میبرد. این حالت شکست، ریسک نادیده گرفتن اطلاعات کلیدی در طول فرآیند بهروزرسانی را برجسته میکند که سیستم را مجبور به انجام بازیابیهای هزینهبر میکند.
۲. هرس تهاجمی (Aggressive Pruning): اگر سامانه بیش از حد در پاکسازی وضعیت سختگیرانه عمل کند، ممکن است بستر متن مرتبط را بازنویسی یا پاک کند. این امر منجر به از دست رفتن اطلاعات، احتمال بروز توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که وجود ندارد، مثل دوستی که خاطرهای را اشتباه تعریف میکند — یا خطاهای منطقی شود. بازنویسی اطلاعات مرتبط میتواند منجر به افت شدید عملکرد و به خطر افتادن قابلیت اطمینان شود.
۳. عدم درک مدل (Model Misunderstanding): مدل پایه باید به اندازه کافی پیچیده باشد تا بتواند وضعیت را مدیریت کند. اگر Gemini-3-Flash (یا مدلهای مشابه) نتواند وضعیت را درست بهروز کند یا در پیشبینی نیازهای آینده شکست بخورد، کل جلسه ناپایدار میشود. این حالت شکست، نقش حیاتی دقت پیشبینی مدل را در حفظ بهرهوری نشان میدهد. نقص در درک وضعیت منجر به ناسازگاریها و مشکلات یکپارچگی در حافظه میشود.
پایداری سامانه و فرآیندهای منطقی
برای جلوگیری از این شکستها، SKILL.state از سه لایه حفاظتی یا فرآیند منطقی استفاده میکند که به عنوان نردههای داخلی سامانه عمل میکنند:
منطق نمایش وضعیت (State Representation Logic): تضمین میکند که وضعیت ساختاریافته، تمام بستر لازم را بدون نیاز به تاریخچه حذفشده پوشش دهد. این امر مستلزم مهندسی وضعیت قوی و دانش عمیق در دامنه تخصصی است تا از دست رفتن اطلاعات جلوگیری شود. این منطق مسیری را دنبال میکند که از طراحی جامع وضعیت برای حفظ عملکرد مستحکم استفاده کند و شالوده بهرهوری سامانه است.
منطق پیشبینانه (Predictive Logic): قلب تپنده سامانه است. این منطق به مدل اجازه میدهد ساختار تکلیف را بفهمد و نیازهای آینده را پیشبینی کند تا نیاز به بازیابیهای هزینهبر دادهها کاهش یابد. پیشبینیهای دقیق منجر به یک وضعیت کامل و کاهش سربار محاسباتی میشود. این منطق، تمایز کلیدی در سناریوهایی است که نیازهای آینده در آنها قابل پیشبینی است.
منطق بهروزرسانی وضعیت (State Update Logic): تعادلی بین ایجاز و یکپارچگی بستر متن در حین استدلال ایجاد میکند. این فرآیند تضمین میکند که عامل بهطور گزینشی اطلاعات را بنویسد تا از «تورم وضعیت» (State Bloat) جلوگیری شود و در عین حال دقت حفظ گردد. بهروزرسانیهای بهینه، دقت و بهرهوری را حفظ کرده و از حجیم شدن بیمورد حافظه جلوگیری میکنند.
ناپایداری سامانه معمولاً زمانی رخ میدهد که این فرآیندها شکست بخورند. بهطور خاص، ناپایداری در شرایط زیر ایجاد میشود:
- شکست پیشبینی: عامل در پیشبینی دقیق نیازهای آینده شکست میخورد و این منجر به نمایشهای ناقص وضعیت و افزایش بازیابی مجدد میشود که دستاوردهای بهرهوری را تضعیف میکند.
- شکافهای نمایش: وضعیت ساختاریافته به اندازه کافی جامع نیست و باعث میشود اطلاعات حیاتی گم شوند یا نادیده گرفته شوند که نتیجه آن افت دقت و بهرهوری است.
- نقص در قابلیتها: مدل پایه فاقد توانایی بهروزرسانی و نگهداری موثر وضعیت است که منجر به ناسازگاری اطلاعات و مشکلات یکپارچگی میشود و قابلیت اطمینان نمایش وضعیت را به خطر میاندازد.
کاربردهای عملی
این متد برای هر چتی مناسب نیست و یک راهکار جادویی برای همه موارد نیست. SKILL.state در محیطهای ساختاریافته و پیشبینیپذیر که گامهای آینده در آنها قابل پیشبینی است، بیشترین بازدهی را دارد. تکیه بر پیشبینی دقیق آینده، کاربرد آن را در سناریوهای کمتر ساختاریافته یا غیرقابل پیشبینی محدود میکند:
- مدیریت پروژه: تکالیف توالی منطقی دارند و پیشبینی دادههای مورد نیاز برای گامهای بعد آسان است.
- گردشکارهای تشخیصی: عیبیابی گامبهگام اجازه میدهد AI یک وضعیت ساختاریافته از تشخیص را حفظ کند و هر مرحله را بر اساس مرحله قبل پیش ببرد.
در این سناریوها، پیشبینیپذیری باعث بهینهسازی بهرهوری میشود. اما در نویسندگی خلاق غیرقابل پیشبینی یا طوفان فکریهای هرجومرج، نبود تاریخچه کامل میتواند یک نقطه ضعف و ریسک باشد، چون نیازهای آینده در این حالت بهراحتی قابل پیشبینی نیستند.
چرخش در معماری هوش مصنوعی
این رویکرد، تغییری از «زور خالص» در پنجرههای زمینه به سمت «مدیریت هوشمند» وضعیت است. تا پیش از این، رقابت بر سر بزرگترین پنجره زمینه (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد، مثل میز کاری که جا برای چند ورق دارد — بود و اعداد ۱ میلیون، ۲ میلیون یا ۱۰ میلیون توکن مطرح بودند.
گوگل نشان داد که اندازه پنجره کمتر از «کارایی فیلتر» اهمیت دارد. با تبدیل حافظه از یک فایل متنی اسکرولشونده به یک پایگاهداده ساختاریافته، عاملهایی ساخته میشوند که ارزانتر و سریعترند. این کاهش رشد نمایی، جلوگیری از تورم وضعیت و حذف پردازشهای تکراری، زیربنای هوش مصنوعی گفتگوی پایدار در بلندمدت است. بدون پرداختن به مصرف بیش از حد توکنها، جلسات طولانی همچنان هزینههای محاسباتی بالایی داشتند و مقیاسپذیری را محدود میکردند.
برای کاربر نهایی، این یعنی عاملهایی که میتوانند پروژههای چندماهه را مدیریت کنند بدون آنکه کند شوند یا بودجه ابری شرکت را ببلعند. این ما را به عاملهای واقعاً خودمختاری نزدیک میکند که میتوانند در پسزمینه زندگی ما فعالیت کنند بدون اینکه منابع مالی عظیمی را مصرف کنند. ارتقای مقیاسپذیری توسط SKILL.state مسیرهای جدیدی را برای AI در خدمات مشتریان، آموزش و بهداشت باز میکند، جایی که تعاملات طولانیمدت بسیار رایج است.
گام بعدی شما
- بررسی کنید آیا گردشکارهای AI شما توالی پیشبینیپذیری دارند یا به یادآوری هر جزئیات کوچک در تمام طول گفتگو نیاز است.
- اگر از مدلهای Gemini استفاده میکنید، ساختار حافظه عاملهای خود را از ذخیره متن خام به ذخیره وضعیتهای ساختاریافته تغییر دهید تا هزینهها را کاهش دهید.
- نرخ خطای مدل خود را در جلسات بالای ۵۰ گام اندازه بگیرید تا نقطه شکست حافظه را شناسایی کرده و نیاز به منطق پیشبینانه را ارزیابی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو