
اگر امروز برای مدیریت عملیات مالی یا لجستیک از عاملهای هوش مصنوعی استفاده میکنید، احتمال شکست زنجیرهای سیستم شما بهشدت کاهش یافته است. نرخ ۴ درصدی امتناع از فراخوانی ابزار در GPT-5.6 Terra، محاسبات مربوط به استقرار عاملهای تولیدی در مقیاس صنعتی را بهطور بنیادین تغییر داده است. در مجموع ۶۰۰ مورد آزمایش که بین ۹ جولای تا ۲۳ جولای ۲۰۲۶ انجام شد، ثابت شد این مدل میتواند زنجیرههای پیچیدهای را مدیریت کند که نسخههای قبلی و رقبای فعلی در آنها شکست میخوردند. ما پس از عرضه GPT-5.6 در ۹ جولای، دو هفته زمان صرف کردیم تا بارهای کاری یکسان را روی هر دو مدل اجرا کنیم و ببینیم آیا بهبودهای ادعایی در عمل صادق هستند یا خیر.
همانطور که در تحلیل قبلی ما دربارهی نحوه مدیریت مهندسی معکوس توسط Claude Opus 5 اشاره کردیم، تمرکز صنعت اکنون از استدلال خام به «پایداری عاملمحور» تغییر کرده است. برای اکثر توسعهدهندگان، هدف دیگر داشتن یک مدل هوشمند نیست، بلکه داشتن مدلی است که در یک گردش کار مالی یا عملیاتی، بهطور خاموش یک مرحله حیاتی را حذف نکند. در سامانههای عاملمحور تولیدی، یک معیار پایداری بسیار مهمتر از هر جایگاه در جدولهای بنچمارک است. این موضوع یادآور تضاد میان بنچمارکهای عمومی و عملکرد واقعی است که نشان میدهد چرا مدلهای برتر لزوماً در محیط تولید موفق نیستند.
تصور کنید یک عامل خدمات مشتری در حال پردازش استرداد وجه است؛ این مدل باید سفارش را جستوجو کند، سیاستها را بررسی کند، پرداخت را انجام دهد و سپس CRM را بهروزرسانی کند. اگر مدل در مرحله سوم شکست بخورد اما به مشتری بگوید «موفقیت»، با یک فاجعه عملیاتی روبرو هستیم. این «شکست خاموش» دشمن اصلی پذیرش هوش مصنوعی در سازمانهای بزرگ است.
شکاف پایداری
به نقل از گزارش dev.to، تفاوت در پایداری فراخوانی ابزار در وظایف چندمرحلهای اثرات تجمعی ایجاد میکند. دادهها نشان میدهد GPT-5.6 نرخ امتناع خود را از حدود ۱۲٪ در نسخه ۵.۵ به کمتر از ۴٪ در نسخه ۵.۶ رسانده است.
در یک گردش کار ۱۰ مرحلهای، این تغییر تحولآفرین است:
- با نرخ شکست ۴٪ در هر مرحله، احتمال تکمیل کامل گردش کار ۶۶٪ است (۰.۹۶^۱۰).
- با نرخ شکست ۱۲٪ در هر مرحله، این احتمال به ۲۸٪ سقوط میکند (۰.۸۸^۱۰).
عملکرد رویارویی در وظایف
پژوهشگران مدل GPT-5.6 Terra — لایهی متوازنی با قیمت ۲.۵ دلار برای ورودی و ۱۵ دلار برای خروجی به ازای هر میلیون توکن — را در برابر Claude Sonnet 4.5 در سه سناریوی خاص آزمایش کردند. برای هر وظیفه در هر مدل، ۲۰۰ مورد آزمایش اجرا شد. این سناریوها بهطور خاص برای جداسازی حالتهای مختلف شکست انتخاب شدند: ارکستراسیون چندمرحلهای، بازیابی خطا در میانه مسیر و انسجام در زمینههای متنی طولانی.
وظیفه الف: ارکستراسیون ابزارهای چندمرحلهای
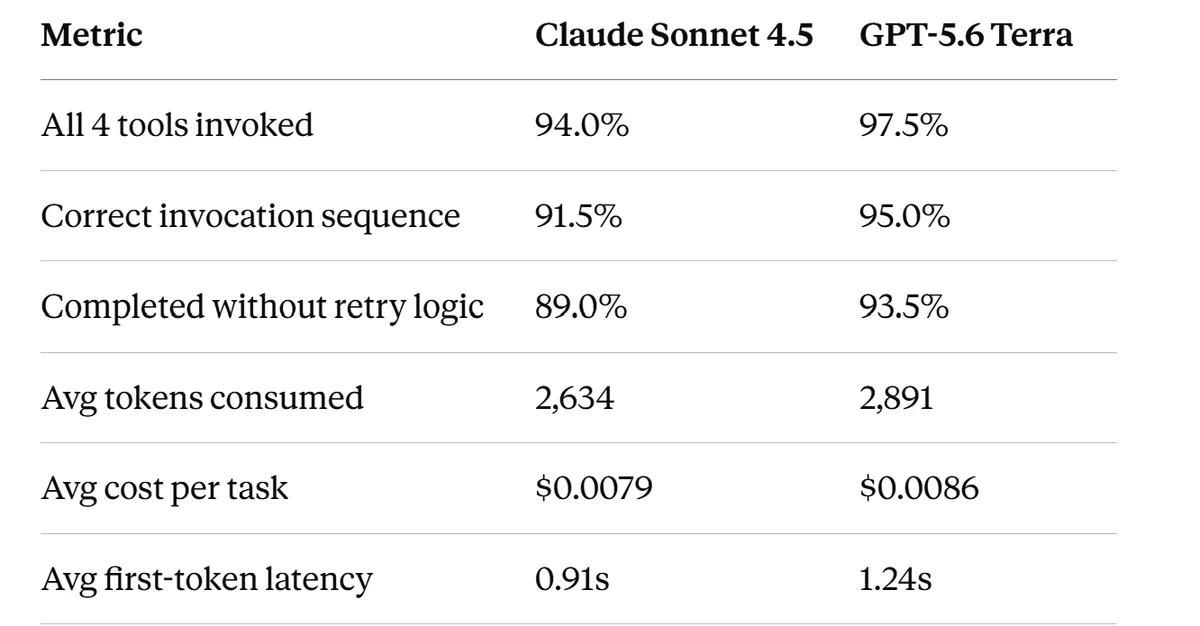
در این سناریو، یک عامل خدمات مشتری باید چهار فراخوانی ابزار را به ترتیب درست زنجیره میکرد: lookup_order ،check_refund_policy ،process_refund و update_crm_record.
- سازوکار: عامل ابتدا باید جزئیات سفارش را بازیابی کند، صلاحیت را بر اساس تاریخ سفارش و سطح مشتری تایید کند، استرداد وجه را برای مبلغ و دلیل مشخص آغاز کند و در نهایت اقدام را در CRM ثبت کند.
- عملکرد: Claude Sonnet 4.5 سریعتر بود و هزینه هر وظیفه کمی کمتر بود. با این حال، فراخوانی ابزارها را تقریباً دو برابر بیشتر از مدل OpenAI حذف کرد.
- پیامد: برای عملیات مالی، تغییرات در سفارشات یا هر گردش کاری با پیامدهای پاییندستی، این شکاف پایداری یک هزینه تجاری ملموس است.
وظیفه ب: بازیابی خطا در میانه مسیر
در این تست، شکستهای عمدی در فراخوانیهای ابزار ۲ و ۳ تزریق شد تا سنجیده شود آیا مدل بهطور هوشمند تلاش مجدد میکند، پاسخ خطای معناداری میدهد یا بهطور خاموش شکست میخورد.
- نوع شکستها: فراخوانی ابزار ۲ خطای ۵۰۳ «سرویس موقتاً در دسترس نیست» (با دستور
retry_after: 2) و فراخوانی ابزار ۳ یک پاسخ JSON بدشکل ({{invalid json response}}) برگرداند. - مدیریت خطای ۵۰۳: هر دو مدل عملکرد خوبی داشتند. GPT-5.6 در ۹۳٪ موارد تلاش مجدد کرد یا موضوع را صراحتاً ارجاع داد، در حالی که Claude این کار را در ۹۱٪ موارد انجام داد.
- مدیریت JSON بدشکل: GPT-5.6 در ۹۱٪ آزمایشها خطای واضحی را نمایش داد، در حالی که Claude در ۸۸٪ موارد موفق بود.
- منطقه خطر: Claude نرخ «ادامه خاموش» حدود ۹ درصدی داشت؛ یعنی با وجود شکست، القا کرد که عملیات موفق بوده است. این نرخ در GPT-5.6 کمتر و حدود ۷٪ بود.
وظیفه ج: انسجام در زمینه متنی طولانی
این تست از ۸۰ هزار توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک طولانی که مدل تکهتکه میخورد — از تاریخچه گفتگوهای قبلی استفاده کرد که در میان آنها ۱۵ فراخوانی ابزار پراکنده شده بود تا بررسی شود آیا مدلها تصمیمات اولیه را در اعماق گفتگو فراموش میکنند یا خیر.
- ثبات: در زمینه ۸۰ هزار توکنی، هر دو مدل تقریباً یکسان عمل کردند. Claude در ۸۸٪ موارد و GPT-5.6 در ۸۷٪ موارد ثبات تصمیمات را حفظ کردند.
- محدودیتهای زمینه: در حالی که هر دو در ۸۰ هزار توکن پایدار هستند، در نزدیکی مرزهای خود متفاوت عمل میکنند. Claude Sonnet 4.5 دارای پنجره زمینه (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد، شبیه میز کاری که جا برای چند ورق دارد — ۲۰۰ هزار توکنی است، اما GPT-5.6 Enterprise پنجرهای عظیم ۱.۵ میلیون توکنی ارائه میدهد.
شکاف پنجره زمینه
اگرچه ۸۰ هزار توکن برای اکثر وظایف خدمات مشتری کافی است، اما در مقیاس بالا تفاوتها آشکار میشود. پنجره ۱.۵ میلیون توکنی GPT-5.6 زمانی که حجم داده از ۱۵۰ هزار توکن فراتر میرود، از حالت تئوریک خارج شده و به یک مزیت عملی تبدیل میشود، زیرا در این نقطه پنجره ۲۰۰ هزار توکنی کلود به یک محدودیت تبدیل میشود.
این ویژگی GPT-5.6 را به انتخابی ایدهآل برای بارهای کاری دادهای حجیم تبدیل میکند:
- بررسی اسناد حقوقی در هزاران صفحه.
- تحلیل پایگاههای کد عظیم سازمانی.
- وظایف جامع حسابرسی انطباق.
مسیریابی استراتژیک
بهترین معماری تولیدی از انتخاب یک برنده واحد اجتناب میکند و در عوض، بر اساس پیچیدگی وظیفه، بین هزینه، سرعت و پایداری تعادل ایجاد میکند. این رویکرد با استراتژی مسیریابی مدلها همسو است که جایگزینی بنچمارکهای کلی با ارزیابیهای وظیفهمحور را پیشنهاد میدهد.
- پرسوجوهای سبک: ارجاع به Claude Haiku یا GPT-5.6 Luna (مناسب برای وظایفی با کمتر از ۲ هزار توکن و کمتر از ۲ فراخوانی ابزار).
- وظایف استاندارد عامل: ارجاع به Claude Sonnet 4.5 یا GPT-5.6 Terra.
- استدلال پیچیده: ارجاع به Claude Opus یا GPT-5.6 Sol (مناسب برای وظایفی با بیش از ۵ فراخوانی ابزار یا زمینه بیش از ۱۰۰ هزار توکن).
- زمینه عظیم: ارجاع به GPT-5.6 Sol برای تحلیل اسنادی که بیش از ۱۸۰ هزار توکن هستند.
این رویکرد ترکیبی، هزینه و پایداری را بهینه میکند و تضمین میکند که گرانترین مدلها فقط برای استدلالهای سطح معماری استفاده شوند.
جمعبندی: کدام مدل را انتخاب کنیم؟
بر اساس ۶۰۰ مورد آزمایش، انتخاب شما به شکل وظیفه شما بستگی دارد:
- GPT-5.6 Terra / Sol را انتخاب کنید اگر: زنجیرههای ابزاری پیچیده دارید که پایداری در هر مرحله حیاتی است؛ گردش کارهای شما به بیش از ۲۰۰ هزار توکن نیاز دارد؛ تیمهای شما در حال حاضر از زیرساختهای OpenAI استفاده میکنند؛ و برای پروژههای جدیدی که ارکستراسیون بومی چند-عاملی نیاز به کدنویسی سفارشی کمتری دارد.
- Claude Sonnet 4.5 را انتخاب کنید اگر: استقرار تولیدی فعلی با الگوهای تایید شده دارید؛ سرعت اولین توکن (Latency) برای شما حیاتی است؛ استقرارهای حجیم با بهینهسازی هزینه مد نظر است؛ و تیمهایی که سرمایهگذاری عمیقی روی مهندسی پرامپت و تنظیمات ایمنی اختصاصی کلود انجام دادهاند.
این تغییر نشان میدهد که «جنگ مدلها» در حال تبدیل شدن به «جنگ ارکستراسیون» است. انتخاب مدل اکنون در مرتبه دوم قرار دارد و کیفیت تعریف ابزارها، مدیریت خطا و الگوهای بازیابی در لایه ارکستراسیون اهمیت بیشتری یافته است. ما مشاهده کردیم که استقرارهای خوشساخت کلود همچنان میتوانند از تنظیمات ضعیف GPT-5.6 در تمام معیارهای مهم پیشی بگیرند.
برای توسعهدهندگان، این بدان معناست که تمرکز باید از مهندسی پرامپت (Prompt Engineering) — هنر سؤال درست پرسیدن، شبیه کسی که میداند چطور از یک مشاور باتجربه بهترین جواب را بگیرد — به مراحل اعتبارسنجی سختگیرانه تغییر کند. هیچ مدلی ۱۰۰٪ قابل اعتماد نیست؛ هدف ساخت سیستمی است که شکست ۴ درصدی را قبل از کاربر تشخیص دهد. برای دستیابی به این سطح از اطمینان، ابزارهایی مانند Tracely-ai میتوانند خطاهای واقعی تولید را به تستهای رگرسیون تبدیل کنند تا پایداری عاملها تضمین شود. هر دو مدل همچنان به یک مرحله اعتبارسنجی صریح قبل از گزارش موفقیت به کاربر نهایی نیاز دارند.
منتظر موج بعدی ابزارهای ارکستراسیون بومی چند-عاملی باشید که نیاز به کدهای رابط پایتونی (Glue Code) را کاهش میدهند، زیرا این احتمالاً مرز بعدی برای OpenAI و Anthropic خواهد بود. برای تیمهایی که عاملهای تولیدی میسازند، همکاری با متخصصان میتواند ماهها آزمون و خطا را حذف کند. شرکتهایی مانند Dextra Labs این سیستمهای عامل هوش مصنوعی تولیدی را برای مشتریان سازمانی میسازند و روی هر دو API کار میکنند تا تضمین کنند مدل با شکل وظیفه مطابقت دارد، نه با شعارهای بازاریابی.
گام بعدی شما
- نرخ شکست مدل خود را در سناریوهای چندمرحلهای اندازهگیری کنید تا نقطه شکست زنجیره را بیابید.
- برای وظایفی با بیش از ۵ فراخوانی ابزار، از مدلهای لایه Sol یا Opus استفاده کنید.
- لایه اعتبارسنجی (Validation) را به جای تکیه بر پاسخ مدل، در کد برنامهنویسی خود پیاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو