انتخاب مدل اشتباه در اکوسیستم جدید، میتواند بدون هیچ افزایشی در کیفیت خروجی، هزینههای شما را تا ۵ برابر افزایش دهد. در سپتامبر ۲۰۲۶، میدان نبرد از بنچمارکهای تئوریک به اقتصاد توکنها منتقل شد.
این نوسانات در حالی رخ میدهد که توسعهدهندگان برای توازن میان استقلال عاملها و نرخ مصرف API در تکاپو هستند. همانطور که در تحلیل قبلی ما دربارهی ریسکهای امنیتی ابزارهایی مثل Claude Code اشاره کردیم، صنعت اکنون به سمت حلقههای عاملمحور با فرکانس بالا حرکت میکند؛ جایی که هزینهٔ ورودیهای کششده (Cached Input) — و نه قیمتهای اسمی — تعیینکنندهٔ بقای یک محصول است.
آرایش جدید مدلهای پیشرو
بین ۱ تا ۳۰ سپتامبر ۲۰۲۶، چهار مدل کلیدی وارد بازار شدند. ابتدا Claude Fable 5.1 در ۱ سپتامبر عرضه شد و پس از آن GPT-6 Astra در ۳ سپتامبر معرفی گردید. ماه سپتامبر با انتشار GPT-6.1 Sol در ۲۹ سپتامبر و معرفی Gemini 4 Argon در ۳۰ سپتامبر به پایان رسید؛ هرچند مدل آرگون در حال حاضر تنها برای اعضای برنامه Fairwind گوگل (مخصوص متخصصان دفاع سایبری) در دسترس است.
طبق گزارشهای داخلی، استراتژی OpenAI در ۲۸ سپتامبر تغییر ناگهانی کرد و شرکت مدل GPT-6.1 Astra را به دلیل شکست در آزمونهای محدوده و مجوزهای دسترسی لغو کرد. این تصمیم باعث شد Astra مدل سطحبالای اصلی باقی بماند و Sol نقش مدل بهینه و اقتصادی را ایفا کند.
اقتصاد توکنها و ساختار قیمتگذاری
قیمتهای اعلامشده نشاندهندهٔ تفکیک دقیق بازار است. GPT-6 Astra و Claude Fable 5.1 هر دو قیمت ۱۰ دلار برای هر ۱ میلیون توکن ورودی و ۵۰ دلار برای هر ۱ میلیون توکن خروجی دارند. در مقابل، GPT-6.1 Sol و Gemini 4 Argon با قیمتی معادل یکپنجم این مقدار (۲ دلار ورودی / ۱۰ دلار خروجی) عرضه شدهاند؛ البته قیمت آرگون یک نرخ تشویقی است که در آینده به ۴ دلار ورودی و ۲۰ دلار خروجی افزایش مییابد.
قیمتگذاری برای پرامپتهای طولانی، صورتحسابها را پیچیدهتر میکند. برای ورودیهای بالای ۲۷۲ هزار توکن، قیمت Astra به ۲۰ دلار ورودی و ۷۵ دلار خروجی جهش میکند. مدل Sol برای همین آستانه، ضریب ۲ برابر برای ورودی و ۱.۵ برابر برای خروجی اعمال میکند، در حالی که Fable 5.1 تا ۱ میلیون توکن نرخ ثابت را حفظ میکند.
برای گردشکارهای عاملمحور (Agentic)، نرخ ورودی کششده حیاتیترین معیار است. عاملها بهطور مکرر پرامپتهای سیستمی و تاریخچه را ارسال میکنند و در اینجا شکاف قیمتی عظیم است:
- GPT-6.1 Sol و Gemini 4 Argon: ۰.۱۰ دلار برای هر ۱ میلیون توکن کششده.
- Claude Fable 5.1: ۰.۲۵ دلار برای هر ۱ میلیون توکن کششده.
- GPT-6 Astra: ۱.۰۰ دلار برای هر ۱ میلیون توکن کششده.
بر اساس تحلیل Marktechpost، در سناریویی با ۲۰۰ هزار توکن زمینهٔ کششده، یک حلقهٔ ۱۰۰ مرحلهای برای یک عامل در Astra حدود ۲۰ دلار هزینه دارد، اما در Sol یا Argon این مبلغ تنها ۲ دلار است. Fable 5.1 با ۵ دلار در جایگاه میانی قرار میگیرد.
تخصصها و عملکرد در محکها
هیچ مدلی در تمام دستهها برتری مطلق ندارد. به نقل از مقایسههای منتشرشده توسط Google DeepMind، مدل Gemini 4 Argon در کارهای دانشی و کدنویسی بلندمدت پیشتاز است و در محک DeepSWE v1.1 امتیاز ۷۷.۹٪ و در شاخص Vals برای امور مالی، حقوقی و مالیاتی امتیاز ۶۸.۹٪ را کسب کرده است.
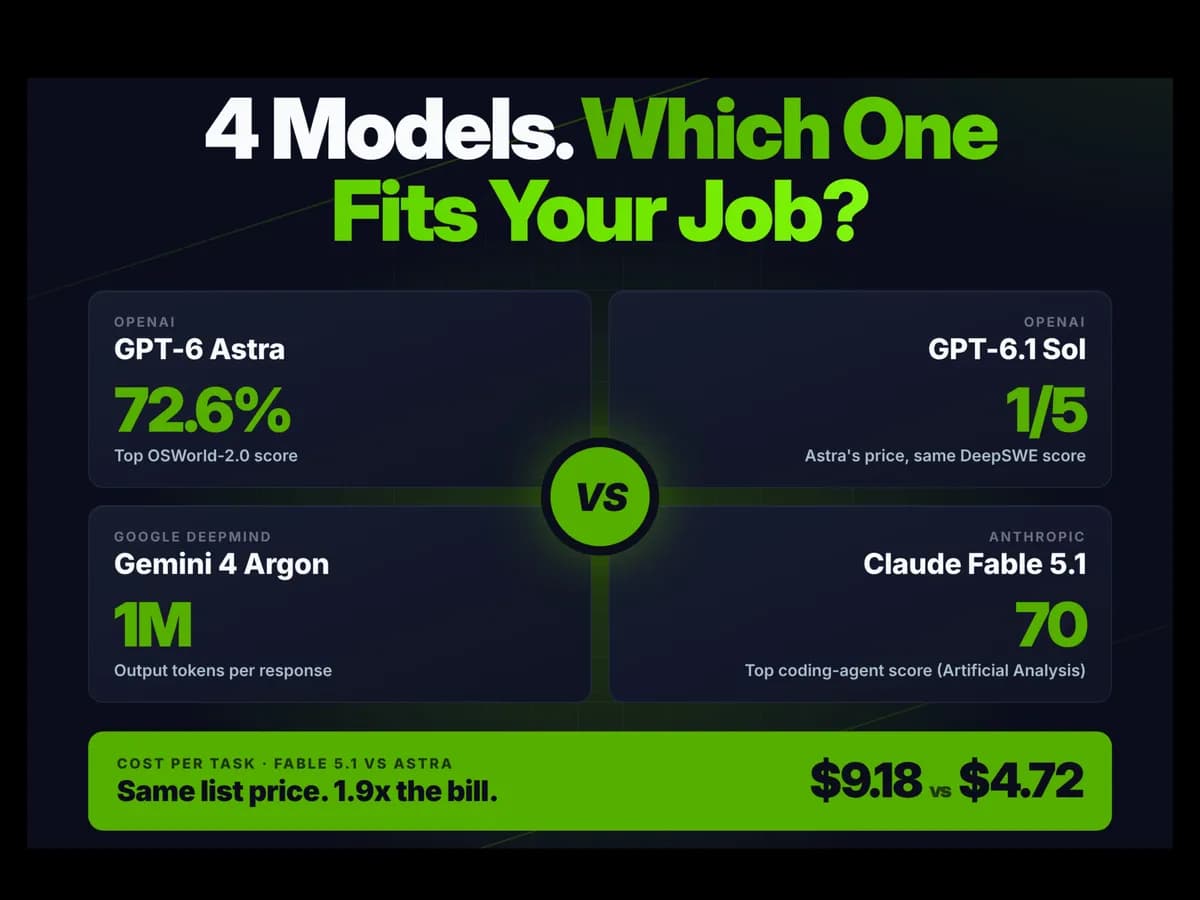
GPT-6 Astra همچنان رهبر وظایف دشوار مهندسی نرمافزار و استفاده از کامپیوتر است. این مدل در FrontierSWE v2 با ۶۵.۵٪ و در OSWorld-2.0 با ۷۲.۶٪ پیشتاز است. OpenAI برای سختترین پژوهشهای علمی، Astra را توصیه میکند و به امتیاز ۶۸.۱٪ آن در Terminal-Bench Science 0.1 استناد میکند.
Claude Fable 5.1 جایگاه منحصربهفردی دارد. اگرچه در برخی محکهای سازنده عقب است، اما دادههای مستقل Artificial Analysis آن را در شاخص هوش (Intelligence Index) با امتیاز ۶۶، پنج واحد بالاتر از Astra (امتیاز ۶۱) قرار میدهد. همچنین در شاخص عاملهای کدنویسی در Claude Code با امتیاز ۷۰، از Astra (امتیاز ۶۷) پیشی گرفته است.
جزئیات معیارهای عملکرد
برای درک بهتر موازنه میان هزینه و کیفیت، این پیشتازیها را بررسی کنید:
- مهندسی نرمافزار: Argon در DeepSWE v1.1 (۷۷.۹٪) و Astra در FrontierSWE v2 (۶۵.۵٪) برنده است.
- کار با ترمینال: Astra در Terminal-Bench 4.0 با ۵۸.۲٪ پیشتاز است، هرچند Claude Opus 5.5 (خارج از این لیست) با ۶۶.۴٪ همچنان برترین است.
- رفع آسیبپذیریها: Argon و Astra هر دو با ۶۸٪ در CWE-bench v1 برابر هستند و Fable 5.1 (۵۸٪) را شکست دادهاند.
- هوش عمومی: در ARC-AGI-2، مدل Astra امتیاز ۹۵٪ و Fable 5.1 امتیاز ۹۰٪ را کسب کردهاند.
پارادوکس هزینهٔ هر وظیفه
قیمتهای اسمی اغلب صورتحساب واقعی را میپوشانند. طبق گزارش Artificial Analysis، هزینه هر وظیفه برای Claude Fable 5.1 حدود ۹.۱۸ دلار است، در حالی که برای GPT-6 Astra این رقم ۴.۷۲ دلار است؛ این در حالی است که قیمتهای اسمی آنها یکسان است. این تفاوت ناشی از حجم توکنهاست؛ Fable 5.1 توکنهای بیشتری مصرف میکند، زیرا توکنساز (Tokenizer) جدید آنتروپیک برای یک متن یکسان، حدود ۳۰٪ توکن بیشتری تولید میکند.
بهرهوری در GPT-6.1 Sol مشهودتر است. OpenAI گزارش میدهد که در Terminal-Bench Science، هزینه هر وظیفه برای Sol حدود ۵.۴۷ دلار است، در حالی که برای Astra این رقم ۲۳.۸۰ دلار است. این موضوع Sol را به انتخاب پیشفرض برای باتهای CI و عاملهای بررسی PR تبدیل میکند، زیرا در DeepSWE v1.1 با یکپنجم هزینه، عملکردی مشابه Astra دارد.
استثناهای ساختاری و دسترسی
Gemini 4 Argon تنها مدل این گروه است که خروجیهای عظیم را پشتیبانی میکند و سقف خروجی آن ۱ میلیون توکن در هر پاسخ است، در حالی که سایر مدلها به ۱۲۸ هزار توکن محدود شدهاند. با این حال، اندازه پنجرهٔ زمینه (Context Window) ورودی آرگون هنوز اعلام نشده است.
دسترسی همچنان یک مانع بزرگ است. آرگون پشت برنامه Fairwind برای مدافعان سایبری قفل شده است. به همین ترتیب، قابلیتهای پیشرفته امنیت تهاجمی Astra تنها در برنامه Daybreak در دسترس است و نسخه عمومی از انجام وظایف سایبری تهاجمی خودداری میکند. آنتروپیک نیز دسترسی به مدل Claude Mythos 5.1 را محدود به برنامههای دسترسی مورد اعتماد کرده است.
راهنمای انتخاب مدل بر اساس حجم کاری
بسته به نوع پروژه، مدل بهینه تغییر میکند:
- باتهای کدنویسی با حجم بالا/CI: مدل GPT-6.1 Sol (بهترین نسبت قیمت به عملکرد).
- مهندسی باز و دشوار: مدل GPT-6 Astra (پیشتاز FrontierSWE v2).
- عاملهای مرورگر: مدل GPT-6 Astra (پیشتاز OSWorld-2.0).
- جلسات طولانی کدنویسی: مدل Claude Fable 5.1 (بالاترین امتیاز عامل کدنویسی).
- اتوماسیون حقوقی/مالی: مدل Gemini 4 Argon (پیشتاز شاخص Vals).
- بازنویسیهای بزرگ/گزارشهای جامع: مدل Gemini 4 Argon (خروجی ۱ میلیون توکن).
- پژوهشهای علمی سخت: مدل GPT-6 Astra (پیشتاز Terminal-Bench Science).
تحلیل فنی: چرخش به سمت بهرهوری
این چرخهٔ انتشار سیگنالی است مبنی بر اینکه صنعت در دستیابی به هوش خام به یک سقف (Plateau) رسیده است. وقتی GPT-6.1 Sol با یکپنجم هزینه، عملکرد Astra را در DeepSWE v1.1 تکرار میکند، ارزش پیشنهادی از «آیا مدل میتواند این کار را انجام دهد؟» به «با چه هزینهای میتواند این کار را در مقیاس بالا انجام دهد؟» تغییر مییابد.
برای مدیران فنی، نتیجه این است که رتبههای جدولهای بنچمارک اکنون در اولویت دوم قرار دارند و تحلیل ردپای توکنها (Trace Analysis) اهمیت یافته است. تفاوت عظیم در هزینه خواندن کش به این معناست که مدلی که در بنچمارک کمی «باهوشتر» است، برای یک عامل تولیدی که ساعتی صدها بار تکرار میشود، از نظر اقتصادی غیرقابلتوجیه است.
ملاحظات نهایی پیش از تغییر مدل
بسیاری از اعداد گزارششده توسط سازندگان هستند و تضاداتی وجود دارد. برای مثال، OpenAI امتیاز Astra در Terminal-Bench 4.0 را ۵۷.۹٪ اعلام کرده، اما جدول گوگل آن را ۵۸.۲٪ نشان میدهد. علاوه بر این، آنتروپیک بنچمارکهای Fable 5.1 را با حفاظهای تولیدی فعال اجرا کرده است؛ وظایف سایبری و بیولوژیکی علامتگذاری شده به مدلهای دیگر ارجاع داده شدند که احتمالاً نتایج OSWorld و AutomationBench را کاهش داده است.
منتظر انتشار عمومی Gemini 4 Argon و افزایش قیمت لایه تشویقی آن باشید، زیرا این اتفاق احتمالاً دور جدیدی از تعدیل قیمتها توسط OpenAI و آنتروپیک را آغاز خواهد کرد.
گام بعدی شما
- تحلیل هزینهٔ هر وظیفه (Cost-per-Task) را جایگزین بررسی صرفِ رتبههای بنچمارک کنید.
- اگر از حلقههای تکرارشونده در عاملهای خود استفاده میکنید، مدلهای Sol یا Argon را برای کاهش هزینهٔ کش جایگزین کنید.
- برای خروجیهای بسیار طولانی (بالای ۱۲۸ هزار توکن)، دسترسی به Gemini 4 Argon را پیگیری کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو