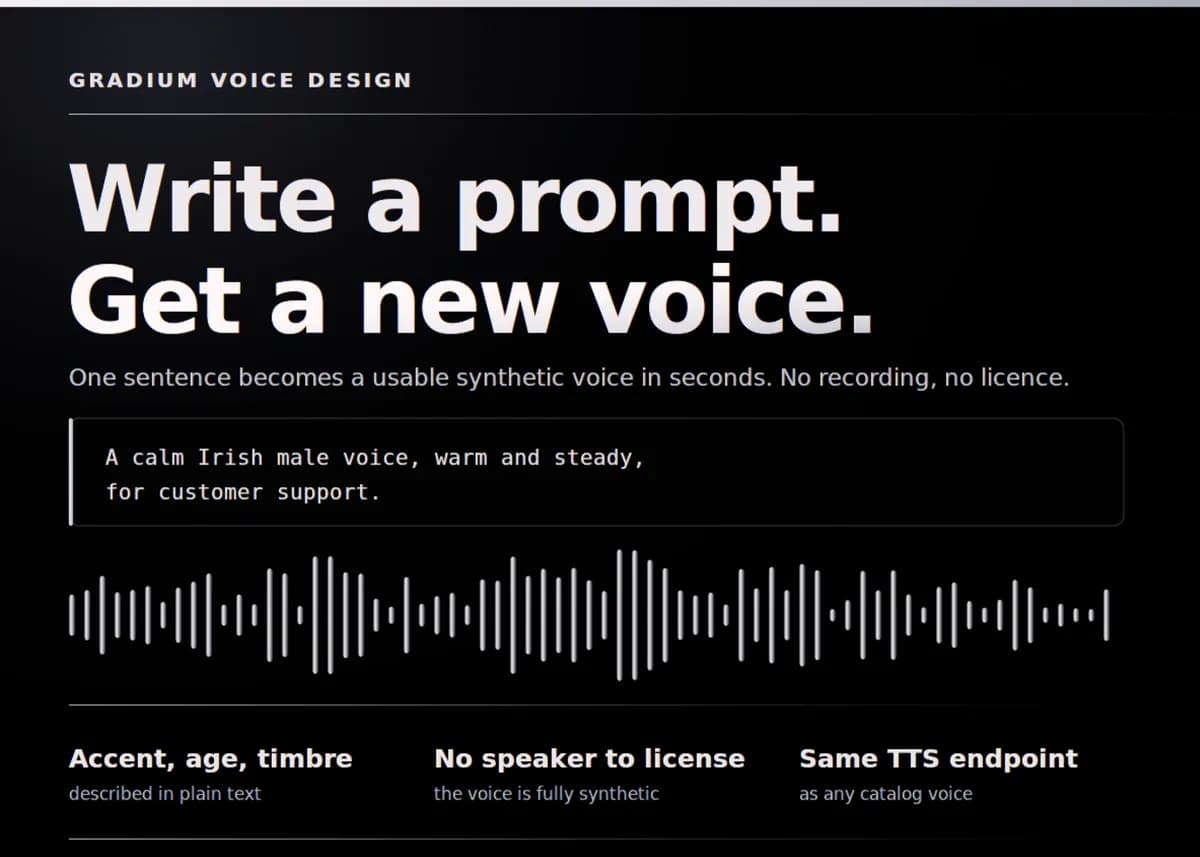
تصور کنید بتوانید تنها با نوشتن چند خط توصیف، صدایی را خلق کنید که هرگز وجود نداشته است؛ بدون نیاز به ضبط صدای یک انسان یا گرفتن اجازه از او. این همان وعده ابزار جدید Voice Design از شرکت Gradium است که در نخستین آزمونهای خود، نرخ پیروزی ۷۲.۶ درصدی را در برابر پنج سیستم رقیب ثبت کرد.
بسیاری از تیمهای توسعه عاملهای صوتی در حال حاضر به کاتالوگهای صوتی ثابت یا شبیهسازی یکبهیک (Voice Cloning) متکی هستند. این موضوع باعث ایجاد یک گلوگاه میشود؛ مثلاً وقتی به یک شخصیت خاص — مانند یک پذیرشگر با لهجه کبکی برای یک نمایشگاه خودرو در مونترال یا گویندهای شصتساله با ابهت یک استاد دانشگاه در سالن سخنرانی — نیاز دارید، گزینههای موجود در کاتالوگها معمولاً پاسخگو نیستند. در بسیاری از موارد، تعداد درخواستهای توصیفی (Briefs) از گزینههای موجود در کاتالوگ بیشتر است و شبیهسازی صدا نیز فرآیندی کند است، زیرا هر صدای جدید نیازمند یافتن منبع صوتی، کسب رضایت قانونی و دریافت لایسنس است. برای بهینهسازی تعامل این عاملها با کاربران واقعی، شبیهسازی کاربرهای «آشفته» به عنوان راهکاری برای جلوگیری از شکست عاملهای صوتی در محیط عملیاتی معرفی شده است.
شرکت Gradium که یک شرکت مستقر در پاریس و حاصل جدایی از آزمایشگاه تحقیقاتی Kyutai است، این مشکل را با تبدیل «متنِ توصیفی» به ورودی API حل کرده است. به جای جستوجو در یک لیست، سیستم توصیفات متنی را میخواند و در عرض چند ثانیه، صداهای کاملاً جدید تولید میکند.
به گزارش Marktechpost، این ابزار اکنون در Gradium API و استودیو فعال شده و برای تمام کاربران، حتی در طرح رایگان، در دسترس است. کاربران میتوانند توصیفاتی بین ۱ تا ۵۰۰ کاراکتر به زبانهای انگلیسی، فرانسوی، اسپانیایی، پرتغالی یا آلمانی وارد کنند تا بین ۱ تا ۵ گزینه صوتی دریافت کنند که معمولاً در ۳ تا ۵ ثانیه آماده میشوند.
همانطور که در تحلیلهای پیشین ما درباره امنیت مدلهای مولد اشاره کردیم، حذف نیاز به دادههای صوتی واقعی، ریسکهای مربوط به جعل عمیق و حریم خصوصی را کاهش میدهد.
در این سیستم، توصیف متنی تنها ورودی مدل است. تیم Gradium توصیه میکند کاربران در انتهای پرامپت خود، کاربرد مورد نظر از صدا را ذکر کنند؛ زیرا این کار باعث میشود مدل به جای تمرکز صرف بر «رنگ» صدا، روی لحن، نحوه بیان و سطح رسمی یا غیررسمی (Register) تمرکز کند.
از آنجا که نمونهگیری در این مدل بهطور عمدی غیرقطعی (Non-deterministic) است، تیم Gradium ابتدا توصیفات کاربر را گسترش میدهد. این گسترش برای هر درخواست متفاوت است، به این معنا که حتی یک پرامپت یکسان با یک بذر (Seed) ثابت — همان مقدار تصادفی اولیه که جهت تولید را تعیین میکند — باز هم صداهای متفاوتی تولید میکند.
مدل به ویژگیهای خاصی پاسخ میدهد که شبیه به یک فراخوان برای بازیگران (Casting Call) است، از جمله:
- هویت: جنسیت، بازه سنی، لهجه یا ملیت.
- آکوستیک: گام صدا (Pitch)، سرعت، انرژی، طنین (Timbre) و رزونانس.
- نحوه بیان: سطح رسمی بودن، رفتار و وظیفه خاصی که صدا در حال انجام آن است.
گردش کار تولید صدا در این پلتفرم از یک توالی چهارمرحلهای پیروی میکند:
۱. تولید: ارسال درخواست به POST /voice-generator/generate برای ایجاد شناسههای کاندید با وضعیت ready: false.
۲. پایش: ارسال درخواست GET /voice-generator/embeddings تا زمانی که وضعیت صدا به حالت آماده (Ready) تغییر کند.
۳. تست: آزمایش کاندیدها از طریق نقطه اتصال استاندارد TTS با استفاده از شناسه کاندید به عنوان voice_id.
۴. ترویج: ارسال درخواست POST /voices/from-embedding برای تبدیل کاندید منتخب به یک صدای تولیدی دائمی.
کاندیدهای تبدیلنشده سه محدودیت خاص دارند: متن تست آنها به ۱۰۰ کاراکتر محدود است، فقط از طریق REST قابل دسترسی هستند و توسط نقاط اتصال WebSocket و Speech-to-Speech رد میشوند. علاوه بر این، کاندیدهای تبدیلنشده پس از ۳۰ روز بهطور خودکار حذف میشوند.
تبدیل صدا رایگان است و تاریخ انقضا را حذف میکند. صداهای ذخیرهشده با همان تأخیر و فرمتهای خروجیِ صداهای کاتالوگ، روی همان نقطه اتصال استریمینگ Text-to-Speech اجرا میشوند. در طرح رایگان ۵ جایگاه برای صدای سفارشی وجود دارد (که با صداهای شبیهسازی شده مشترک است)، اما در طرحهای پولی این ظرفیت به ۱۰۰۰ مورد افزایش مییابد.
طبق اعلام Gradium، در یک تست شنیداری کور (Blind Pairwise) با ۷۶۲۷ مقایسه بین ۶ سیستم طراحی صدا و در ۵ زبان، گویندگان بومی صدای نزدیکتر به توصیفات را بین دو کلیپ بدون نام انتخاب کردند. نتایج نشان داد Gradium در هر ۵ زبان رتبه اول را با نرخ پیروزی ۷۲.۶ درصد (شامل پیروزیها بهعلاوه نیمی از تساویها) کسب کرده است.
این عملکرد ۱۳.۶ واحد جلوتر از ElevenLabs (مدل eleven_ttv_v3 با ۵۹ درصد) بود و سپس Inworld (۴۴.۸ درصد)، Fish Audio (۳۶.۷ درصد) و MiniMax (۳۱.۷ درصد) قرار گرفتند. در این میان، استفاده از API رایگان Fish Audio یکی از گزینههای جایگزین برای استقرار سریع عاملهای صوتی است.
بیشترین برتری Gradium در لهجههای منطقهای دیده شد که معمولاً در کاتالوگهای هوش مصنوعی دچار «تخت شدن» (Flattening) و از دست دادن جزئیات میشوند:
- فرانسوی کبکی: ۹۷ درصد نرخ پیروزی
- اسپانیایی ریوپلاتنس: ۸۶ درصد
- آلمانی باواریایی: ۸۵ درصد
- اسپانیایی کلمبیایی و پرتغالی آفریقایی: ۸۳ درصد
برای اعتبارسنجی بیشتر، از مدل Gemini 3.1 Pro بهعنوان داور استفاده شد که کلیپهای بدون نام را از ۱ تا ۵ امتیاز داد و رتبهبندی مشابهی را ارائه داد: Gradium (۴.۰۶)، ElevenLabs (۳.۸۶)، Inworld (۳.۶۴) و Fish Audio (۳.۵۱). همچنین این شرکت ادعا میکند در محک دانشگاهی InstructTTSEval، در بخش زبان انگلیسی، نرخ پایبندی به پرامپت ۸۳.۴ درصد است. برای بهبود تجربه کاربری در این مدلها، قابلیت Non-Blocking در Gemini Live API با حذف سکوتهای آزاردهنده، روانی گفتگو را افزایش داده است.
این تغییر، صدای مصنوعی را از «شبیهسازی افراد موجود» به «معماری شخصیتهای ایدهآل» منتقل میکند. برای کسبوکارها، این یعنی حذف اصطکاکهای قانونی برای دریافت لایسنس و رضایت هر گوینده جدید برای هر شخصیت صوتی.
شما اکنون میتوانید این قابلیتها را از طریق API شرکت Gradium تست کنید تا ببینید آیا طراحی مبتنی بر پرامپت میتواند جایگزین کاتالوگهای صوتی فعلی شما شود یا خیر.
گام بعدی شما
- اگر از کاتالوگهای صوتی محدود استفاده میکنید، API شرکت Gradium را برای تست صداهای سفارشی امتحان کنید.
- در پرامپتهای خود، حتماً «کاربرد نهایی صدا» را ذکر کنید تا لحن خروجی دقیقتر شود.
- بررسی کنید آیا جایگزینی شبیهسازی صدا با طراحی متنی، هزینههای حقوقی شما را کاهش میدهد یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو