
تصور کنید توسعهدهندهای را در نظر بگیرید که در ۱۷ سپتامبر ۲۰۲۶، در هکاتون Orchestrate شرکت شرکت کرده و موفق میشود در میان بیش از ۳۰۰۰ شرکتکننده، در رتبه ۴.۵٪ برتر قرار گیرد. با این حال، همین فرد اعتراف میکند که نمیتواند چندین جزئیات فنی از کد ارسالی خودش را توضیح دهد. این نتیجه، تنش فزایندهای را در عصر عاملهای هوشمند (Agentic Era) برجسته میکند: شکاف عمیق میان هدایت یک هوش مصنوعی برای ساخت یک سیستم و مالکیت واقعی پیادهسازی حاصل از آن.
این اتفاق در حالی رخ میدهد که عاملهای کدنویسی AI از حالت تکمیل خودکار (Autocomplete) ساده به سمت ارکستراسیون کامل حرکت کردهاند. برای بسیاری از توسعهدهندگان، جریان کاری از «نوشتن خط به خط کد» به «بازبینی مصنوعات تولید شده توسط AI» تغییر کرده است. این تغییر، یک «شکاف درک» خطرناک ایجاد میکند؛ وضعیتی که در آن سازنده میداند سیستم «چه» کاری باید انجام دهد، اما نمیداند «چگونه» در عمل این کار را انجام میدهد. این چالش در واقع بازتابی از تضاد میان سرعت تولید و عمق درک فنی است که پیشتر در تحلیلهای مربوط به ابزارهای کدنویسی مدرن مورد بررسی قرار گرفته بود.
زمینه: چالش Orchestrate
شرکت هکررنک (HackerRank) نسخه سپتامبر ۲۰۲۶ رویداد Orchestrate را به صورت یک هکاتون ۲۴ ساعته سازماندهی کرد. چالش خاص این دوره با عنوان «بخرم یا منتظر بمانم؟» (Buy or Wait?)، شرکتکنندگان را موظف کرد سیستمی بسازند که تعیین کند آیا یک کاربر میتواند هزینهای خاص را پرداخت کند و در عین حال تمام تعهدات مالی آینده خود را پوشش دهد یا خیر.
هکررنک صورت مسئله و دادههای لازم را فراهم کرد. الزامات ارسال آثار بسیار سختگیرانه بود و شامل یک آرشیو از کدها، توصیههای مربوط به ۲۵۰ درخواست خاص و یک گزارش دقیق از روند توسعه (Development Transcript) میشد که تمام مراحل ساخت را مستند میکرد.
ساختار رویداد و اهداف
این رویداد به گونهای طراحی شده بود که چیزی فراتر از خروجی نهایی را آزمایش کند. مخزن رسمی (Repository) و بیانیه مسئله برای راهنمایی شرکتکنندگان ارائه شده بود. هدف اصلی این بود که ببینند آیا یک سازنده میتواند در حالی که از ابزارهای قدرتمند AI استفاده میکند، مالکیت فنی خود را بر پروژه حفظ کند یا خیر.
برای شرکتکننده مورد نظر، انگیزه بسیار بالا بود. او با هدف پیروزی وارد رقابت شد و زمان زیادی را صرف مطالعه نتایج دورههای قبلی Orchestrate کرد تا بتواند یک مزیت رقابتی پیدا کند. این تلاش برای کسب رتبه بالا در جدول امتیازات، با اضطرابِ یک «سازنده به کمک AI» که قرار است توسط یک «داور AI» مورد ارزیابی قرار گیرد، در تضاد بود.
فرآیند ساخت
این توسعهدهنده ابزاری برای تصمیمگیری مالی به نام پراکسی کلو (Praxi Clew) توسعه داد. هدف این بود که مشخص شود آیا کاربر توان مالی پرداخت یک هزینه را دارد بدون اینکه تعهدات آیندهاش به خطر بیفتد.
برای ساخت این سیستم، توسعهدهنده از یک پشته (Stack) پیشرفته AI استفاده کرد:
- آنتیگراویتی (Antigravity): ابزار کدنویسی عاملمحور گوگل که از مدل جمینای ۳.۸ (Gemini 3.8) در محیط IDE برای پیادهسازی اصلی کد استفاده میکرد.
- آسترا (Astra): برای ارکستراسیون و هماهنگی بین مرحله استخراج دادههای AI و منطق پیشبینی پایتون.
- چتجیپیتی آسترا (ChatGPT Astra): برای بازبینی مصنوعات و بهینهسازی نهایی ساختار پروژه.
جزئیات پیادهسازی فنی
سیستم از طریق یک خط لوله (Pipeline) چندمرحلهای عمل میکرد:
- استخراج واقعیتها: از AI برای استخراج حقایق مالی از پیامها و تصاویر استفاده شد.
- پیشبینی: از زبان پایتون برای پیشبینی موجودی حسابها در یک بازه زمانی ۹۰ روزه استفاده شد.
- ارزیابی: سیستم گزینههای مختلف پرداخت را در برابر پیشبینیهای انجام شده میسنجید.
- تغییرات هزینهکرد: پایتون ترکیبات مختلفی از حداکثر سه تغییر مجاز را تست میکرد؛ مانند متوقف کردن یک هزینه واجد شرایط یا کاهش آن به حداقل مقدار مجاز، در حالی که دستههای محافظتشده (غیرقابل تغییر) را استثنا میکرد.
طراحی و نظارت
توسعهدهنده در نقش یک مدیر (Director) عمل میکرد و به طور فزایندهای بر ارائه شواهد، محدود کردن دامنه تغییرات و پایان دادن به چرخه اصلاحات اصرار داشت. در نقطهای از میانهی مسیر ساخت، توسعهدهنده برای متوقف کردن چرخه «گزارشهای مطمئن و اصلاحات متوالی» مداخله کرد. او خواستار یک بازنشانی (Reset) و ارزیابی کامل فایلها و الزامات شد تا اطمینان حاصل کند که اصلاحات هدفمند، رفتارهای غیرمرتبط سیستم را تغییر نمیدهند.
این مداخله فرآیند بازبینی را تغییر داد. توسعهدهنده کد واقعی، خروجیها، الزامات و شواهد استخراج شده را جمعآوری کرد تا ارزیابی بعدی بتواند همه آنها را با هم بررسی کند. این فرآیند شامل عیبیابی نحوه ارزیابی سیستم و همچنین هدایت اصلاحات در خود سیستم بود.
مصاحبه با داور AI
بحرانیترین مرحله، یک مصاحبه صوتی ۳۰ دقیقهای با چاکرا (Chakra)، داور AI هکررنک بود. در این مصاحبه دوربین باید روشن میماند و کد ارسالی در دسترس داور بود. برخلاف یک تست استاتیک، چاکرا بر اساس پاسخهای کاندیدا، سوالات تعقیبی تطبیقی میپرسید و آنها را بر اساس یک روب ریک (Rubric) که عمق درک و مالکیت فنی را میسنجید، امتیازدهی میکرد.
طبق توضیحات عمومی هکررنک، داور AI بررسی میکند که آیا شرکتکننده میتواند جزئیات پیادهسازی در سطح کد را توضیح دهد و در مورد میزان کمک AI صادق باشد یا خیر. یک روب ریک از رویدادهای قبلی Orchestrate ابعاد کلیدی زیر را شناسایی کرده بود:
- عمق درک: توانایی توضیح «چگونه» و «چرا» در مورد کد.
- آگاهی از موازنه ها (Trade-offs): درک سازشهایی که در طول پیادهسازی صورت گرفته است.
- استدلال درباره حالتهای شکست: شناسایی نقاطی که سیستم ممکن است دچار خطا شود.
- صداقت در مورد کمک AI: تمایز واضح بین آنچه انسان طراحی کرده و آنچه AI تولید کرده است.
توسعهدهنده اعتراف کرد که در سراسر پروژه از AI استفاده کرده است، اما داور بر روی جزئیات خاص سطح کد فشار آورد. در لحظهای از استیصال، توسعهدهنده سوالات داور را به یک چت مجزا با AI برد تا در لحظه برای پاسخ دادن به داور AI کمک بگیرد. در واقع، سیستمی که با AI ساخته شده بود، در میانه مصاحبه و به صورت زنده، برای توضیح دادن خودش باز هم به AI نیاز داشت.
شکستهای فنی در توضیح
این مصاحبه چندین نقطه کور را آشکار کرد که در آنها توسعهدهنده به جای کد واقعی، به خلاصههای تولید شده توسط AI تکیه کرده بود:
- هزینههای متغیر: وقتی از او پرسیده شد سیستم چگونه هزینههای خواربار و حملونقل را تخمین میزند، او مجبور شد در لحظه از AI بپرسد تا بفهمد کد از «میانه» (Median) حداکثر پنج مبلغ اخیر در سریهای تکرارشونده استفاده کرده است. هدف از این کار کاهش اثر خریدهای غیرعادی بزرگ یا کوچک بود، هرچند سقف مشخصی برای هزینهکرد تضمین نمیکرد.
- ترتیب تراکنشها: توسعهدهنده در ابتدا تصور میکرد برداشتها قبل از واریزها رخ میدهند. بررسی کد در حین مصاحبه نشان داد که ابتدا درآمدهای تایید شده واریز میشوند، سپس هزینههای موجود کسر شده و در نهایت پرداخت خرید پیشنهادی کسر میشود. این منطق فرض میکرد درآمد قبل از پرداختهای خروجی در همان روز در دسترس است و زمان دقیق تسویه بانکی را نادیده میگرفت.
- شکافهای اعتبارسنجی: داور پرسید خروجی ۲۵۰ درخواست چگونه تایید شده است. توسعهدهنده اشاره کرد که در حالی که ۲۵ نمونه با پاسخهای مورد انتظار داشت، ۲۵۰ مورد دیگر درخواستهای ارسالی بودند. او میتوانست فرمتها، مجوزها، زمانبندیها و موجودیها را با پیشبینی بسنجد و شواهد صادر شده را برای بازتولید خروجیهای یکسان اجرا کند، اما نمیتوانست ادعا کند که با پاسخهای مورد انتظار (که ندیده بود) موافق است.
- خطای اجارهبها: یک خطای بحرانی در درخواست شماره ۱۸۵ پیدا شد؛ جایی که افزایش ۱۲ درصدی اجارهبها به اشتباه ۱۲ یورو پردازش شده بود. اعتبارسنج (Validator) این مورد را تایید کرده بود چون از همان اجارهبهای غلط در پیشبینی استفاده میکرد. مقایسه واقعیت استخراج شده با پیام اصلی، خطا را برملا کرد. اصلاح اجارهبها از ۴۵۱ یورو به ۵۰۵.۱۲ یورو، توصیه پرداخت را از دسامبر به ژانویه تغییر داد.
امتیازدهی و نتایج
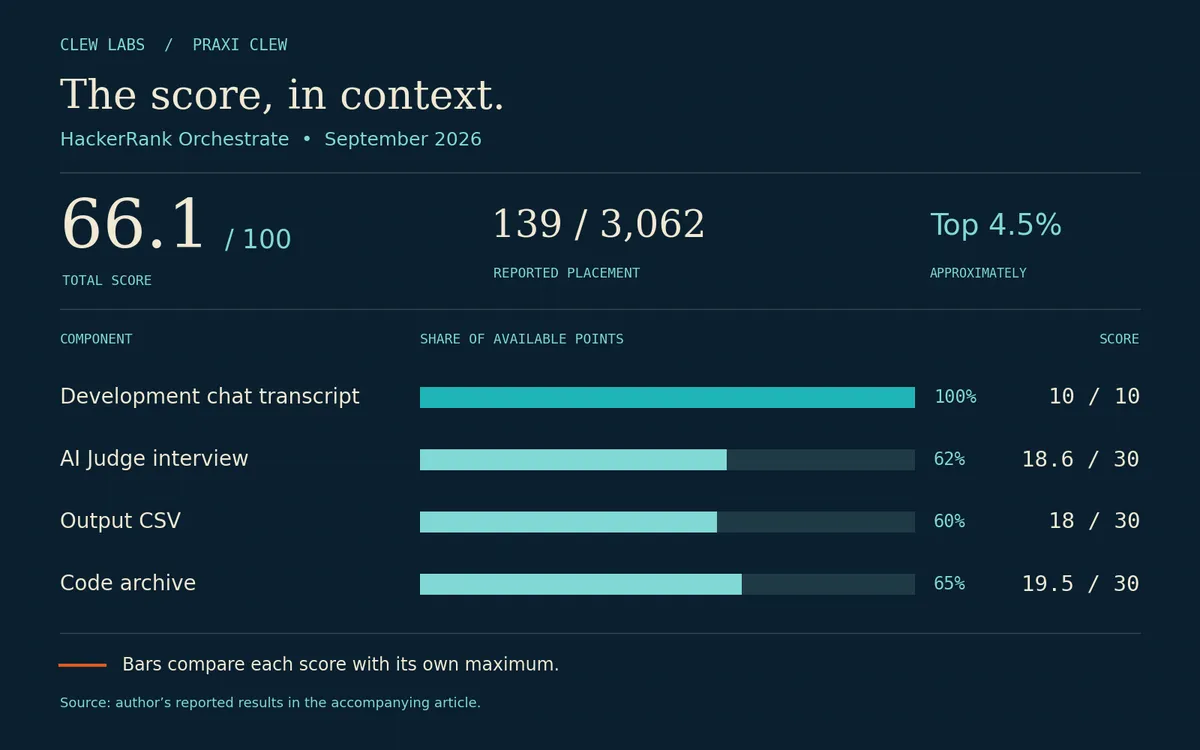
با وجود این چالشها، شرکتکننده رتبه ۱۳۹ از میان ۳۰۶۲ نفر را کسب کرد که او را در حدود ۴.۵٪ برتر قرار داد. گزارش روند توسعه (Transcript) — که سوابق فرآیند ساخت بود — نمره کامل گرفت. این نشان میدهد که توانایی هدایت و عیبیابی عاملهای AI اکنون خود به یک مهارت ارزشمند تبدیل شده است.
با این حال، نمرات فنی برای کد و مصاحبه نسبتاً به هم نزدیک و پایینتر از نمره گزارش توسعه بودند. نتایج نمونههای عمومی محدودیتهای قابل توجهی را نشان داد: در حالی که ۸۰٪ توافق روی «روش پرداخت» وجود داشت، تنها ۱۲٪ توافق روی «مبلغ دقیق پرداخت امن» وجود داشت؛ این ثابت کرد که منطق پیشبینی به اصلاحات انسانی بیشتری نیاز دارد.
پارادوکس مالکیت
این تجربه نشان میدهد که «سرعت رضایتبخش» در کدنویسی عاملمحور، اغلب باعث پوشانده شدن فقدان عمق فنی میشود. وقتی یک عامل (Agent) راهکاری کاربردی ارائه میدهد، انسان وسوسه میشود مرحله درونی کردن منطق را نادیده بگیرد.
برای توسعهدهنده مدرن، گلوگاه جدید دیگر سرعت تولید نیست، بلکه سرعت درک است. توانایی توضیح دادن حالتهای شکست یک سیستم، اکنون مهمتر از توانایی پرامپتنویسی برای خلق آن سیستم است. توسعهدهنده اشاره کرد که نیاز به کمک در جزئیات تخمین و اعتبارسنجی، با غیبت در کارهای طراحی و بازبینی متفاوت است، اما هر دو باید پذیرفته شوند.
برای جلوگیری از این وضعیت، توسعهدهندگان باید «توضیح دادن» را به عنوان یک چکپوینت اجباری در طول ساخت قرار دهند. اگر نمیتوانید توصیف کنید که یک کامپوننت چه کاری انجام میدهد، از چه ورودیهایی استفاده میکند و کجا ممکن است شکست بخورد، شما مالک کد نیستید، بلکه AI مالک آن است.
برای چالشهای آینده، این توسعهدهنده قصد دارد تمام «رسیدها» — شامل لاگهای چت، خروجیهای تست و هر جایی که استدلال لازم است — را ذخیره کند و قوانین مصاحبه را با همان دقتی که الزامات ساخت را میخواند، بررسی کند. او همچنین اشاره کرد که دستورالعملهای ثبت گزارش (Transcript) هکررنک، مطالعهای ضروری پیش از شروع است، زیرا سوابق توسعه یکی از بخشهای امتیازدهی رویداد است.
هدف این است که دفعه بعد که داوری درباره یک مقدار خاص برای هزینههای متغیر پرسید، پاسخ قبلاً برای خودِ سازنده توضیح داده شده باشد.



گفتگو