تصور کنید یک دوره آموزشی طولانی تنها به دلیل یخ کردن یک دوربین یا عدم همگامسازی جریانهای داده، کاملاً نابود شود. این «دادههای کثیف» همان دیوار نامرئی هستند که مانع مقیاسپذیری هوش مصنوعی فیزیکی میشوند؛ مشکلی که شرکت Hebbian Robotics (از شتابدهنده YC S26) با انتشار HFlow به دنبال حل آن است.
HFlow یک SDK (کیت توسعه نرمافزاری) متنباز است که برای اتوماسیون کیفیت دادههای چندوجهی (Multimodal) — یعنی مدلهایی که مثل انسانها همزمان متن، عکس و صدا را میفهمند — در خط لولههای مقیاسپذیر رباتیک و هوش مصنوعی فیزیکی طراحی شده است.
پردازش دادههای چندوجهی بهشدت پراکنده است. طبق مستندات این پروژه، یک مجموعه داده رباتیکی باید ویدیو، وضعیت، اقدامات، برچسبهای زمانی و متادادهها را از سیستمهای ضبط مختلف ترکیب کند. در حال حاضر، اکثر تیمهای رباتیک به مجموعهای از اسکریپتهای سفارشی و نامنظم متکی هستند تا این جریانها را مدیریت کنند. وقتی حجم دادهها رشد میکند، بازرسی اینکه کدام اسکریپت روی کدام فایل اجرا شده یا بازتولید یک مجموعه آموزشی خاص، تقریباً غیرممکن میشود.
تیمها این مشکل را ابتدا در کنترل کیفیت حس میکنند. آنها بهسختی میتوانند تشخیص دهند که آیا دوربینها یخ کردهاند، جریانها از هم فاصله گرفتهاند، موضوعات (topics) مورد نیاز ناپدید شدهاند یا دادههای تکراری وارد مجموعه شدهاند. تصور کنید تیمی در حال ضبط هزاران ساعت از عملیات از راه دور (teleoperation) ربات است؛ اگر یک دوربین تنها چند میلیثانیه جابهجا شود، هوش مصنوعی رابطه اشتباهی بین «عمل» و «مشاهده» یاد میگیرد.
همانطور که در تحلیلهای پیشین ما دربارهی زیرساختهای داده برای مدلهای بنیادی اشاره کردیم، کیفیت داده بر مقدار آن اولویت دارد. در همین راستا، برخی راهکارهای نوین تلاش میکنند با استفاده از مدلهای جهانی گلوگاههای مربوط به حجم و کیفیت دادههای آموزشی رباتها را برطرف کنند. HFlow این اسکریپتهای پراکنده را با یک SDK استاندارد جایگزین میکند که مدیریت، ذخیرهسازی، نسخهبندی و پالایش دادهها را بر عهده میگیرد. این ابزار، متدها و ابزارهای دادهای را که معمولاً در داخل تیمهای بزرگ رباتیک توسعه مییابند، در اختیار تیمهایی با هر اندازه قرار میدهد.
معماری فنی HFlow
این سیستم بر اساس یک چرخه چهار مرحلهای عمل میکند: جمعآوری $\rightarrow$ جذب $\rightarrow$ پالایش $\rightarrow$ تحویل.
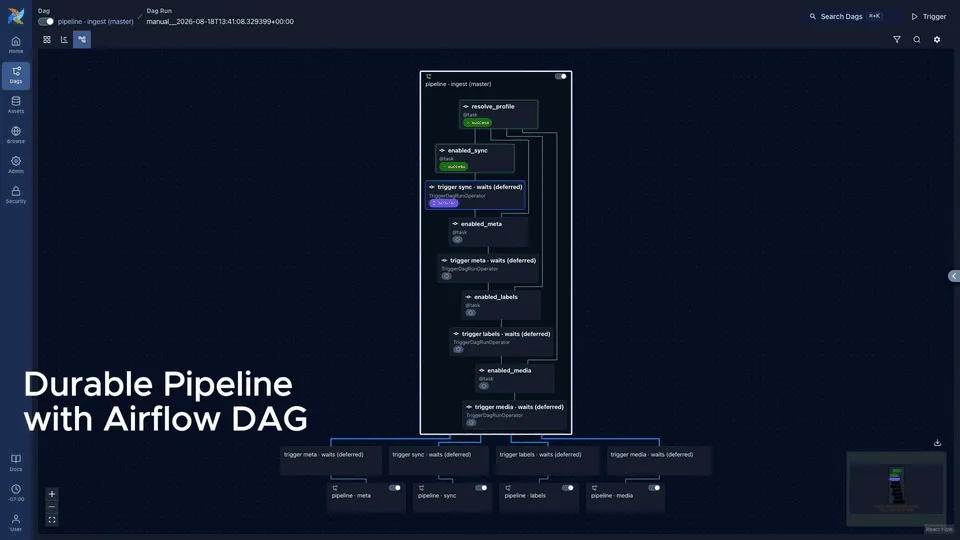
- جمعآوری به جذب: دادهها بهصورت «اپیزود» وارد میشوند. در این مرحله، دادهها تحت تغییر شکل (transformation) قرار میگیرند، از یک گیت کنترل کیفیت (QC gate) عبور کرده و غنی میشوند. این مرحله از طریق Airflow DAGs مدیریت میشود.
- پالایش به تحویل: دستورات SQL روی یک کاتالوگ Parquet اجرا میشوند تا یک مانیفست اپیزود ایجاد شود. این مانیفست در نهایت فایلهای MCAP پالایششده و باکتهای داده را برای آموزش تحویل میدهد.
جزئیات فنی و مرزهای عملیاتی
به نقل از مستندات فنی HFlow، این سیستم مستقیماً از اپیزودهای استاندارد MCAP پشتیبانی میکند. همچنین با دستور hflow import lerobot امکان وارد کردن مخازن LeRobot Dataset v3 فراهم شده است. این واردکننده (importer)، منبع داده را به یک کامیت تغییرناپذیر (immutable commit) متصل کرده و آن را بهعنوان منشأ اپیزود ثبت میکند تا قابلیت بازتولید تضمین شود.
در بخش پردازش، کاربران تغییرات، بررسیهای کیفی، برچسبها و غنیسازیها را بهصورت توابع ساده پایتون مینویسند. این یعنی کدهای قبلی شما بهجای بازنویسی کامل برای یک فریمورک اختصاصی، از طریق آداپتورهای کوچک به سیستم متصل میشوند و مالکیت کد نزد شما باقی میماند.
برای اجرا، سیستم در محیط توسعه بهصورت داخلی (in-process) عمل میکند. اما برای اجراهای زمانبندیشده در محیط تولید، Airflow 3 DAGs تولید میکند. پیشنیازهای این سیستم پایتون ۳.۱۱ به بالا و Docker برای اجرای خط لوله است.
خروجیهای سیستم شامل اپیزودهای استاندارد MCAP، سوابق منشأ (provenance)، مصنوعات (artifacts) و یک کاتالوگ Parquet است. برای پالایش دادهها، سیستم از DuckDB SQL استفاده میکند تا مانیفستهای نسخهبندیشده بسازد؛ این کار اجازه میدهد تیمها بدون بارگذاری فایلهای حجیم ویدئویی، دادهها را فیلتر کنند.
جزئیات پیادهسازی و بهینهسازی
اولین دستور hflow up حدود ۲ گیگابایت ایمیج کانتینر را دانلود کرده و محیط مجازی (venv) تسکها را میسازد. در حالی که متد app.test() به هیچ زیرساختی نیاز ندارد، اجرای کامل خط لوله متکی به Docker یا استقرار مدیریتشده Airflow (مانند Astronomer، MWAA یا Cloud Composer) است.
در لینوکس (x86_64/aarch64)، اولین عملیات ویدئویی یک نسخه تاییدشده و پینشده از ffmpeg/ffprobe را در کش کاربر ذخیره میکند. کاربران میتوانند با تنظیم متغیرهای HFLOW_FFMPEG و HFLOW_FFPROBE از باینریهای شخصی خود استفاده کنند.
برای ذخیرهسازی، علاوه بر مسیرهای محلی، پشتیبانی بومی از s3:// ، gs:// و ریشههای داده Azure از طریق یک بکاند اختیاری فراهم شده است که با دستور uv sync --extra bucket نصب میشود. لازم به ذکر است که ویندوز تنها از طریق WSL2 پشتیبانی میشود، زیرا Airflow بهطور بومی روی ویندوز اجرا نمیشود.
استفاده از فرمت MCAP به این دلیل است که ویدیو، وضعیت و جریانهای زمانی اقدامات را بهطور بهینه و همگام ذخیره میکند. این فرمت توسط ROS 2 ضبط شده و مستقیماً در Foxglove و Rerun باز میشود.
HFlow دو بهینهسازی خاص را که در تحقیقات Dyna توصیف شده است، برای افزایش سرعت خواندن دادهها در زمان آموزش اعمال کرده است:
۱. In-band H.264: طول GOP با نحوه خواندن دادهها مطابقت داده شده است.
۲. Topic-group chunking: جریانهای دوربین و وضعیت هرگز در یک تکه (chunk) مشترک نیستند. این کار تضمین میکند که هر نمونه آموزشی بهجای یک خواندن برای هر موضوع، تنها یک خواندن برای هر گروه هزینه داشته باشد. این تمرکز بر بهینهسازی انتقال داده، یادآور رویکردهای استریمینگ دادههاست که میتواند سرعت انتقال دادههای آموزشی در رباتیک را تا چندین برابر افزایش دهد.
کنترل کیفیت مبتنی بر شواهد
اصل طراحی HFlow «شواهد بهجای احکام» است. بهجای یک برچسب ساده «قبول/رد»، سیستم اندازهگیریهای خام را ثبت میکند. برای مثال، بررسی خاموش شدن دوربین بهجای گفتن «رد شد»، درصد دقیق فریمهای سیاه را بهعنوان یک اندازهگیری قابل پرسوجو ثبت میکند.
این رویکرد به پژوهشگران اجازه میدهد آستانه کیفیت را بعداً تغییر دهند بدون اینکه کل مجموعه داده را دوباره پردازش کنند. اگر تیمی تصمیم بگیرد ۵٪ سیاهی بهجای ۱٪ قابل قبول است، تنها یک کوئری SQL را در کاتالوگ Parquet بهروز میکند. دسترسیدهندهها (Accessors) ورودیهایی را که کدهای موجود انتظار دارند (مانند آرایههای numpy، مسیرهای MP4 یا فریمهای JPEG) استخراج کرده و نتایج را بهجای احکام سختافزاری، بهعنوان اندازهگیری ثبت میکنند.
ردیابی و مقیاسپذیری
هر اپیزود پردازششده در HFlow دارای سوابق منشأ است. خود فایل، طرح (schema)، نسخه خط لوله، نسخههای ابزارهای مورد استفاده و در صورت موجود بودن، URI منبع را ثبت میکند.
این ساختار یک کاتالوگ قابل پرسوجو ایجاد میکند که در آن متادادهها، اندازهگیریهای کیفیت، تگها و مکان مصنوعات در فایلهای Parquet ذخیره میشوند. خط لوله بهصورت یک گراف قابل مشاهده است؛ HFlow گرافهای Airflow را رندر میکند تا کاربران بتوانند وضعیت تسکها، لاگها، تلاشهای مجدد (retries) و اجراهای دوباره را نظارت کنند.
تیمها میتوانند با استفاده از DuckDB به سوالاتی در مقیاس وسیع پاسخ دهند — مثلاً «کدام اپیزودها امتیاز نرمی مفصل زیر ۰.۸ دارند؟» — بدون اینکه نیاز باشد فایلهای حجیم MCAP را باز کنند. این امر امکان ایجاد مانیفستها را با کوئریهایی مانند زیر فراهم میکند:
SELECT episode_id, uri FROM episodes WHERE task = 'fold_napkin' AND status = 'ok' AND black_pct < 1.0 AND pipeline_version = 'a41c9f27b3d8'
نسخه متنباز HFlow بهگونهای طراحی شده که مالکیت آن آسان باشد. این سیستم میتواند بهعنوان یک فضای کاری تکمستاجری (single-tenant) از طریق Docker Compose اجرا شود یا در محیطهای موجود Airflow مانند Astronomer، MWAA یا Google Cloud Composer مستقر گردد.
برای حفظ سبکی سیستم، لایه داده (data plane) از لایه کنترل (control plane) جدا شده است. نسخه فعلی فاقد حسابهای کاربری، RBAC یا لایه کنترل چندمستاجری است. با این حال، معماری بهگونهای ساخته شده که از یک نسخه میزبانیشده (hosted) در آینده پشتیبانی کند که در آن فضاهای کاری ایزوله (مثلاً برای هر تیم یا مشتری) پشت یک لایه کنترل خارجی مدیریت شوند. این موضوع در docs/HOSTING.md بهعنوان یک قرارداد لایه داده شامل واحدهای فضای کاری، آدرسدهی زمان اجرای از راه دور، تزریق اعتبارنامهها و مدل اعتماد مستند شده است.
یکپارچهسازی و نصب
HFlow بهعنوان پل ارتباطی بین ضبط و آموزش عمل میکند. این سیستم بهطور بومی با FFmpeg برای عملیات ویدئویی یکپارچه شده و از ریشههای داده s3:// ، gs:// و Azure پشتیبانی میکند.
برای توسعهدهندگان، این SDK روی PyPy (از نسخه ۰.۲.۰ به بعد) در دسترس است. توجه داشته باشید که نسخههای قدیمیتر ۰.۱.x با همین نام متعلق به پروژهای غیرمرتبط بودند. یک راهنمای سریع (quickstart) را میتوان با استفاده از uv اجرا کرد تا یک اپیزود چندوجهی با جریانهای دوربین و وضعیت سنتز شود و خط لوله بهصورت داخلی (in-process) بدون نیاز به Docker یا Airflow اجرا گردد.
برای کسانی که از اکوسیستم LeRobot استفاده میکنند، دستور hflow import lerobot تضمین میکند که منشأ دادههای وارد شده برای بازتولیدپذیری حفظ شود. برای مثال، وارد کردن مخزن lerobot/pusht باعث میشود شاخه main به یک کامیت منبع تغییرناپذیر تبدیل شود.
گردش کار توسعهدهنده
راهاندازی سیستم تنها با چند خط کد ممکن است. یک خط لوله معمولی با تعریف hflow.App و استفاده از دکوراتورهایی مثل @app.check برای تعریف گیتهای کیفی ساخته میشود. هر بررسی یا غنیسازی یک نسخه (version) را اعلام میکند؛ HFlow این مقدار را دقیقاً همانطور که نوشته شده ذخیره میکند. این به توسعهدهندگان اجازه میدهد نسخهها را برای بازسازیهای حفظکننده رفتار (behavior-preserving refactors) نگه دارند و زمانی که نتایج قدیمی و جدید دیگر قابل مقایسه نیستند، نسخه را ارتقا دهند.
توسعهدهندگان میتوانند از app.test("episode_0001.mcap") برای اجرای کل خط لوله بهصورت داخلی جهت تکرار سریع استفاده کنند. پس از آماده شدن، میتوانند به app.run() منتقل شوند تا محیط Compose را فعال کرده و از hflow ingest برای پردازشهای زمانبندیشده استفاده کنند. سیستم همچنین کاتالوگی از مثالها شامل مسیرهای بینایی OpenAI و مجموعههای داده Egocentric را ارائه میدهد.
این چرخش به سمت خط لولههای استاندارد، پیشفرضهای حوزه رباتیک را تغییر میدهد. با دموکراتیزه کردن ابزارهایی که پیشتر مختص آزمایشگاههای غولپیکر بود، تیمهای کوچک اکنون میتوانند همان دقت دادهای پیشروان صنعت را داشته باشند. اگر در حال ساخت هوش مصنوعی فیزیکی هستید، گام بعدی این است که اسکریپتهای کنترل کیفیت فعلی خود را با متد app.test() در HFlow آزمایش کنید تا ببینید چه مقدار «نویز» در مجموعههای آموزشی فعلی شما پنهان شده است.
گام بعدی شما
- اگر در حال حاضر از اسکریپتهای دستی برای پاکسازی دادههای رباتیک استفاده میکنید، متد
app.test()در HFlow را روی یک نمونه داده اجرا کنید تا حجم واقعی «نویز» در مجموعههای آموزشی خود را ببینید. - مستندات مربوط به
hflow import lerobotرا برای یکپارچهسازی دادههای موجود با استانداردهای بازتولیدپذیری بررسی کنید. - ساختار ذخیرهسازی Parquet را برای جایگزینی جستوجوهای کند در فایلهای ویدئویی با کوئریهای سریع SQL به کار بگیرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو