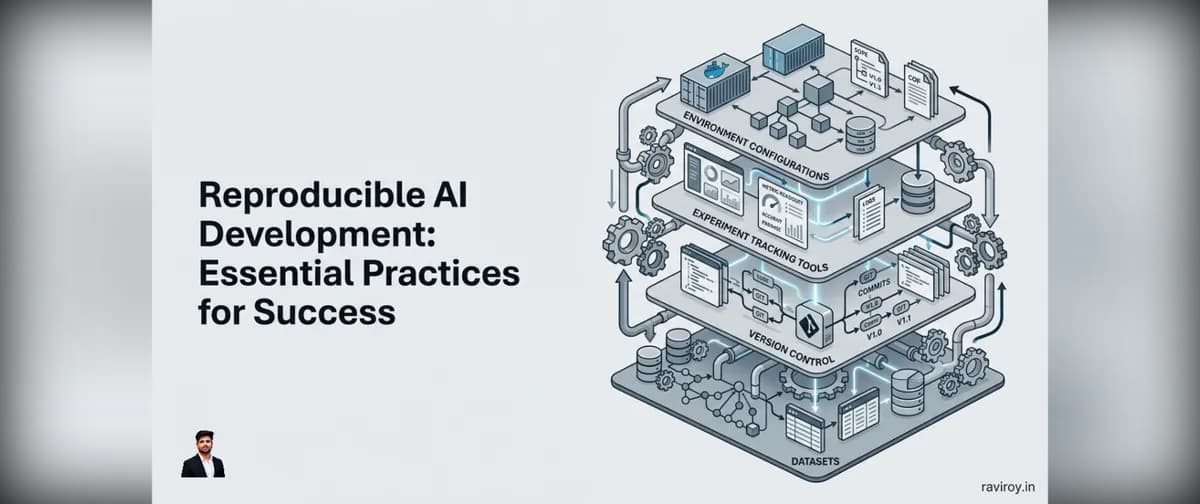
مدلی که روی لپتاپ برنامهنویس عالی عمل میکند اما در محیط عملیاتی شکست میخورد، یک خطای تصادفی نیست، بلکه یک ریسک سیستماتیک است. اگر امروز در حال توسعه مدلهایی هستید که نتایجشان در محیطهای مختلف تغییر میکند، در واقع با یک بحران اعتماد در زیرساختهای خود روبهرو هستید. به نقل از راهنمای فنی منتشر شده در dev.to در ۱۰ سپتامبر ۲۰۲۶، این «سناریوی کابوسوار» ریشه در فقدان بازتولیدپذیری (Reproducibility) دارد؛ یعنی توانایی اجرای مجدد یک فرآیند برای رسیدن به همان نتیجه دقیق قبلی. این موضوع یکی از اصول کلیدی در مهندسی سیستمهای مقیاسپذیر است که توسط Ravi Roy ترویج میشود.
برای اکثر مهندسان، مشکل با «رانش محیطی» (Environment Drift) شروع میشود. این اتفاق زمانی رخ میدهد که تفاوتهای جزئی در سیستمعامل، نسخهی کتابخانهها یا سختافزار باعث رفتار غیرقابلپیشبینی مدل شود. در بخشهای حساس مثل امور مالی و سلامت، این موضوع فقط یک مزاحمت فنی نیست، بلکه یک شکست در انطباق با قوانین (Compliance) است؛ چرا که رگولاتورها یک ردپای دقیق (Audit Trail) از نحوه ساخت مدل و دادههای مصرفشده آن را میطلبند. این چالشها اغلب توضیح میدهند که چرا برخی عاملهای هوش مصنوعی علیرغم امتیازات بالای بنچمارک، در محیط عملیاتی شکست میخورند.
ارزش تجاری و حاکمیتی
بازتولیدپذیری سنگ بنای هوش مصنوعی قابل اعتماد است. از منظر تجاری، این موضوع مستقیماً به کاهش ریسکهای عملیاتی ترجمه میشود. سازمانها میتوانند زمان صرفشده برای عیبیابی (Debugging) و رفع خطاها را بهشدت کاهش دهند و منابع ارزشمند خود را ذخیره کنند. در این حالت، برآورده کردن الزامات رگولاتوری به جای یک تکاپوی پراکنده، به یک فرآیند ساختاریافته تبدیل میشود.
علاوه بر این، بازتولیدپذیری باعث تقویت اعتماد و شفافیت میشود. ذینفعان، رگولاتورها و سایر توسعهدهندگان نیاز دارند اطمینان یابند که مدلها به صورت پیشبینیپذیر رفتار میکنند و نتایج قابل تأیید هستند. وقتی اعضای تیم بتوانند بدون اصطکاک کارهای یکدیگر را بازسازی کنند، سرعت توسعه افزایش مییابد و انتقال دانش به صورت یکپارچه صورت میگیرد.
در نهایت، قابلیت بازگشت (Rollback) به یک نسخهی سالم و تاییدشده در صورت بروز مشکل در محیط تولید، برای حفظ تداوم سرویس و اعتماد کاربر حیاتی است. این متدولوژی، فرآیند تشخیص خطا را از «جستوجوی سوزنی در انبار کاه با چشمبسته» به یک فرآیند مهندسی بهینه تبدیل میکند.
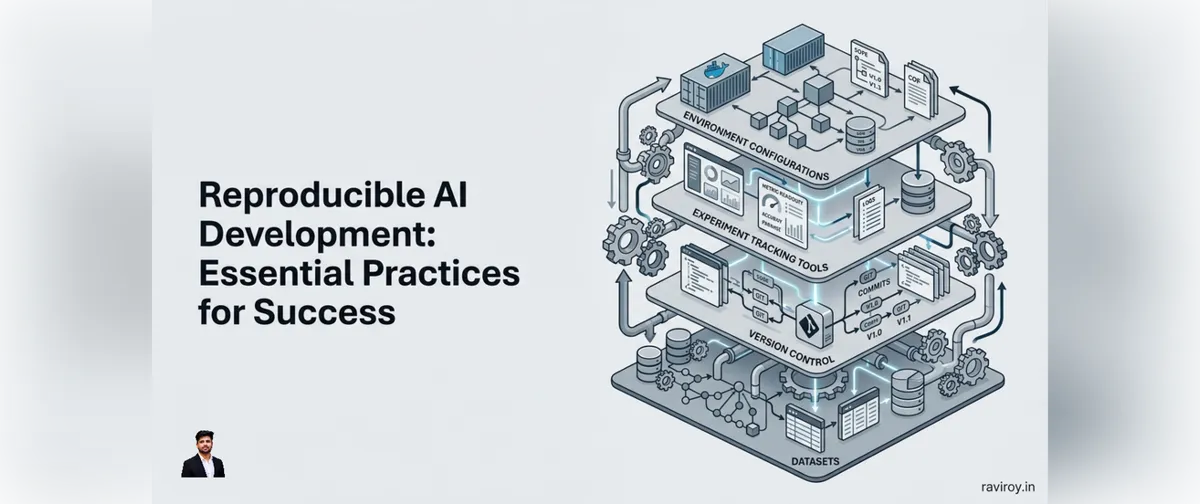
ستون اول: نسخهبندی کد و داده
بازتولیدپذیری با نگاه به کد و داده به عنوان داراییهای تغییرناپذیر (Immutable) آغاز میشود. طبق این راهنما، هر اسکریپت آموزش، فایل پیکربندی و حتی پرامپتهای هوش مصنوعی زاینده (Generative AI) باید از طریق Git ردیابی شوند.
نسخهبندی کد هوش مصنوعی:
تیمها باید استراتژیهای مشخصی را اتخاذ کنند. برای پایداری بیشتر، روش Trunk-based Development (شاخههای کوتاهمدت که مکرراً به شاخه اصلی ادغام میشوند) و برای چرخههای انتشار ساختاریافته، روش Git Flow (شاخههای اختصاصی برای ویژگیها، انتشارها و اصلاحات سریع یا Hotfixes) توصیه میشود. هر استقرار مدل باید به یک هش (Hash) مشخص از کامیت گیت متصل باشد تا سندی تغییرناپذیر از کد مورد استفاده ایجاد شود. مواردی که باید نسخهبندی شوند عبارتند از: فایلهای تعریف مدل (مانند model.py)، اسکریپتهای آموزش و ارزیابی (train.py و evaluate.py)، فایلهای پیکربندی برای ابرپارامترها (config.yaml یا .json) و اسکریپتهای پیشپردازش یا استقرار. در مورد هوش مصنوعی زاینده، قالبهای ساختاریافتهی پرامپت یا اسکریپتهای مهندسی پرامپت باید در کنار کد نسخهبندی شوند.
برقراری منشأ دادهها (Data Provenance):
دادهها سوخت هوش مصنوعی هستند و تغییرات ردیابینشده در آنها منجر به افت عملکرد خاموش میشود. توصیه میشود مجموعهدادهها به صورت اسنپشاتهای تغییرناپذیر مدیریت شوند. هرگونه اصلاح—مانند افزودن نمونههای جدید، تصحیحات یا تبدیلها—باید منجر به ایجاد یک نسخهی جدید و مجزا شود. برای مدیریت دقیقتر این خطاها، میتوان از رویکرد امتیاز اعتماد دادهها برای شناسایی ریشه خطاهای مدل بهره برد.
- تبار دادهها (Data Lineage): ردیابی مسیر داده از منبع اصلی، طی مراحل پاکسازی، مهندسی ویژگی و تقویت (Augmentation) تا حالت نهایی حیاتی است. این کار برای عیبیابی رفتارهای غیرمنتظره یا درک سوگیریهای داده ضروری است.
- ابزارها: ابزار DVC (Data Version Control) برای مدیریت فایلهای حجیم برجسته شده است؛ این ابزار اشارهگرها را در گیت ذخیره کرده و دادههای واقعی را در S3، GCS، Azure Blob یا ذخیرهسازهای محلی نگه میدارد. یک گردشکار معمولی شامل دستورات
dvc initوdvc add data/raw_data.csvو سپس کامیت کردن فایل.dvcحاصل در گیت است. - مدیریت دریاچه داده: برای دریاچههای داده بزرگتر، LakeFS امکان ایجاد شاخههایی (Branching) شبیه به گیت را مستقیماً روی دادهها فراهم میکند و آزمایشهای ایزوله با داده را ممکن میسازد.
چرا منشأ دادهها ضروری است؟
اولاً برای عیبیابی؛ ردیابی تا نسخهی دقیق داده کمک میکند بفهمیم آیا فساد دادهها علت اصلی افت عملکرد است یا خیر. ثانیاً برای انطباق؛ رگولاتورها اغلب یک ردپای شفاف از دادههای مورد استفاده در مدلها، بهویژه در حوزههای حساس، میطلبند. ثالثاً برای درک رفتار مدل؛ دانستن دادههای دقیق آموزش، زمینهی حیاتی برای تفسیر پیشبینیها و سوگیریها فراهم میکند.
ستون دوم: محیطهای تغییرناپذیر
برای حذف بهانهی «روی سیستم من کار میکرد»، محیطها باید توصیفی (Declarative) و ایزوله باشند.
کانتینرسازی و ایزولاسیون:
استفاده از Docker به مهندسان اجازه میدهد کد، وابستگیها و کتابخانههای سیستم را در یک واحد قابلحمل بستهبندی کنند. یک تصویر داکر تضمین میکند که محیط از توسعه تا تولید یکسان باشد. برای مثال، یک Dockerfile باید تصویر پایه (مثلاً python:3.9-slim-buster) را مشخص کند، دایرکتوری کاری را تنظیم نماید و وابستگیها را از طریق یک فایل requirements نصب کند. همچنین باید متغیرهای محیطی مانند PYTHONHASHSEED=0 را برای تضمین بازتولیدپذیری شامل شود.
تثبیت وابستگیها (Dependency Pinning):
راهنما نسبت به استفاده از نسخههای «آخرین» (latest) هشدار میدهد. در عوض، توسعهدهندگان باید از pip freeze > requirements.txt یا فایلهای قفل (Lock files) در Poetry و Pipenv برای حل قطعی (Deterministic) وابستگیها استفاده کنند. برای کاربران Conda، دستور conda env export > environment.yml توصیه میشود. یک فایل environment.yml قدرتمند باید نسخههای دقیق را ذکر کند، مانند python=3.9.12، numpy=1.23.5، pandas=1.5.3، scikit-learn=1.2.2، pytorch=1.13.1 و cudatoolkit=11.7 برای پشتیبانی از GPU.
کنترل تصادفی بودن:
بسیاری از الگوریتمهای هوش مصنوعی تصادفی (Stochastic) هستند. راهنما پیادهسازی خاصی را برای تنظیم بذرهای (Seeds) سراسری در NumPy، PyTorch و TensorFlow ارائه میدهد تا مقداردهی اولیه وزنها و مخلوط کردن دادهها ثابت بماند.
- بذرهای سراسری: این شامل تنظیم
os.environ['PYTHONHASHSEED']،random.seed(seed)،np.random.seed(seed)،tf.random.set_seed(seed)وtorch.manual_seed(seed)است. - قطعی بودن GPU: برای محیطهای چند-GPU، باید از
torch.cuda.manual_seed_all(seed)،torch.backends.cudnn.deterministic = Trueوtorch.backends.cudnn.benchmark = Falseاستفاده کرد. بدون این تنظیمات، تغییرات جزئی در زمان اجرا یا وضعیت سیستم میتواند به نتایج متفاوت منجر شود.
ستون سوم: ردیابی آزمایشها
وقتی محیط پایدار شد، هر اجرا باید به عنوان یک رکورد منحصربهفرد ثبت شود تا نتایج درخشان اما غیرقابلتکرار گم نشوند.
ثبت جامع متادیتا:
- ابرپارامترها: ثبت تمام پارامترهای قابل تنظیم شامل نرخ یادگیری (Learning Rate)، اندازه دسته (Batch Size)، تعداد اپوکها، انتخاب بهینهساز و قدرت منظمسازی (Regularization).
- معماری مدل: مستندسازی تعداد لایهها، توابع فعالساز، نسخههای خاص مدلهای پیشآموزشدیده و لایههای سفارشی.
- تفکیک دادهها: ثبت نسخهی دقیق مجموعهداده مورد استفاده برای آموزش، اعتبارسنجی و آزمون، و نحوه انجام این تفکیک.
- معیارهای کلیدی عملکرد: ثبت دقت (Accuracy)، امتیاز F1، دقت (Precision)، فراخوانی (Recall)، RMSE، زیان (Loss) و AUC، و ردیابی تکامل آنها در هر اپوک.
ثبت آرتیفکتها و محیط:
- مدیریت آرتیفکتها: ذخیره وزنهای مدل آموزشدیده (فایلهای
.ptیا.h5یاSavedModel) و نمودارهای ارزیابی مانند ماتریسهای اغتشاش (Confusion Matrices) و منحنیهای ROC. - جزئیات سیستم: مستندسازی سیستمعامل، مشخصات CPU/GPU، تمام نسخههای کتابخانهها و هش کامیت گیت مرتبط.
- ابزارهای ردیابی: پلتفرمهایی مثل MLflow، Weights & Biases (W&B) و Comet ML توصیه میشوند. MLflow به کاربران اجازه میدهد پارامترها، آرتیفکتها و مدلها را در یک بلوک
start_run()ثبت کرده و اجرا را به یک نام آزمایش خاص (مثلاً "My_Image_Classifier") متصل کنند.
ستون چهارم: رجیستری متمرکز مدلها
اگر ردیاب آزمایش برای «کشف» است، رجیستری مدل برای «تولید» است. رجیستری به عنوان تنها منبع حقیقت برای مدلهای کاندید عمل میکند.
توابع رجیستری و چرخه حیات:
- ذخیرهسازی متمرکز: ذخیره مدلهای آموزشدیده با متادیتای کامل و اتصال آنها به اجراهای آزمایشی که آنها را تولید کردهاند.
- کنترل نسخه: هر مدل ثبتشده یک شماره نسخه منحصربهفرد میگیرد تا بهروزرسانیها ردیابی شوند.
- مراحل چرخه حیات: مدلها از مراحل تعریفشدهای عبور میکنند: Staging (مدلهای تحت بررسی یا در حال تست A/B)، Production (مدل مستقر فعلی که پیشبینیها را ارائه میدهد) و Archived (نسخههای قدیمی برای سوابق تاریخی).
استقرار و بازگشت:
یک رجیستری به مهندسان MLOps اجازه میدهد در صورت بروز مشکل در تولید، فوراً به یک نسخه سالم بازگردند و تداوم سرویس را حفظ کنند. ابزارهایی مانند Amazon SageMaker Model Registry و Google Cloud AI Platform Model Registry این رجیستریها را با خط لوله استقرار ادغام میکنند تا بازیابی و مقایسه بر اساس معیارها آسان شود.
بازتولیدپذیری پیشرفته برای هوش مصنوعی زاینده
هوش مصنوعی زاینده از طریق نمونهگیری (Sampling)، غیرقطعی بودن را وارد میکند. راهنما پیشنهاد میکند قالبهای پرامپت نسخهبندی شوند و پارامترهای نمونهگیری مستند گردند، از جمله:
- Temperature: کنترل میزان تصادفی بودن.
- Top_k: فیلتر کردن k توکن بعدی محتملتر.
- Top_p: فیلتر کردن توکنها بر اساس احتمال تجمعی.
- Num_beams: مورد استفاده در جستوجوی پرتویی (Beam Search).
- پارامترهای جریمه: هرگونه جریمه تکرار (Repetition Penalty) در حین تولید.
از آنجایی که مدلهای زاینده حتی با ورودیهای یکسان میتوانند خروجیهای متفاوتی تولید کنند، توسعهدهندگان باید واریانس خروجی را با تولید چندین نمونه و ارزیابی ویژگیهای آماری آنها گزارش کنند. بذرهای صریح (Explicit Seeding) همچنان حیاتی هستند؛ بدون آنها نمیتوان یک خروجی خاص تولید شده را برای عیبیابی یا ارزیابی بازتولید کرد. در واقع، برای مقابله با این خروجیهای احتمالی، استفاده از عاملهای حسابرسی متخاصم به عنوان یک راهکار مستندسازی در پژوهشهای AI پیشنهاد شده است.
زیرساخت به عنوان کد (IaC) و اتوماسیون
زیرساخت نیز باید بازتولیدپذیر باشد. راهنما از زیرساخت به عنوان کد (IaC) با استفاده از Terraform یا AWS CloudFormation حمایت میکند تا تضمین شود منابع محاسباتی و شبکه در تمام مراحل یکسان هستند. برای مثال، Terraform میتواند یک AMI نسخهبندی شده خاص برای یک نمونه AWS EC2 (مثلاً ami = "ami-0abcdef1234567890") را تعریف کرده و از یک اسکریپت user_data برای نصب داکر استفاده کند.
در نهایت، خط لولههای MLOps سرتاسری با استفاده از Kubeflow، Apache Airflow یا Dagster میتوانند کل جریان از دریافت داده تا استقرار را خودکار کنند. این خط لولهها گردشکار را به صورت کد تعریف میکنند و تضمین میکنند که هر اجرا خودکار، تکرارپذیر و کاملاً قابل ردیابی باشد.
عیبیابی مدلهای غیربازتولیدپذیر
وقتی نتایج همچنان متفاوت بود، راهنما یک رویکرد سیستماتیک برای عیبیابی پیشنهاد میکند:
- جداسازی متغیرها: با مقایسه سادهترین واحد بازتولیدپذیر، مانند یک تابع بارگذاری داده واحد، شروع کنید.
- جستوجوی دودویی (Binary Search): مراحل گردشکار را نصف کنید تا ببینید آیا انحراف همچنان وجود دارد، سپس روی نیمه مشکلدار تمرکز کنید.
- چکسام (Checksums): محاسبه چکسام برای دادهها در مراحل مختلف (خام، پیشپردازش شده، مجموعههای ویژگی) و برای وزنهای مدل پس از هر اپوک تا شناسایی نقطه وقوع گام غیربازتولیدپذیر.
- قطعی بودن GPU: استفاده از
torch.backends.cudnn.deterministic = Trueبرای اجبار به رفتار قطعی GPU. علاوه بر این، متغیرهای محیطی مانندCUBLAS_WORKSPACE_CONFIG=:4096:8یاTF_DETERMINISTIC_OPS=1را برای کتابخانههای خاص تنظیم کنید (با آگاهی از اینکه ممکن است باعث افت جزئی عملکرد شود). - پاکسازی محیط: رفع مشکلات کش با استفاده از
pip cache purgeیاconda clean --allقبل از نصب مجدد وابستگیها. تایید دقیق نسخههای سیستمعامل و درایور GPU در تمام ماشینها.
ساخت پشته (Stack) بازتولیدپذیر هوش مصنوعی
دستیابی به بازتولیدپذیری مستلزم ادغام چندین دسته ابزار در یک گردشکار منسجم است:
- کد و داده: گیت برای کد/پرامپتها؛ DVC یا LakeFS برای مجموعهدادهها.
- محیط: داکر برای کانتینرها؛ Conda، Pipenv یا Poetry برای تثبیت وابستگیها.
- ردیابی و رجیستری: MLflow، W&B یا Comet ML برای آزمایشها و نسخهبندی مدل.
- زیرساخت و ارکستراسیون: Terraform برای IaC؛ Kubeflow، Airflow یا Dagster برای خط لولهها.
رویکرد پذیرش مرحلهای
همه چیز را یکباره پیاده نکنید. با این توالی شروع کنید:
- نسخهبندی کد: اطمینان حاصل کنید تمام کدها در گیت هستند.
- تعریف محیط: تثبیت وابستگیها در
requirements.txtیاenvironment.yml. - مبانی ردیابی آزمایش: ثبت معیارهای کلیدی و ابرپارامترها برای هر اجرا.
- نسخهبندی دادهها: نسخهبندی دادههای حیاتی آموزش.
- کانتینرسازی: انتقال اجزای حیاتی به داکر.
- رجیستری مدل و خط لولهها: ساخت ارکستراسیون پیشرفته.
این تغییر به سمت بازتولیدپذیری کمتر درباره یک ابزار واحد و بیشتر درباره یک حرکت فرهنگی به سمت دقت وسواسگونه است. با ادغام این شیوهها، سازمانها ریسک عملیاتی را کاهش داده و چرخه تکرار (Iteration) را تسریع میکنند.
برای شروع پیادهسازی، خط لوله فعلی خود را برای «تبدیلات پنهان» بازرسی کنید؛ هر مرحله پیشپردازشی که در گیت نسخهبندی نشده است، یک نقطه شکست بالقوه است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و تاثیر آنها بر استنتاج مدلهای مقیاسبزرگ مراجعه کنید.



گفتگو