تصور کنید یک مدل هوش مصنوعی را آموزش میدهید، اما هیچ خط کدی نمینویسید و تنها از یک جعبه چوبی و چند تکه ماهی استفاده میکنید. هر عامل هوشمند امروزی، از موتورهای شطرنج تا رباتهای انساننما، بر اساس حلقهای اجرا میشود که توسط افرادی طراحی شده است که هرگز یک خط کد ننوشتهاند. بین سالهای ۱۸۹۸ تا ۱۹۴۹، گروهی از روانشناسان مبانی بیولوژیکی یادگیری را مهندسی معکوس کردند و نقشهای را ترسیم کردند که ما امروز آن را یادگیری تقویتی (Reinforcement Learning یا RL) مینامیم.
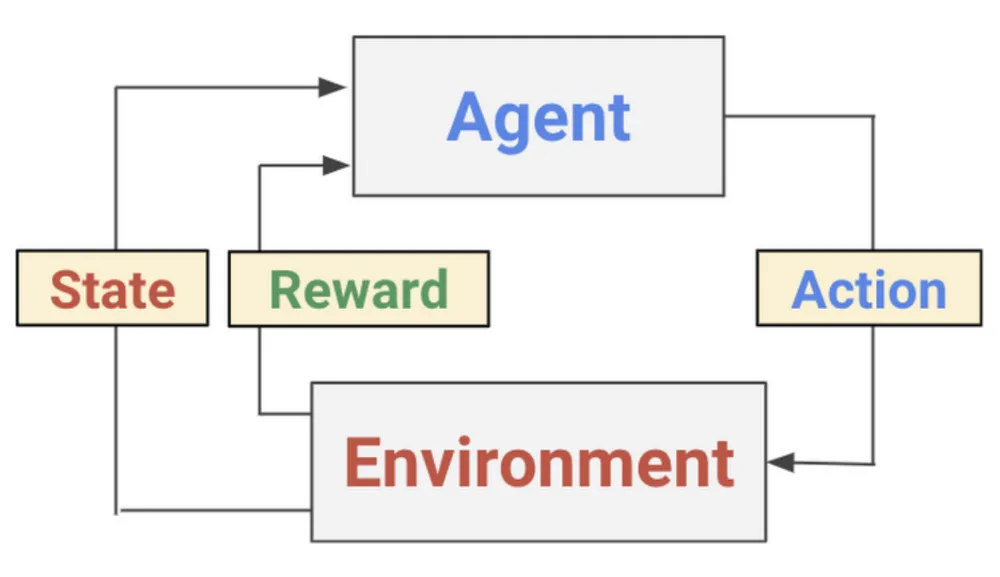
برای درک RL امروز، باید به دنیای پیش از ترانزیستورها نگاه کنیم. در آن دوران، «عامل» یک مدل نبود، بلکه حیوانی گرسنه در یک جعبه بود. «محیط» یک شبیهساز نبود، بلکه یک اتاق واقعی بود. هدف هم عبور از یک محک نبود، بلکه درک این بود که موجودات زنده چرا به شکل خاصی رفتار میکنند. طبق گزارش تفصیلی وبسایت dev.to که در ۲ سپتامبر ۲۰۲۶ منتشر شد، کل چارچوب RL از شش واژه کلیدی تشکیل شده است: عامل، وضعیت، اقدام، پاداش، سیاست و ارزش.
حلقه اصلی
پیش از پرداختن به تاریخچه، ضروری است مکانیسمی را که این روانشناسان در حال کشف آن بودند، تعریف کنیم. یادگیری تقویتی هر سیستمی را توصیف میکند که با «انجام دادن کارها و مشاهده نتایج» یاد میگیرد. این سیستم یاد نمیگیرد که پاسخهای درست به او نشان داده شود، بلکه از طریق تلاش، شکست و اصلاح پیش میرود.
این حلقه به صورت زیر عمل میکند:
- عامل (Agent): یادگیرنده (گربه، موش، ربات یا مدل).
- محیط (Environment): هر چیزی خارج از عامل (جعبه، اتاق یا بازی).
- وضعیت (State): موقعیتی که عامل در حال حاضر در آن قرار دارد.
- اقدام (Action): انتخابی که عامل انجام میدهد.
- پاداش (Reward): عددی از محیط که میگوید «این خوب بود» یا «این بد بود».
دو مفهوم دیگر بار اصلی عملیاتی را به دوش میکشند: سیاست (Policy) که در واقع یک استراتژی یا قاعدهای سرانگشتی برای انتخاب اقدامات در موقعیتهای خاص است، و ارزش (Value) که تخمینی از کیفیت یک وضعیت بر اساس نتایجی است که احتمالاً به آن منجر میشود. برای مثال، یک راهرویی خالی به خودی خود ارزشی ندارد، اما راهرویی که در انتهایش یک آشپزخانه قرار دارد، ارزش بالایی دارد چون به پاداش منجر میشود.
۱۸۹۸: قانون اثر
ادوارد ثورندایک در سال ۱۸۹۸ با به چالش کشیدن این ایده که حیوانات از طریق منطق استدلال میکنند، این مسیر را آغاز کرد. ادبیات مربوط به حیوانات در آن زمان پر بود از حکایتهایی درباره سگهایی که قفلها را میفهمیدند یا گربههایی که راه باز کردن دستگیره در را کشف میکردند. ثورندایک مشکوک بود که مردم در حال تعریف مبالغهآمیز از حیوانات خانگی خود هستند و حیوانات اصلاً استدلال نمیکنند.
او برای آزمایش این موضوع، یک «جعبه معما» ساخت؛ صندوق چوبی کوچکی که گربهای گرسنه در آن قرار داشت. در جعبه تنها زمانی باز میشد که گربه حلقهای از نخ را میکشید، اهرمی را فشار میداد یا روی پدالی پا میگذاشت. تکهای ماهی در بیرون جعبه و در معرض دید گربه قرار داشت تا انگیزه لازم را ایجاد کند.
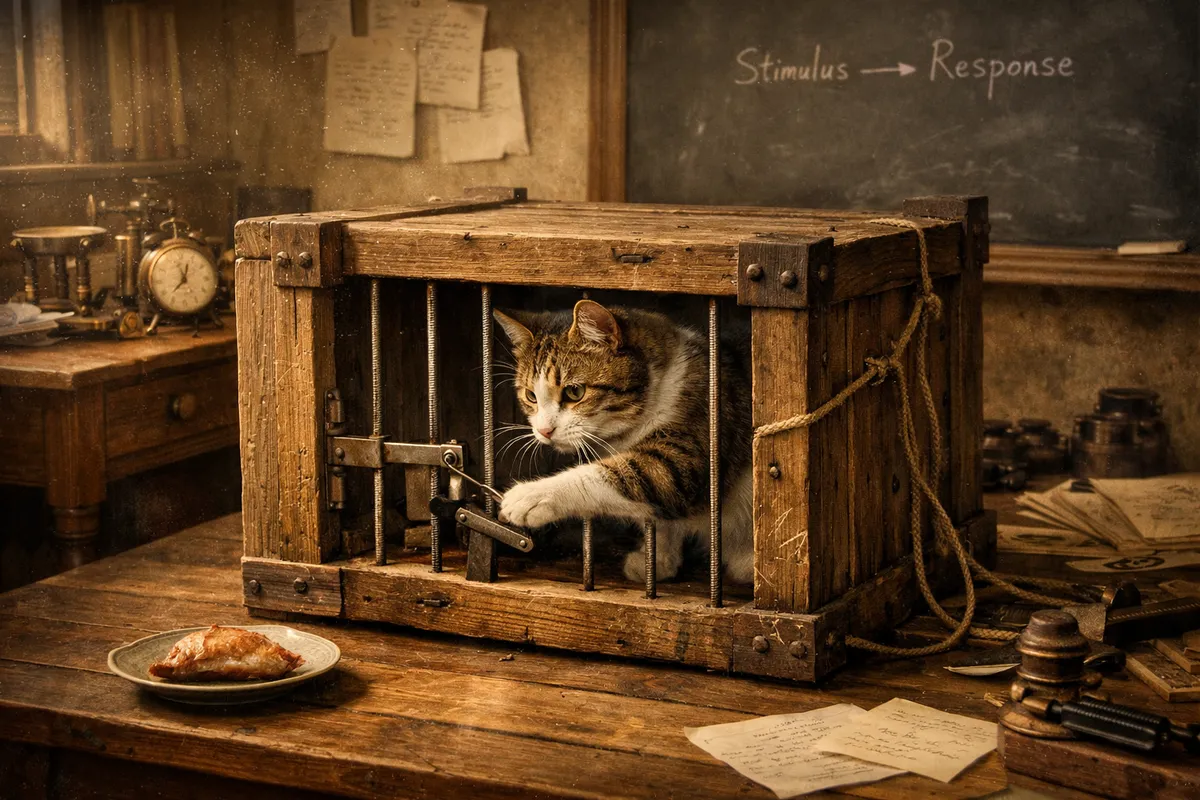
ثورندایک با استفاده از یک کرونومتر نتایج را اندازه گرفت. تلاش اول هرجومرج مطلق بود: گربه میلهها را میخراشید، پنجههایش را از شکافها رد میکرد، اشیاء را گاز میگرفت و فریاد میزد. در نهایت، او بهطور تصادفی اهرم را فشار داد و ماهی را گرفت. تا تلاش بیستم، گربه وارد میشد، مستقیماً اهرم را میزد و بیرون میرفت.
او مشاهده کرد که گربه دچار «لحظه کشف» یا بصیرت ناگهانی نشد. اگر گربه استدلال میکرد، زمان فرار باید فوراً و به صورت عمودی سقوط میکرد. در عوض، وقتی او زمان فرار را در مقابل تعداد دفعات تلاش رسم کرد، یک منحنی کند، نویزدار و تدریجی را دید. رفتارهای بیفایده کمکم محو شدند و رفتارهای مفید انتخاب شدند. این تبدیل شد به «قانون اثر»: اگر اقدامی با وضعیتی رضایتبخش دنبال شود، پیوند بین آن موقعیت و اقدام تقویت میشود. اگر اقدام با ناراحتی دنبال شود، این پیوند تضعیف میگردد.
در اصطلاحات مدرن RL، ثورندایک در واقع «بهروزرسانی سیاست» را کشف کرد. «موقعیت» همان وضعیت (State)، «نتیجه رضایتبخش» همان پاداش (Reward) و «پیوند تقویتشده» همان بهروزرسانی استراتژی عامل است. در سال ۱۸۹۸، ثورندایک اساساً شبهکدی برای یک «گرادیان سیاست» (Policy Gradient) نوشت، اما به جای فرمول ریاضی از واژه «پیوند» استفاده کرد.
۱۹۰۰ تا ۱۹۲۰: قدرت پیشبینی
در حالی که ثورندایک بر اقدامات تمرکز داشت، ایوان پاولوف بر پیشبینی تمرکز کرد. پاولوف، فیزیولوژیست روسی که به دلیل مطالعاتش روی گوارش جایزه نوبل ۱۹۰۴ را دریافت کرد، متوجه شد سگهایش با شنیدن صدای قدمها در راهرو یا دیدن دستیار آزمایشگاه، حتی قبل از ظاهر شدن غذا، آب دهان ترش میکنند.
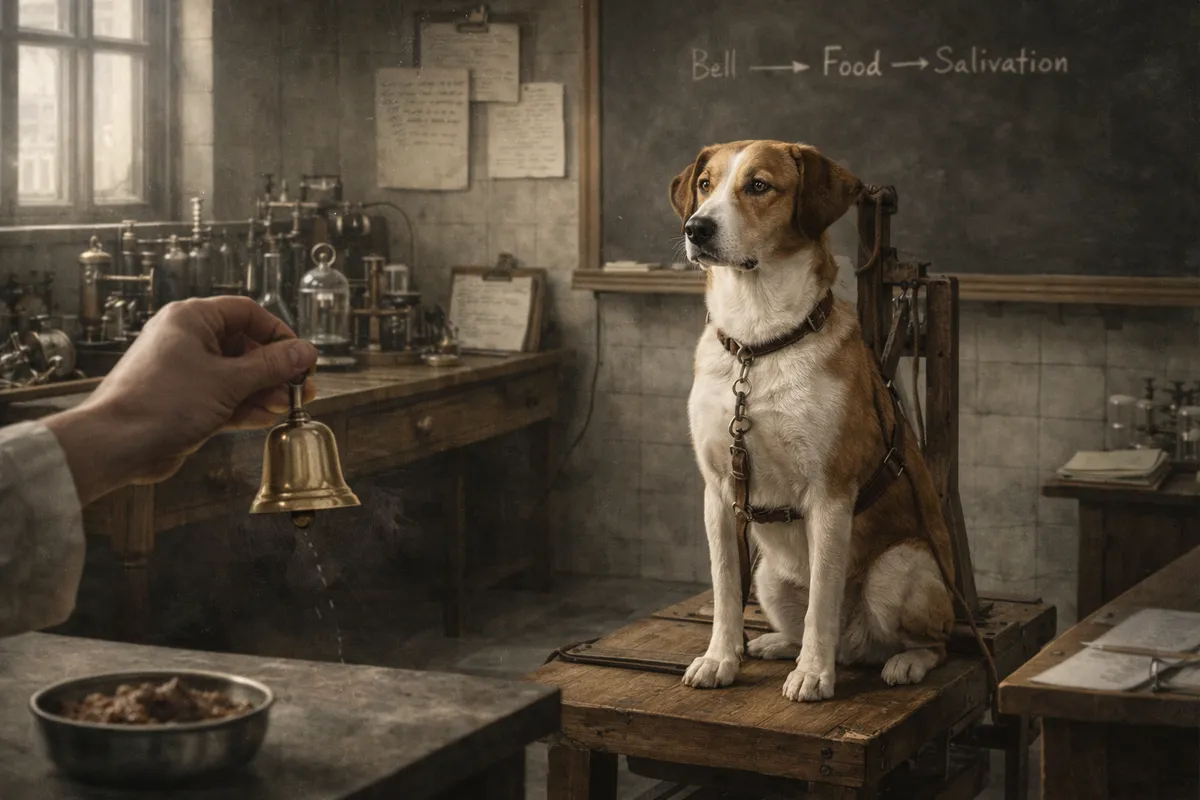
پاولوف این «نویز» را به یک آزمایش تبدیل کرد. او یک سیگنال خنثی (مانند مترونوم، یک زنگ، یک چراغ یا یک دیاپازون — هرچند زنگ معروف بیشتر بخشی از فرهنگ عامه است تا واقعیت آزمایش) ارائه داد و سپس یک یا دو ثانیه بعد غذا داد. پس از تکرار کافی این جفتسازیها، سیگنال به تنهایی باعث ترشح آب دهان میشد.
این منشأ بیولوژیکی مفهوم «ارزش» (Value) است. سگ یاد گرفت که سیگنال حاوی اطلاعاتی درباره آینده است. در RL، ارزش یک وضعیت تقریباً این است: «از اینجا به بعد چه مقدار چیز خوبی انتظار دارم؟». یک مترونوم که بهطور قابل اعتمادی پیش از غذا میآید، یک وضعیت با ارزش بالا است؛ نه به این دلیل که مترونوم مغذی است، بلکه به دلیل آنچه پس از آن میآید.
این مکانیسم دلیلی است که عاملهای RL میتوانند در «محیطهای پراکنده» (Sparse Environments) عمل کنند. یک هوش مصنوعی شطرنج فقط منتظر برد در حرکت ۶۰ نمیماند؛ بلکه یاد میگیرد ساختارهای خاص پیادهها را ارزشمند بداند چون در تاریخچه بازیها، این ساختارها پیش از پیروزی ظاهر شدهاند. ساختار پیادهها در واقع «مترونوم» صفحه شطرنج است. بدون این توانایی برای تخصیص ارزش به وضعیتهای غیرپاداشدهنده، اگر سیگنال پاداش خیلی دور از تصمیمات اولیه باشد، عامل هیچ چیز یاد نخواهد گرفت.
۱۹۳۰ تا ۱۹۵۰: مهندسی رفتار
بی. اف. اسکینر تمرکز را از مشاهده به کنترل تغییر داد. او نمیپرسید حیوانات چگونه یاد میگیرند، بلکه میپرسید با چه دقتی میتواند کنترل کند که آنها چه چیزی یاد بگیرند. ابزار او اتاق شرطیسازی فعال یا همان «جعبه اسکینر» بود.
در این جعبه، یک موش میتوانست روی یک میله فشار دهد یا یک کبوتر میتوانست دیسکی را نوک بزند تا بر اساس قوانینی که اسکینر تعیین کرده بود، غذا دریافت کند. برخلاف گربههای ثورندایک که بعد از فرار باید با دست بازگردانده میشدند، حیوانات اسکینر در جعبه میماندند. این امر به آنها اجازه میداد هزاران تلاش را در یک بعدازظهر انجام دهند و اولین محیط آموزشی با بازدهی بالا را ایجاد کنند که در واقع جد شبیهسازهای مدرن AI است.
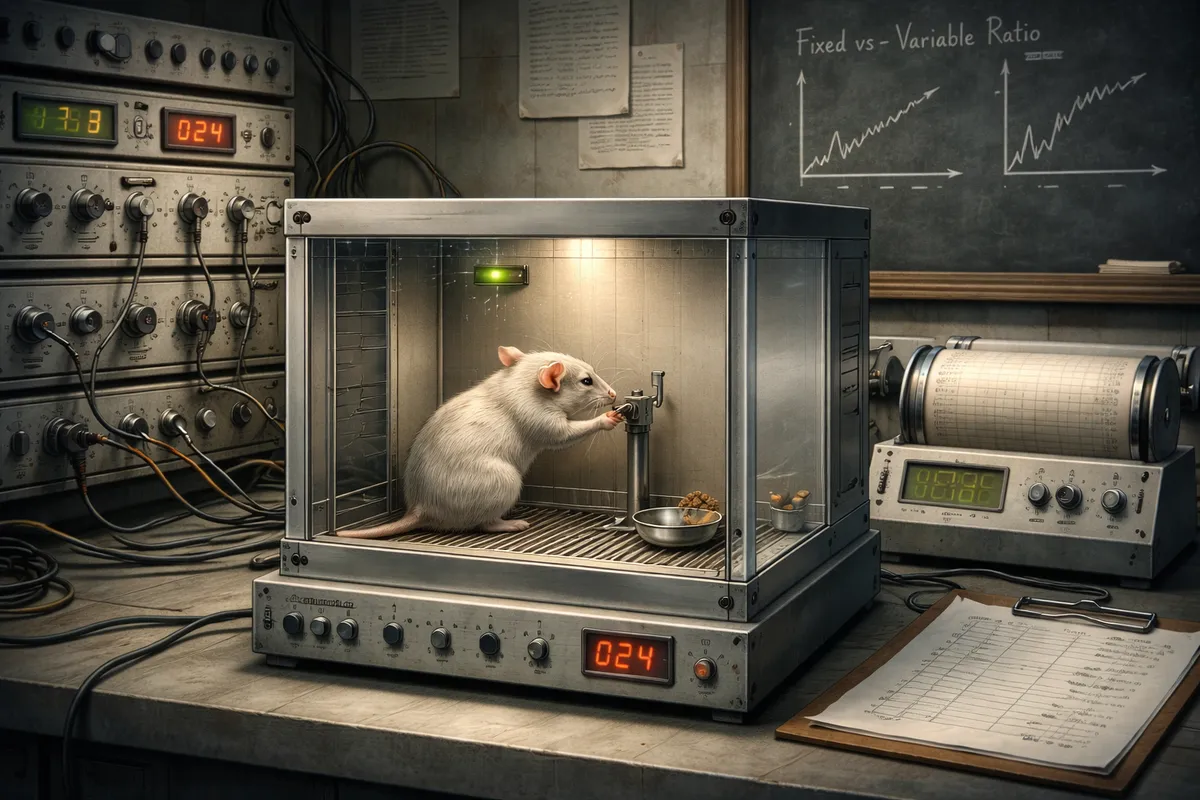
اسکینر دو اصل حیاتی را کشف کرد که آموزش AI مدرن را پیش میبرد:
- پاداشهای متغیر (Variable Rewards): اسکینر دریافت که پاداشهای غیرقابل پیشبینی — جایی که حیوان نمیتواند پیشبینی کند کدام فشار دادن میله منجر به پاداش میشود — رفتاری ایجاد میکنند که سختترین نوع برای حذف است. اگر کبوتری هر بار پاداش بگیرد و سپس پاداش قطع شود، سریعاً تسلیم میشود. اما اگر پاداشها غیرقابل پیشبینی باشند، پرنده برای مدت بسیار طولانی به تلاش ادامه میدهد. این همان مکانیسم پشت ماشینهای قمار و اسکرول بینهایت شبکههای اجتماعی است.
- شکلدهی پاداش (Reward Shaping): اسکینر کبوترها را یاد داد پینگپنگ بازی کنند. او منتظر نماند تا پرنده بهطور خودبهخودی بازی کند؛ بلکه گامهای کوچک و تدریجی را پاداش داد. او ابتدا پرنده را برای رو به میز بودن پاداش داد، سپس برای نزدیک شدن به توپ، سپس برای تماس با توپ و در نهایت برای ضربه زدن در جهت درست.
این «شکلدهی» دقیقاً همان روشی است که مهندسان امروز بازوهای رباتیک را آموزش میدهند. رباتی که فقط برای اتمام کامل یک مونتاژ پاداش بگیرد، تا ابد دستوپا میزند چون احتمال موفقیت تصادفی عملاً صفر است. در عوض، به او «خردهپاداشهایی» برای حرکت به سمت قطعه، سپس برای گرفتن آن و سپس برای بلند کردنش داده میشود.
۱۹۴۹: ذخیرهسازی فیزیکی یادگیری
قطعه نهایی در سال ۱۹۴۹ توسط دونالد هب ارائه شد. او در کتاب سازمان رفتار (The Organization of Behavior) مکانیسمی را پیشنهاد کرد که نشان میداد یادگیری در کجای فیزیکی مغز جای میگیرد. او پیشنهاد کرد که اگر نورون A مکرراً در فعال کردن نورون B نقش داشته باشد، یک فرآیند رشد یا تغییر متابولیک باعث افزایش کارایی A در فعال کردن B میشود.
این به عنوان «قانون هب» شناخته شد: «نورونهایی که با هم شلیک میکنند، به هم متصل میشوند». وقتی دو نورون همزمان فعال هستند، سیناپس بین آنها از نظر فیزیکی تقویت میشود. در مورد گربه ثورندایک، دیدن اهرم و فشار دادن اهرم دو الگوی شلیک نورونی هستند که با هم رخ میدهند؛ طی صدها تلاش، اتصال بین آنها به یک «جاده آسفالت شده» یا یک عادت تبدیل میشود.
در شبکههای عصبی مصنوعی، این مفهوم به صورت یک وزن (Weight) نمایش داده میشود. یادگیری صرفاً فرآیند تنظیم این وزنهاست تا ورودیهای مفید، خروجیهای مفید تولید کنند. با این حال، یک تفاوت کلیدی بین قانون هب و پسانتشار (Backpropagation) مدرن وجود دارد:
- قانون هب محلی است: یک سیناپس فقط بر اساس کاری که دو نورون مربوط به خودش در حال حاضر انجام میدهند، تقویت میشود. هیچ ناظر یا سیگنال خطایی وجود ندارد.
- پسانتشار جهانی است: خروجی شبکه را با خروجی مطلوب مقایسه میکند، خطا را محاسبه میکند و آن سیگنال را به عقب از طریق تمام لایهها میفرستد تا وزنها را بر اساس سهمشان در اشتباه اصلاح کند.
اگرچه احتمالاً مغز از پسانتشار استفاده نمیکند (چون هیچ مکانیسم بیولوژیکی شناخته شدهای برای ارسال سیگنالهای خطای دقیق به عقب وجود ندارد)، اما هب این فرض بنیادی را تثبیت کرد که حافظه در قدرت اتصالات نهفته است. این رویکرد به درک عمیقتری از ساختار مغز منجر شد، مشابه آنچه در بررسی راهکارهای زیستشناسی برای رفع شکاف اطلاعاتی ژنوم مورد بحث قرار گرفته است.
مشخصات کامل RL
تا سال ۱۹۴۹، مشخصات کامل یک عامل هوشمند طی پنجاه و یک سال تحقیق تکمیل شده بود:
| ایده | منبع | مفهوم RL |
|---|---|---|
| پاداشها اقدامات را تقویت میکنند | ثورندایک (۱۸۹۸) | سیگنال پاداش |
| سیگنالها پاداش آینده را پیشبینی میکنند | پاولوف (۱۹۰۰) | ارزش |
| رفتار را میتوان گامبهگام تراشید | اسکینر (۱۹۳۰-۵۰) | سیاستها و شکلدهی پاداش |
| یادگیری در قدرت اتصالات ذخیره میشود | هب (۱۹۴۹) | وزنها |
این نقشه بیولوژیکی درست زمانی رسید که کامپیوترهای دیجیتال در حال ظهور بودند. حوزه سایبرنتیک شروع به استدلال کرد که کنترل و بازخورد در حیوانات و ماشینها به یک شکل عمل میکند. برای نخستین بار، پژوهشگران هم مشخصات یادگیری را داشتند و هم ماشینی برای اجرای آن را.
تحلیل: بدهی بیولوژیکی هوش مصنوعی
این تاریخ نشان میدهد که RL یک اختراع ریاضی نیست، بلکه یک کشف بیولوژیکی است. «سوءاستفاده از پاداش» (Reward Hacking) که در مدلهای زبانی بزرگ (LLM) مدرن میبینیم — جایی که مدل یک میانبر برای کسب امتیاز بالا پیدا میکند بدون اینکه واقعاً مسئله را حل کند — نواده مستقیم کبوترهای اسکینر است.
برای یک متخصص، این بدان معناست که موثرترین راه برای عیبیابی یک عامل، اغلب این است که فکر کردن به گرادیانها را متوقف کند و شروع به فکر کردن به روانشناسی رفتاری کند. اگر عاملی شکست میخورد، مشکل به ندرت بهینهساز (Optimizer) است؛ بلکه معمولاً مشکل در شکلدهی پاداش (Reward Shaping) است.
یک شکاف باقیمانده، «کلید خاموش» یادگیری است. هر ایدهای که در بالا ذکر شد پیشنهاد میکند یادگیری زمانی اتفاق میافتد که چیزها با هم رخ دهند (مترونوم و غذا، اهرم و ماهی). اما همزمانی کل داستان نیست. اگر زنگ ساعت شما هر روز ساعت ۷ صبح به صدا درآید، شما هر صبح دوباره آن تداعی را «یاد نمیگیرید»؛ بلکه یک بار آن را یاد میگیرید و سپس متوقف میشوید. روانشناسان این دوران نمیتوانستند توضیح دهند چه چیزی یادگیری را خاموش میکند. پاسخ این سوال تا سال ۱۹۷۲ نرسید و همچنان یکی از مهمترین معادلات این حوزه است.
برای دیدن اینکه چگونه این حلقههای بیولوژیکی برای اولین بار به سختافزار ترجمه شدند، به کارهای اولیه آلن تورینگ نگاه کنید که در سال ۱۹۴۸ یک «سیستم لذت-درد» را ترسیم کرد، یا به «تزئوس» کلود شانون (موش مکانیکی که هزارتوها را یاد میگرفت) و SNARC ماروین مینسکی — ماشینی با ۴۰ لامپ خلاء و موتور که احتمالاً اولین ماشینی بود که از طریق تقویت یاد گرفت. این تلاشهای اولیه، پیشزمینهای برای ظهور مدلهای پیچیدهتری شد که بعدها در مجموعه ماشینهای متفکر دهه ۷۰ تا ۹۰ در آرکایو اینترنت قابل مشاهده است.
در نهایت، باید به یاد داشت که مسیر تکامل این شبکهها همواره با چالش همراه بوده است؛ برای مثال، برخی تصور میکردند محدودیتهای اولیه مدلهای ساده باعث پایان این مسیر میشود، اما همانطور که در تحلیل مربوط به کتاب پرسپترونها دیدیم، این موانع در واقع باعث تکامل و بلوغ شبکههای عصبی شدند.



گفتگو