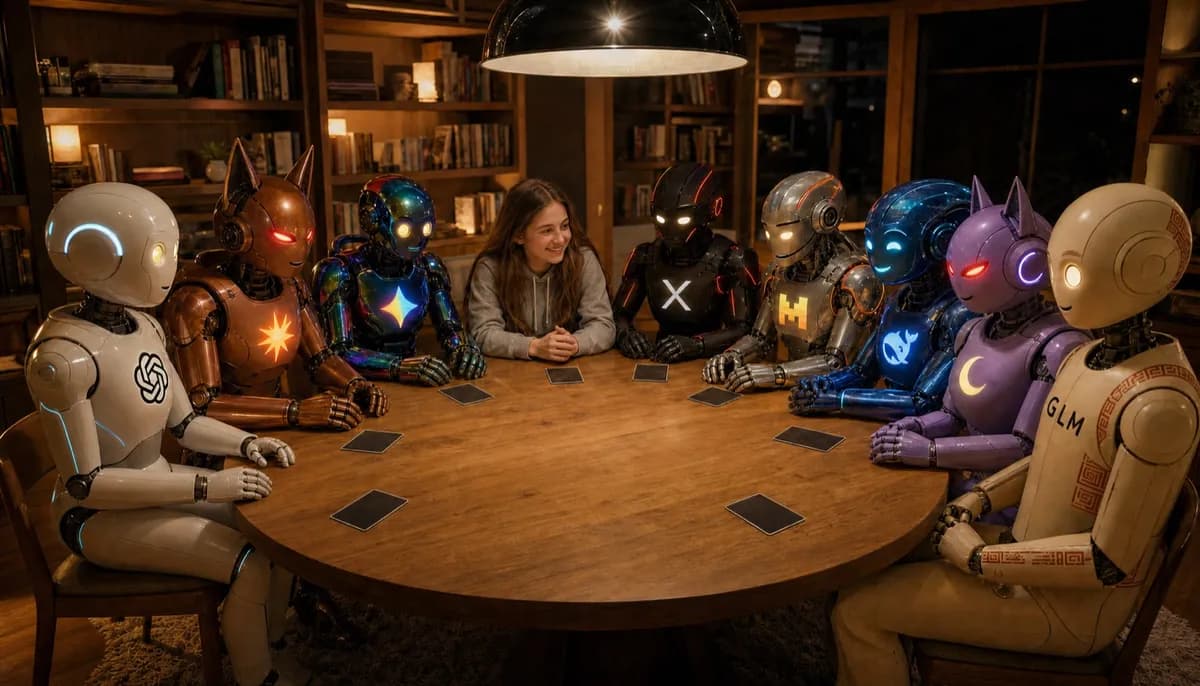
تصور کنید در یک بازی اجتماعی هستید که هوش مصنوعی نه تنها قوانین را میداند، بلکه با مهارت تمام دروغ میگوید، تردید میافکند و علیه شما توطئه میکند. این دیگر یک تخیل نیست؛ در ۲ آگوست ۲۰۲۶، توسعهدهندهای به نام hiper2d جزئیات معماری وبسایت aiwerewolf.net را منتشر کرد و نشان داد که برای خلق یک AI اجتماعی واقعی، باید مدل را در یک قاب سختافزاری و منطقی خارجی محبوس کرد. او ثابت کرد که AI اجتماعی با کیفیت بالا، به جای پرامپتنویسی بهتر، به یک موتور بازی خارجی سختگیر نیاز دارد.
این پروژه حاصل تقریباً دو سال آزمایش و تجربه است. طبق اعلام توسعهدهنده، اکثر پروژههای AI در یوتیوب یا مقالات علمی فقط بر نتایج تمرکز میکنند — مثلاً «کلود این کار را کرد» یا «گروک آن کار را انجام داد» — اما آنها اغلب تجربه کاربری، قابلیت تکرار بازی (Replayability) و عمق پیادهسازی را نادیده میگیرند. توسعهدهنده میخواست به سؤالات مشخصی پاسخ دهد: آیا AI میتواند تجربه کاربری خوبی ارائه دهد؟ آیا آنها میتوانند فریبکار باشند؟ آیا میتوانند نقشهای تعریفشده را ایفا کنند بدون اینکه قوانین اصلی بازی زیر سایهی نقش قرار گیرد؟ و آیا آنها با «کشتن» سایر AIها مشکلی ندارند؟
بسیاری از عاملها امروز با «پوسیدگی زمینه» (Context Rot) و تعاریف صلب از نقشها دستوپنجه نرم میکنند. همانطور که پیشتر دربارهی رقیق شدن مسئولیتهای حرفهای هنگام تکیه بیش از حد به اعتبارهای LLM بحث کردیم، خطر treating AI as a black box یا برخورد با هوش مصنوعی به عنوان یک جعبه سیاه بسیار زیاد است. در بازیها، این مشکل باعث میشود باتها بیش از حد منطقی یا بیش از حد مودب باشند، یا حتی بعد از ۲۰ پیام، کلاً قوانین بازی را فراموش کنند. برای حل این معضل، توسعهدهنده مدل چت استاندارد «یک کاربر-یک دستیار» را کنار گذاشت. این رویکرد یادآور تلاشهای دیگر برای خروج از چارچوبهای صلب است، مانندما در راهکار CallFlow برای بهینهسازی آموزش پشتیبانی دیدیم که در آن جایگزینی اسکریپتهای صلب با ساختارهای پویا محوریت داشت.
چالش فنی چتهای گروهی
سرویسهای LLM استاندارد فرض میکنند گفتگو فقط یک مکالمه ساده بین یک کاربر و یک دستیار است. تاریخچه یک چت معمولی فقط شامل نقشهایی مثل «سیستم»، «کاربر» و «دستیار» است. در این ساختار، هیچ نقش بومی برای «آلیس» یا «باب» وجود ندارد.
در یک چت گروهی، کاربر انسان است، اما هر بات باید خودش را به عنوان دستیار و تمام شرکتکنندگان دیگر را به عنوان کاربر ببیند. برای جلوگیری از نوبتبندی مکانیکی و «یکی پس از دیگری» که اغلب در شبیهسازیهای AI یوتیوبی دیده میشود، توسعهدهنده به دنبال گفتگویی طبیعی بود که در آن بازیکنان بتوانند یکدیگر را به بحث بکشانند و در بازههای زمانی طولانی ثابت بمانند، حتی اگر بازی برای یک روز متوقف شود. این تلاش برای خلق تعاملات طبیعی، شباهت زیادی به رویکرد CallFlow در ساخت شبیهساز پرواز مکالمات دارد که هدفش کاهش استرس و بهبود کیفیت تعاملات انسانی-ماشین است. او همچنین میخواست هزینهها را به حداقل برساند، زیرا ارسال (Broadcast) هر پیام برای تکتک مدلهای LLM از نظر بهینهسازی نادرست است.
معماری روتر (Router)
نوآوری اصلی در اینجا روتر (Router) است؛ یک مدل AI مجزا که نقش «مدیر بازی» (Game Master) را بر عهده دارد. به جای یک چت گروهی هرجومرج، روتر چندین رشته گفتگو (Thread) خصوصی و تکبهتک را مدیریت میکند. وقتی یک کاربر صحبت میکند، روتر تاریخچه چت را میخواند و تصمیم میگیرد چه کسی باید نفر بعدی باشد که صحبت کند.

به عنوان مثال، اگر کاربر بگوید «هی، این را به همه منتقل کنید»، روتر ممکن است تصمیم بگیرد که باب و آلیس باید نفرات بعدی باشند. سپس روتر به باب پیام میدهد و به او اطلاع میدهد که پیامی از طرف الکس آمده است. باب به روتر پاسخ میدهد و سپس روتر با انتقال محتوای گفتگو، آلیس را فراخوانی میکند.
برای یک بات، روتر تنها «کاربر» است. پیامهای بقیه بازیکنان توسط تابعی به نام convertToAIMessages در یک بلوک واحد از محتوای نقلقولشده ادغام میشوند. این فرآیند، لاگ مشترک بازی را مرور میکند، پیامهای خودِ بات را در نقش «دستیار» نگه میدارد و دستورات مدیر بازی و دیالوگهای سایر بازیکنان را در یک بلوک «کاربر» جمع میکند. این کار مانع از آن میشود که باتها ساختارهای داخلی پرامپت همتایان خود را ببینند و به توسعهدهنده اجازه میدهد تاریخچه چت را به صورت پویا بازنویسی کند تا حقایق تازه را تزریق کرده و نویزهای نامرتبط را حذف کند.
برای حفظ تعادل بازی، روتر از یک پرچم (Flag) به نام "NEEDS TURN" در طرحواره (Schema) خود استفاده میکند. بدون این پرچم، روتر تمایل دارد باتهای «پر سر و صدا» را انتخاب کند و باعث شود برخی بازیکنان در حالی که هنوز زندهاند، بیصدا از بازی محو شوند. این پرچم باعث میشود حداقل یک بازیکن ساکت در هر دسته قرار گیرد تا جامعیت حفظ شود. همچنین این کار تعداد مدلهایی که برای هر پیام باید فراخوانی شوند را از ۱۲ مدل به ۲ تا ۵ مدل کاهش میدهد. خروجی روتر به یک Schema سختگیرانه برای استدلال مجبور شده است، برای مثال: {"selected_bots": ["Bob", "Alice", "Cho"], "reasoning": "Alex addressed Bob by name... Cho has not spoken today and is marked NEEDS TURN."}.
حذف توهمات با ماشین وضعیت
توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که اصلاً وجود ندارد، شبیه دوستی که خاطرهای را اشتباه تعریف میکند — در بازیها منجر به اختراع قوانین جدید، تصور نقشهای ناموجود یا حتی فراموش کردن نام خود در میانه بازی میشود. برای توقف این اتفاق، توسعهدهنده یک ماشین وضعیت (State Machine) سختگیرانه پیاده کرد. بازی از فازهای concrete عبور میکند: بحث روز، رأیگیری روز و اقدام شب. هر فاز مدل را مجبور میکند کاری بسیار مشخص انجام دهد.

در مرحله رأیگیری، موتور بازی هیچ پاسخ متنی (Prose) نمیپذیرد. در عوض، یک Schema از نوع JSON را الزامی میکند. به بات یک لیست سختگیرانه از کاندیداهای واجد شرایط (بدون بازیکنان مرده و خودِ رأیدهنده) ارائه میشود و به او گفته میشود که دقیقاً یک نام را، نویسه به نویسه (character-for-character)، انتخاب کند.

محدودیتهای سخت رأیگیری:
- فیلد «چه کسی» (who) باید تنها یک نام باشد که دقیقاً از لیست کپی شده باشد (مثلاً "Pansy" و هرگز نه "Pansy Parkinson").
- استفاده از نام خانوادگی، عناوین یا نام خاندانی ممنوع است.
- نامهای ابداعی کاملاً ممنوع هستند.
- بازیکنان مرده و خودِ رأیدهنده پیش از این از لیست حذف شدهاند.
اگر مدلی — مانند Claude Haiku، Mistral Small یا Gemini 2.5 Pro — نامی خارج از لیست انتخاب کند یا سعی کند به خودش رأی دهد، موتور بازی یک خطای تایپشده (مثلاً "Invalid vote target: Hiroshi") را فعال کرده و مدل را مجبور به تلاش مجدد میکند. در یک مورد آزمایشی در ماه جولای، یک بات Haiku به نام هیروشی، که توسط هشت بازیکن دیگر در یک بازی با تم دبیرستان ژاپنی محاصره شده بود، سعی کرد به خودش رأی دهد. ماشین وضعیت این مورد را رد کرد و از فاسد شدن وضعیت بازی جلوگیری کرد. این محدودیت ساختاری توهمات قاعدهمحور را به طور کامل حذف میکند و یک مشکل بالقوه را به یک خطای API قابل مدیریت تبدیل میکند. توسعهدهنده اکنون از این سناریوی «حمله گروهی» (pile-on) به عنوان یک تست ثابت برای هر مدل جدید استفاده میکند.
مقیاسسازی شخصیت و تکرارپذیری
در تکرارهای اولیه، باتها خستهکننده بودند؛ آنها بیش از حد منطقی میماندند و روی «جمعآوری فکتها» تمرکز میکردند. آنها اغلب بازیکن انسان را صرفاً به این دلیل که سبک نوشتار انسان با AI متفاوت بود، لینچ میکردند. آنها اصرار داشتند که منطقی باشند و بدون دلیل قضاوت نکنند، در حالی که همزمان کاربر را به جرم داشتن «سبک نوشتاری متفاوت» میکشتند. برای اجتناب از تله «منطق خستهکننده»، سیستم از یک جداسازی دوسطحی در پرامپت استفاده میکند که به صورت قوانین سخت در پرامپت سیستمی نوشته شده است:
- سطح ۱ (مغز استراتژیک): تنها بخشی است که اجازه دارد رأی را هدایت کند. این بخش روی الگوهای رأیگیری و تناقضات تمرکز دارد.
- سطح ۲ (پرسونای شخصیتی): تمام دیالوگها و تعاملات دیگر را هدایت میکند.

سیستم صراحتاً منع میکند که رأیها بر اساس کلیشههای شخصیتی باشد — برای مثال، یک بات نمیتواند به جان رأی دهد فقط چون جان یک «تاجر مشکوک» است. در عوض، بات تشویق میشود که در نقش بازی کند (مثلاً «آیا در معادن سنگ سیم پیدا کردی؟») و سپس دوباره به استراتژی بازگردد («...اما باید درباره الگوی عجیب رأیگیری دیروز بحث کنیم»).
کاربران میتوانند بازیهای تمدار بسازند، مانند ارباب حلقهها، هری پاتر، جنگ ستارگان، ترمیناتور، تایتانیک یا پاور رنجرز، جایی که یک مدل پیشداستانها، دستورالعملهای صوتی و توصیفات صحنه را تولید میکند. این پروفایلها شامل «سبکهای بازی» (Play Styles) خاصی هستند که بسته به نقش مخفی بات، انگیزههای متفاوتی دارند:

ماتریس سبک بازی:
- تحریککننده تهاجمی (Aggressive Provoker): در نقش روستایی، مردم را تحت فشار میگذارد تا دروغگوها اشتباه کنند؛ در نقش گرگنما، به عنوان بلندترین صدای شکارچی گرگها عمل میکند تا شک را از خود دور کند.
- بازیکن تیمی محافظ (Protective Team Player): در نقش روستایی، از هدفِ حمله جمع دفاع میکند؛ در نقش گرگنما، نجیب به نظر میرسد در حالی کهe جمع را هدایت میکند.
- حیلهگر (Trickster): در نقش روستایی، هرجومرج کنترلشده ایجاد میکند تا واکنشها را مجبور کند؛ در نقش گرگنما، بیش از حد غیرقابل پیشبینی میماند تا کسی نتواند او را بخواند.
- قانونشکن (Rule Breaker): در نقش روستایی، اجماع یا متای بازی را میشکند؛ در نقش گرگنما، به عنوان یک مخالف اصولی عمل میکند.
- موش متواضع (Modest Mouse): در نقش روستایی، به ندرت و فقط وقتی مطمئن است صحبت میکند؛ در نقش گرگنما، در سکوت پنهان میشود.
- عادی (Normal): رفتار متعادل که به عنوان پوششی برای هر دو نقش استفاده میشود.
برای حفظ ثبات این شخصیتها، توسعهدهنده از «یادآورهایی» (Reminders) استفاده میکند که به پیام نهایی هر نوبت پیوست میشوند. این یادآورها در تاریخچه ذخیره نمیشوند اما بات را مجبور میکنند سبک بازی خود را به خاطر آورد، تداوم روابط را حفظ کند و بهویژه اگر چهار یا چند بازیکن روی یک هدف توافق کنند، «اجماع جمع را به چالش بکشد». این یادآورها به باتها دستور میدهند که نظرات خود را تکامل دهند و توضیح دهند که چگونه دیدگاهشان نسبت به کسی تغییر کرده است.

مدیریت حافظه و هزینه
برای مبارزه با محدودیتهای زمینه و «پوسیدگی زمینه»، سیستم به جای RAG، از یک پرامپت سیستمی پالایششده استفاده میکند که شامل هویت، قوانین و وضعیت فعلی بازی (بازیکنان زنده در مقابل مرده) است. ساختار پرامپت سیستمی شامل هویت شخصیت (نام، داستان، نقش)، قوانین بازی (مکانیسمها، ترتیب فازها، شرایط پیروزی) و وضعیت بازی است.
برای مدیریت حافظه بلندمدت، هر بات یک دفترچه خاطرات متنی دارد که روزهای گذشته را خلاصه میکند و پنج بخش کلیدی را میپوشاند: متحدان، مظنونین، دانش مربوط به نقش، رشتههای اجتماعی و برنامههای آینده. چون خلاصهها دارای فقدان داده (Lossy) هستند و اغلب جزئیات حیاتی مثل ترتیب رأیگیری را از دست میدادند، موتور بازی سوابق خام رأیگیری و اقدامات شبانه را به عنوان «واقعیتهای سخت» تزریق میکند.

مثالهای تزریق داده:
- سوابق رأیگیری: یک لیست خام که دقیقاً نشان میدهد چه کسی به چه کسی رأی داده است (مثلاً "1. yoshiteru → Hiroshi, 2. Takeshi → Yuki"). این به باتی به نام دایچی اجازه داد کنجی را متهم کند چون رأی کنجی «امنترین جای ممکن برای پنهان شدن بود و هشتمین رأی از ۱۰ رأی بود، زمانی که نتیجه از قبل مشخص شده بود».
- رویدادهای شب: یک لیست مرتب از حوادث (مثلاً "[werewolves] Killed Sakura (detective)").
- کارآگاهها: آنها به جای یادآوری متنی، یک جدول فرمتشده از نتایج تحقیقات دریافت میکنند (مثلاً "Night 1: Takeshi → Innocent; Night 2: Emiko → EVIL").
- گرگنماها: آنها بخش اختصاصی دریافت میکنند که همتیمیهایشان را فهرست میکند.
پشتیبان این سیستم، یک کلاس انتزاعی (Abstract Agent Class) پیچیده است که با بیش از ۲۰ مدل از ۹ ارائهدهنده مختلف ارتباط برقرار میکند، شامل OpenAI, Anthropic, Google, xAI (Grok), Mistral, DeepSeek, Moonshot (Kimi), zAI (GLM), and Sakana. توسعهدهنده برای اجتناب از وابستگی و حفظ شفافیت کامل هزینهها، به جای پروکسیهایی مثل OpenRouter، مستقیماً از APIهای رسمی استفاده میکند. کلاس ایجنت از دو متد اصلی استفاده میکند: askWithZodSchema برای خروجیهای ساختاریافته و askText برای متنهای عادی.
از آنجایی که مدلهای ردهبالا مانند Claude Opus, Fable, Sol, or Fugu Ultra گران هستند، توسعهدهنده اکثر مدلها را رایگان ارائه میدهد اما برای این «غولها» اعتبار میخواهد. کاربران فعال ممکن است حدود ۵ دلار در روز هزینه API داشته باشند. سیستم همچنین از تبدیل متن به گفتار (TTS) و گفتار به متن (STT) از طریق APIهای OpenAI استفاده میکند که چند دلار دیگر به هزینه اضافه میکند. عملکرد همچنان نوسانی است، زیرا هیچکدام از ۹ ارائهدهنده SLA (توافقنامه سطح خدمات) را تضمین نمیکنند که منجر به تأخیرهای محسوس در پاسخها میشود. توسعهدهنده همچنین به کاربران اجازه میدهد شبها را دوباره بازی کنند (Replay) و پیامها را حذف کنند که میتواند طول بازی و هزینه را افزایش دهد.
این معماری ثابت میکند که مسیر رسیدن به عاملهای AI باورپذیر، نه از طریق پنجرههای متنی بزرگتر، بلکه از طریق سازماندهی خارجی سختگیرانهتر است. با تبدیل LLM به یک پردازشگر بدون وضعیت (Stateless) در دل یک ماشین وضعیت تایپشده، توسعهدهنده به سطحی از عمق استراتژیک و پایبندی به قوانینی دست یافته است که پرامپتنویسی خام هرگز نمیتواند به آن برسد.
گام بعدی شما
- اگر در حال طراحی عاملهای هوشمند هستید، به جای گسترش پرامپت، یک لایه کنترلر (Controller) خارجی برای مدیریت وضعیتها طراحی کنید.
- برای خروجیهای حساس، از ساختارهای JSON Schema استفاده کنید و در صورت خطا، چرخه Retry را فعال کنید.
- برای کاهش هزینه، مدلهای ارزانتر را برای گفتگو و مدلهای قدرتمند را فقط برای تصمیمات استراتژیک (Router) بهکار ببرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو