اگر امروز مدیریت یک پروژه متنباز را بر عهده دارید، احتمالاً با سیل کامنتهای بیروح و تکراری مواجه شدهاید که توسط مدلهای زبانی تولید شدهاند. حالا ابزاری آمده است که میتواند با دقت ۸۸٪، این «آلودگیهای دیجیتال» را از کدهای انسانی تفکیک کند.
به نقل از تحلیل فنی منتشر شده در ۹ سپتامبر ۲۰۲۶ در وبسایت entropicthoughts.com، این طبقهبندیکننده (Classifier) بهجای تکیه بر کلمات کلیدی ساده، «اثر انگشتهای» ساختاری عمیقی را تحلیل میکند که در هر یک از مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — وجود دارد.
تشخیص کدهای تولیدشده توسط هوش مصنوعی بهشدت دشوار است؛ چون کامنتهای فنی معمولاً کوتاه و کاربردی هستند. بیشتر آشکارسازهای فعلی دچار «نشت موضوعی» (Subject Matter Leakage) میشوند؛ یعنی بهجای شناسایی سبک نوشتار، مدل یاد میگیرد که موضوع کد را بشناسد و بر اساس آن حکم دهد. این رویکرد جدید با استفاده از یک مجموعه داده متوازن و سیستم ارزیابی ویژگیهای چندلایه، سعی در حل این مشکل دارد.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تفکیک محتوای سنتتیک از انسانی یکی از بزرگترین چالشهای نظارت بر کیفیت داده است. این چالش در محیطهای اجتماعی نیز دیده میشود، جایی که استفاده از معماریهای دروازهبان برای تفکیک محتوای خلاقانه از بازبینی به راهکاری برای مهار ریسکهای انتشار خودکار تبدیل شده است.
معیارهای عملکرد
عملکرد این ابزار بسته به منبع داده تغییر میکند. در تستهای اعتبارسنجی متقابل (Cross-validation)، صحت متوازن آن ۷۷٪ بود. این عدد نشان میدهد ابزار هر چند بار توانسته است بهدرستی بین انسان و ربات تفاوت قائل شود، با این فرض که احتمال حضور هر دو یکسان باشد.
برای بررسی نقاط ضعف و حالتهای شکست (Failure Modes)، توسعهدهنده از یک ماتریس اغتشاش (Confusion Matrix) استفاده کرد که در آن کلاس «ربات» به عنوان کلاس مثبت در نظر گرفته شده است. نتایج برای مجموعه اعتبارسنجی به این شرح است:
- ورودیهای انسانی (Known-Human): در ۷۳٪ موارد بهدرستی «انسانی» تشخیص داده شدند (TNR = 0.73 و FPR = 0.27).
- ورودیهای رباتیک (Known-Robot): در ۸۰٪ موارد بهدرستی «رباتیک» شناسایی شدند (TPR = 0.80 و FNR = 0.20).
اگرچه نرخ خطای تقریباً ۲۵٪ در هر دو مورد ممکن است بالا به نظر برسد، اما ابزار برای هر قضاوت یک درصد پیشبینی کالیبرهشده ارائه میدهد. طبق گزارش توسعهدهنده، وقتی اطمینان مدل بسیار بالا است — بهطور مشخص ۸۰٪ یا بیشتر — احتمال خطای مثبت کاذب (False Positive) به تنها ۵٪ کاهش مییابد. در مقابل، وقتی سطح اطمینان حدود ۵۰٪ است، ابزار تقریباً نیمی از اوقات حکم اشتباه صادر میکند.
سایر معیارهای استخراجشده از اعتبارسنجی متقابل عبارتاند از:
- دقت (Precision): ۷۵٪
- فراخوانی (Recall): ۸۰٪
- حساسیت (Sensitivity): ۸۰٪
- ویژگی (Specificity): ۷۳٪
- امتیاز F1: ۷۷٪
اما نکته شگفتانگیز زمانی رخ داد که ابزار روی یک مجموعه غیرسنتتیک از کامنتهای واقعی دنیای بیرون تست شد تا میزان تعمیمپذیری (Generalization) آن بررسی شود. در این حالت عملکرد مدل بهشدت جهش کرد:
- صحت (Accuracy): ۸۸٪
- دقت (Precision): ۸۹٪
- فراخوانی (Recall): ۸۶٪
- حساسیت (Sensitivity): ۸۶٪
- ویژگی (Specificity): ۸۹٪
- امتیاز F1: ۸۷٪
این نتایج نشان میدهد که موارد واقعی در دنیای بیرون، برای مدل راحتتر از دادههای آموزشی هستند. کالیبراسیون ابزار نیز از طریق یک منحنی کالیبراسیون تأیید شده است. از آنجا که نقاط بسیار نزدیک به قطر مرجع قرار دارند، احتمالات اختصاصیافته تقریباً دقیق هستند. این موضوع در طولهای مختلف کامنتها صادق است و از یک پارامتر دمای برازششده (Fitted Temperature) برای تنظیم افزایش اطمینان با افزایش حجم دادهها استفاده شده است.
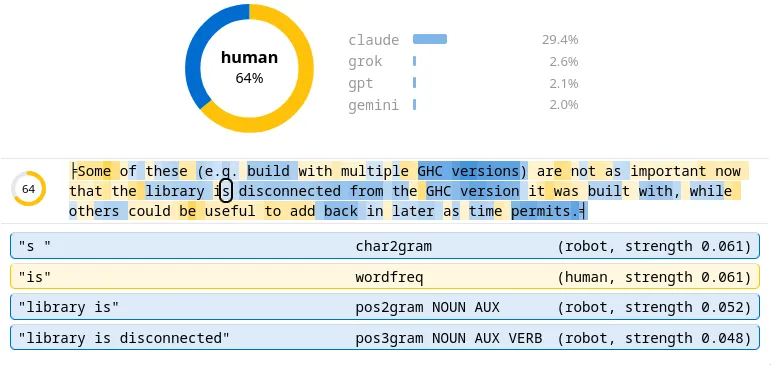
شناسایی «ردپاهای رباتیک»
این سیستم چندین ویژگی زبانی را تحلیل میکند تا شکاف بین سبک انسانی و هوش مصنوعی را بیابد. برخلاف مقالات قبلی که «ویژگیهای خاص کلود» (Claude-isms) را کالبدشکافی میکردند، رابط کاربری جدید به کاربر اجازه میدهد روی هر بخش از متن کلیک کند تا ببیند کدام ویژگیها فعال شدهاند و چگونه در حکم نهایی اثر گذاشتهاند.
مکانیزم ارزیابی ویژگیها
ارزیابی ویژگیها برای پردازنده (CPU) بسیار سنگین است. آموزش روی تمام زیرمجموعههای ۱۵ ویژگی کاندید، به بیش از ۳۰ هزار طبقهبندیکننده مختلف نیاز داشت که هر کدام باید به پنج روش برای اعتبارسنجی متقابل آموزش میدیدند. بنابراین توسعهدهنده با بررسی اینکه کدام ویژگیها (مثلاً فرکانس کاراکترها) بهتر از بقیه (مثلاً طول کلمات) تفاوت بین جفتکلاسهای مختلف (مانند Claude در برابر Grok یا GPT در برابر Gemini) را نشان میدهند، انتخابها را هدایت کرد.
این فرآیند منجر به رتبهبندی ویژگیها شد. در حالی که اکثر مقایسهها بر سر ترتیب قدرت ویژگیها توافق داشتند، برخی موارد متناقض بود. این روابط در یک گراف بصری شده است که در آن فلشهای سیاه نشاندهنده توافق کامل، فلشهای آبی نشاندهنده اکثریت (حداقل دو توافق در برابر یک اختلاف) و فلشهای قرمز نشاندهنده اختلاف نظر شدید است. همچنین به هر ویژگی یک مقدار اطلاعاتی بر حسب «بیت» اختصاص یافته که نشان میدهد آن ویژگی بهطور متوسط چقدر در تفکیک دو کلاس کمک میکند.
جزئیات ویژگیهای تحلیلشده
برای درک بهتر این ویژگیها، توسعهدهنده قطعهای از سخنرانی دونالد ترامپ («بازارها در بالاترین نقطه خود در سالهای اخیر هستند اما میتوانیم بگوییم در تمام دوران») را با متنی از مجله اکونومیست («کشورهای عضو OECD که در هر دوره از PISA شرکت کردهاند به اوجی در حدود...») مقایسه کرد:
- n-gramهای برچسب POS (wink, upos, ptb): اینها کلمات را به نقشهای دستوری تبدیل میکنند (مثلاً NNS برای اسمهای جمع و NNP برای اسمهای خاص). این یک سیگنال قدرتمند است چون ساختار عبارت را بدون درگیر شدن با انتخاب کلمات ثبت میکند. مثلاً متن ترامپ اسمهای جمع (NNS) بیشتری داشت، در حالی که اکونومیست بر اسمهای خاص (NNP) و تعیینکنندهها (DT) متکی بود. برای سازگاری با مرورگر، از موتور
wink-nlpاستفاده شده است. - n-gramهای کاراکتری (char2gram, char3gram): شمارش توالی کاراکترها برای شناسایی سبک نقطهگذاری و تمایلات در انتخاب کلمات. در مثالها، ترامپ کلمات را بیشتر با «a» شروع میکرد (بر اساس bigram فضای خالی و سپس a)، در حالی که اکونومیست کلمات را بیشتر با «n» به پایان میبرد.
- فرکانس کلمات توصیفی (Function Words): ردیابی کلمات بدون محتوا مثل «the»، «in» و «all». نسخههای
word2gramوword3gramاینها را به صورت دو-تایی و سه-تایی تحلیل میکنند. مدلword2gram_adjفقط کلماتی را میشمارد که دقیقاً در کنار هم قرار دارند. در مثال ترامپ توالیهایی مثل «are at» و «at their» و در اکونومیست «that have» و «part in» دیده شد. - فرکانس خام کلمات (wordfreq_raw): شناسایی کلمات خاصی که یک منبع ترجیح میدهد (مثلاً کلمه «mediated»). اگرچه این روش بهدلیل احتمال نشت موضوعی خطرناک است (مثلاً کلمه «oecd» نشانه اکونومیست یا «actually» نشانه ترامپ باشد)، اما استفاده از یک مجموعه داده متوازن این اثر را کاهش میدهد.
- توزیع طول کلمات (wordlen, bigwords): ویژگی
bigwordsکسر کلماتی با بیش از ۵ حرف را ردیابی میکند (ترامپ: ۱۸٪، اکونومیست: ۲۹٪). ویژگیwordlenتوزیع کامل را ثبت میکند. ترامپ ۳۰٪ کلمات سه حرفی و ۲۴٪ کلمات دو حرفی داشت؛ اما اکونومیست توزیع گستردهتری داشت و ۳۵٪ کلماتش چهار حرفی بودند. - رتبه فرکانسی (freqrank): کلمات بر اساس رایج بودن با اعداد جایگزین میشوند (۰ برای رایجترین، ۱ برای ۱۰ مورد بعدی، ۲ برای صد مورد بعدی). ترامپ بیشتر از کلمات رتبه ۲ (۵۰٪) و رتبه ۳ (۳۰٪) استفاده کرد. اکونومیست از کلمات رتبه ۳ و ۴ بیشتر بهره برد که نشاندهنده دایره لغات پیچیدهتر است.
چالشهای جمعآوری داده
ساخت مجموعه داده گرانترین و دشوارترین بخش پروژه بود. توسعهدهنده اشاره کرد که اگرچه طبق برنامه ایدهآل، هزینه رسیدن به نقطه بازده نزولی ۳۰ دلار بود، اما فرآیند واقعی بسیار پرهزینهتر شد. دادهها را سه بار از ابتدا جمع کرد چون مجموعههای اولیه «آشغال» (Junk) تشخیص داده شدند.
برای ساخت مجموعه آموزشی، از این خط لوله (Pipeline) استفاده شد:
۱. شناسایی مخازن با لایسنسهای باز یا Copy-left.
۲. دریافت آخرین کامیت مربوط به سال ۲۰۲۱.
۳. استخراج تصادفی فایلهای حاوی کامنتهای انسانی.
۴. حذف تمام کامنتهای موجود از آن فایلها.
۵. درخواست از مدلهای زبانی برای تولید کامنتهای جدید برای همان فایلها.
هدف این بود که تعداد توکنها بین انسان و مدلهای LLM متوازن باشد تا از نشت موضوعی جلوگیری شود. چندین تله در این مسیر شناسایی شد:
- عدم تطابق منبع: انتخاب تصادفی فایلهای متفاوت برای هر LLM باعث نشت داده شد.
- فایلهای کمتراکم: تولید کامنتهای AI برای فایلهایی که کامنت انسانی کمی داشتند، باعث ایجاد نشت سدی (Barrier Leakage) شد.
- آلودگی Docstring: عدم حذف Docstringها باعث شد LLMها سبک مخزن را تقلید کنند، هرچند اثرش کمتر از حد انتظار بود.
- شکافهای سینتکسی: عدم شناسایی تمام انواع سینتکسهای کامنت باعث باقی ماندن متون آلوده و سختتر شدن جمعآوری داده شد.
- نویز فرمهای کوتاه: گنجاندن کامنتهای انسانی بسیار کوتاه (مثل «main task structure» یا «Alias») باعث شد مدل یاد بگیرد انسانها «افتضاح مینویسند». چون به LLMها دستور داده شده بود مفصل بنویسند، توسعهدهنده در نهایت فقط کامنتهای انسانی مفصل را فیلتر کرد.
- صلبیت پرامپت: استفاده از یک پرامپت ثابت برای تولیدات LLM باعث شد تنوع متون کمتر از حد مطلوب باشد.
تفکیک مدلهای مختلف
این طبقهبندیکننده برای تفکیک ۷ منبع آموزش دیده است: انسان، GPT 5.6، Gemini 3.7، Claude 5، Kimi K2.7، Grok 4.6 و GLM 5.2.
در حین آموزش مشخص شد سبکهای Kimi K2.7 و GLM با تقریباً تمام مدلهای دیگر همپوشانی دارند که احتمالاً بهدلیل distillation (تقطیر یا یادگیری از مدلهای بزرگتر) رخ داده است. این موضوع باعث شد قضاوت مدل بین این دو مدل «پخش» (Smeared) شود. برای رفع این مشکل، سیستم در زمان طبقهبندی، جرم احتمالات را بازتوزیع میکند: Kimi K2.7 جرم خود را عمدتاً به Grok و Claude میبخشد، در حالی که GLM آن را بهطور مساوی بین تمام مدلها پخش میکند.
در مرحله نهایی، جرم احتمالات دوباره نرمالسازی میشود تا بهجای نسبت ۱ به ۷ (که در آموزش بود)، یک نسبت ۵۰/۵۰ برای انسان/ربات شبیهسازی شود. این رویکرد ۷-گانه بهجای یک طبقهبندی ساده ۲-گانه انتخاب شد تا هم جزئیات مدلهای LLM در رابط کاربری نمایش داده شود و هم سطح چندبعدی جداکننده متن انسانی و رباتیک بهتر ثبت شود.
پیادهسازی فنی و محدودیتها
برای دسترسی آسان، مدل در یک صفحه وب قرار گرفت. این کار نیاز به بهینهسازی شدیدی داشت تا حجم مدل از چندین مگابایت به ۳۵۵ کیلوبایت کاهش یابد. این هدف از طریق روشهای زیر محقق شد:
- کوانتایزیشن ضرایب (Coefficient Quantization): کاهش دقت وزنهای مدل.
- فیلتر واژگانی: استفاده از فیلتر فرکانس سند برای حذف مقادیر ویژگیهایی که در کمتر از ۰.۰۵٪ کامنتها وجود داشتند (نقطه زانو در منحنی دقت).
از آنجا که ابزار در مرورگر اجرا میشود، از موتور wink-nlp برای برچسبگذاری نقش کلمات استفاده میکند. در حالی که موتورهای پایتونی مثل spaCy یا nltk قدرتمندتر هستند، wink-nlp اجازه میدهد تمام فرآیند طبقهبندی بهصورت محلی روی دستگاه کاربر انجام شود و هیچ کدی از مرورگر خارج نشود. برای حفظ سازگاری، توسعهدهنده در پایتون نیز از wink-nlp استفاده کرد، هرچند این کار مستلزم فراخوانی یک فرآیند Node.js بود.
تحلیل: تغییر در شناسایی هوش مصنوعی
این پروژه نشاندهنده یک تغییر حیاتی در جنگ تسلیحاتی «انسان در برابر هوش مصنوعی» است. ما در حال حرکت از جستجوی «کلمات خاص AI» به سمت تحلیل توزیع آماری ساختارهای دستوری هستیم. این واقعیت که دادههای واقعی راحتتر از دادههای سنتتیک طبقهبندی شدند، نشان میدهد که LLMها هنوز هنگام تولید مستندات فنی، یک «سختی» (Stiffness) متمایز و قابل شناسایی دارند.
برای توسعهدهندگان و مدیران، این یعنی «آلودگیهای AI» (AI Slop) در مخازن کد راحتتر قابل حسابرسی هستند. در همین راستا، ابزارهایی مانند MonkeyCode با ارائه توکنهای رایگان سعی دارند هزینه بازبینی خودکار کد را کاهش دهند تا نظارت بر کیفیت در مقیاس بزرگ ممکن شود. با این حال، هرچه مدلها بیشتر از یکدیگر تقطیر شوند — همانطور که در همپوشانی Kimi و GLM دیدیم — اثر انگشتهای منحصربهفرد خانوادههای مدل شروع به محو شدن میکنند.
اگر مدیریت یک پروژه متنباز بزرگ را بر عهده دارید، میتوانید پیادهسازی حسابرسیهای مشابه مبتنی بر POS-tagging را برای حفظ کیفیت مستندات و اطمینان از اینکه تخصص انسانی موتور اصلی منطق داخلی کد شماست، در نظر بگیرید.
- اگر مدیر پروژه هستید، از ابزارهای تحلیل ساختاری برای بررسی کیفیت مستندات کدتان استفاده کنید.
- در هنگام استفاده از هوش مصنوعی برای کامنتنویسی، از مدلهای مختلف برای ایجاد تنوع در ساختار زبانی بهره ببرید.
- مراقب «سختی» (Stiffness) متون تولیدشده توسط AI باشید؛ هرچه متن رسمیتر و ساختارمندتر باشد، احتمال شناسایی آن توسط این ابزارها بیشتر است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو