
تصور کنید یک برنامهنویس است، که عامل هوش مصنوعیاش در ابتدای پروژه بسیار تیز و دقیق است، اما پس از ۴۰ دور گفتگو، ناگهان شروع به ارتکاب اشتباهات ابتدایی میکند. این اتفاق بهدلیل پر شدن حافظه نیست، بلکه بهخاطر «غرق شدن» مدل در دادههای بیربط است.
طبق گزارش فنی منتشر شده در ۴ سپتامبر ۲۰۲۶ در وبسایت dev.to، عاملهای هوش مصنوعی با وجود گسترش پنجرههای متنی، با کاهش نسبت توکنهای مرتبط به بیربط مواجهاند. این وضعیت باعث میشود کیفیت عامل حتی زمانی که پنجرهٔ زمینه هنوز فضای خالی دارد، بهشدت سقوط کند.
بسیاری از توسعهدهندگان با پنجرهٔ زمینه (Context Window) — مثل میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه — بهعنوان یک ظرف واحد برخورد میکنند. این رویکرد منجر به یک شکست زنجیرهای میشود: هر توکنی که در دور سوم اضافه میشود، در دور چهلم دوباره ارسال میشود. مدل دادههای اولیه را فراموش نمیکند، اما توانایی اولویتبندی وظیفه فعلی بر خروجیهای ابزارهای قدیمی که شاید مربوط به یک ساعت پیش باشد را از دست میدهد. اگر به یک عامل، یک جلسه تازه و یک وظیفه واحد بدهید، بسیار تیز عمل میکند. اما اگر اجازه دهید همان جلسه برای ۴۰ دور ادامه یابد، کیفیت کار روی مواردی که قبلاً بهخوبی مدیریت میکرد، فرو میپاشد.
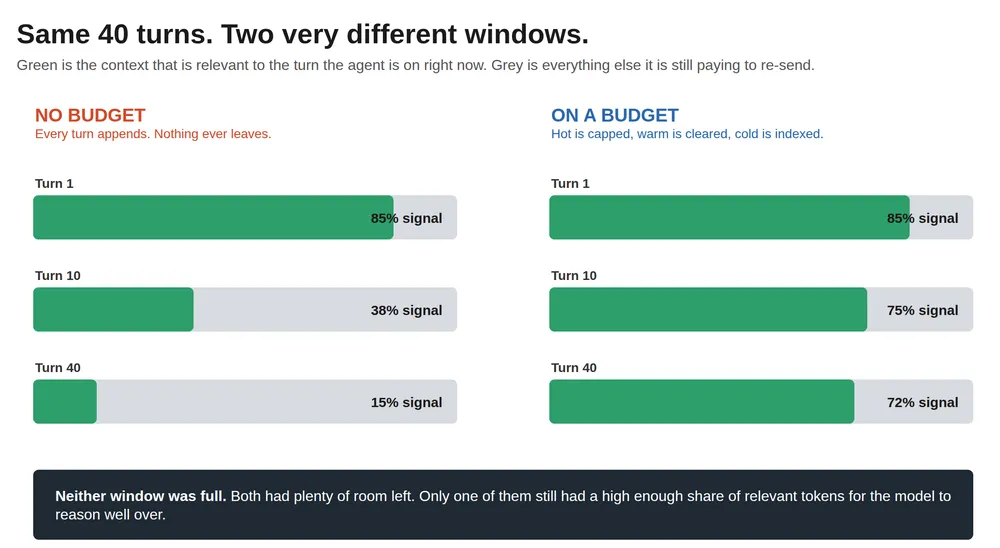
این ناکارآمدی دو هزینه مستقیم دارد. اول، کیفیت افت میکند چون توجه (Attention) محدود مدل روی دادههای بیربط تلف میشود. دوم، هزینهها بالا میرود چون سیستم در هر دور، کل تاریخچه را صورتحساب میکند. برای مثال، گفتگویی با ۲۰۰ هزار توکن که ۴۰ دور دیگر ادامه یابد، آن ۲۰۰ هزار توکن را ۴۰ بار دیگر محاسبه میکند. این موضوع دقیقاً همان نقطهای است که بودجهبندی در سطح اجرا میتواند از صورتحسابهای پیشبینینشده و سنگین AI جلوگیری کند. اگرچه کش کردن پرامپت (Prompt Caching) هزینه را کم میکند، اما مشکل بنیادینِ مربوط به ارتباط دادهها را حل نمیکند.
همانطور که در تحلیلهای قبلی ما دربارهی مدیریت حافظه در مدلهای زبانی اشاره کردیم، کلید حل این مشکل در تغییر معماری ذخیرهسازی است، نه صرفاً افزایش اندازه پنجره.
سازوکار بودجهبندی سهلایه
برای حل این بحران، نویسنده پیشنهاد میکند با پنجرهٔ زمینه بهعنوان یک بودجه برخورد شود که بر اساس «تکرار استفاده» تقسیم شده است، نه بر اساس «اهمیت». این ساختار تضمین میکند که فقط حیاتیترین دادهها در گرانترین بخش حافظه (بیشترین تکرار ارسال) قرار گیرند. این لایهها بر اساس تعداد دفعاتی که هر یک دوباره ارسال میشوند، رتبهبندی شدهاند.
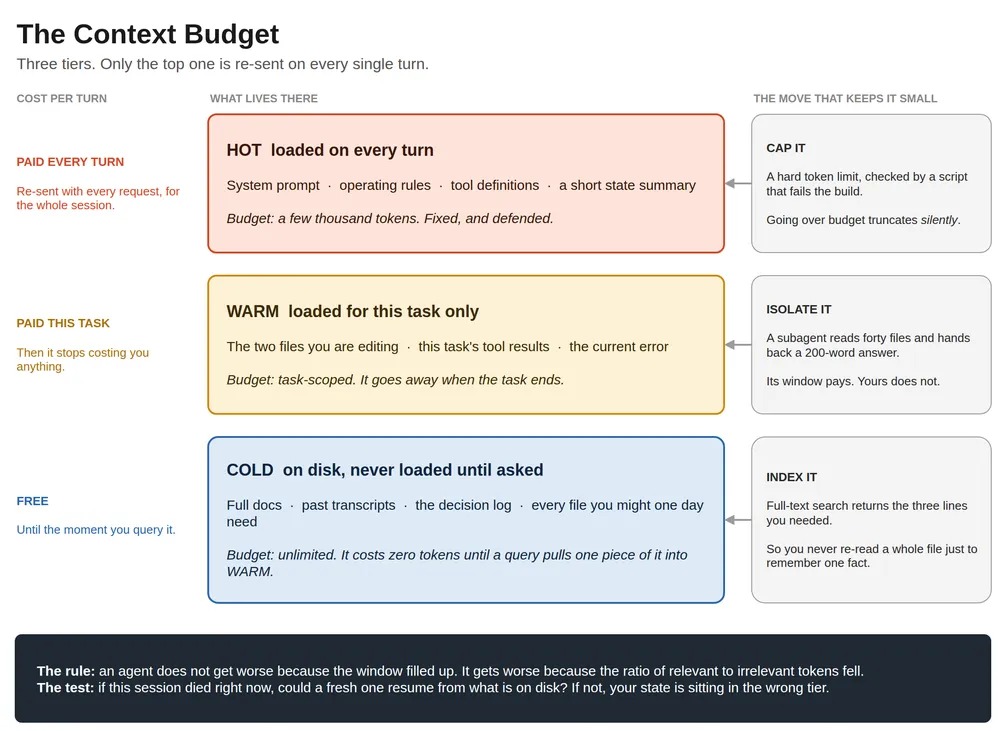
- لایه داغ (Hot Layer): شامل دادههایی است که در هر دور گفتگو ارسال میشوند، مانند پرامپت سیستمی (System Prompt). حتی اگر پرامپت صرفاً شامل متون کلیشهای و خستهکننده باشد، باز هم متعلق به این لایه است چون هر دور گفتگو را شکل میدهد. این لایه باید یک سقف توکن سختگیرانه داشته باشد که توسط کد اعمال شود تا از قطع شدن ناگهانی و بیصدا (Silent Truncation) متن جلوگیری شود.
- لایه گرم (Warm Layer): این لایه بهطور خاص برای وظیفه فعلی که در مقابل عامل قرار دارد، تعریف میشود. دادههای این لایه بهطور موقت بارگذاری شده و به محض اتمام تسک، دور ریخته میشوند.
- لایه سرد (Cold Layer): این لایه روی دیسک (مثلاً در یک پایگاهداده) قرار دارد و تا زمانی که عامل صراحتاً آن را فراخوانی نکند، هیچ هزینهای ندارد. برای مثال، یک لاگ تصمیمات ممکن است ارزشمندترین متنی باشد که مالکیتش را دارید، اما چون شاید فقط دو خط از آن را در هفته یکبار نیاز داشته باشید، باید در لایه سرد قرار گیرد.
قانون اول: اعمال سقف برای لایه داغ
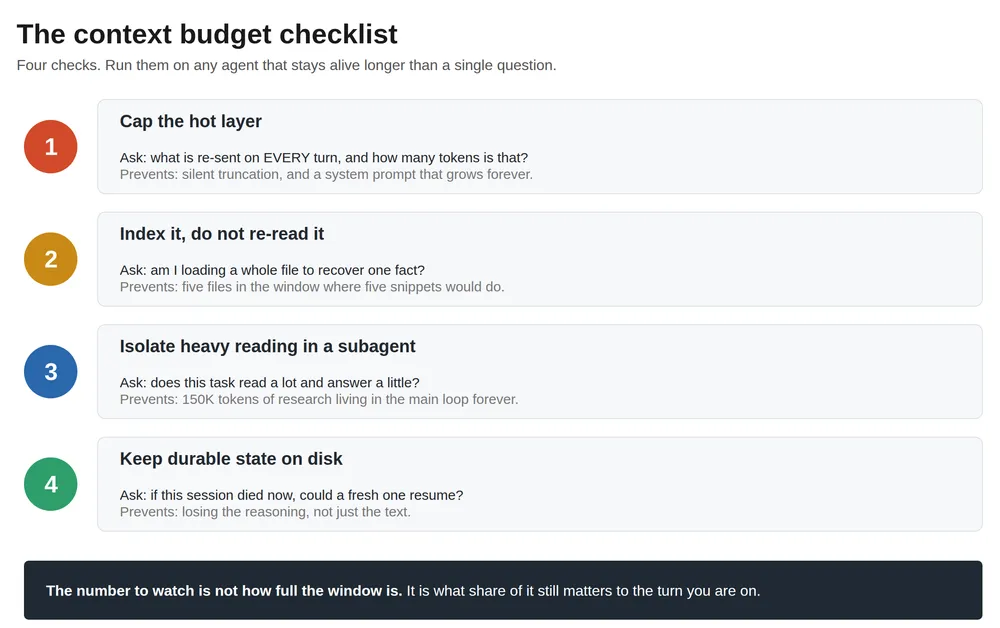
اضافه کردن یک قانون جدید به پرامپت سیستمی در لحظه رایگان به نظر میرسد، اما این کار لایه داغ را هر هفته حجیمتر میکند. نویسنده توصیه میکند بهجای ابزارهای عمومی مانند tiktoken، از توکنساز (Tokenizer) واقعی مدل — مثلاً برای Claude-Opus-5 — استفاده کنید.
استفاده از توکنساز اشتباه منجر به شمارش غلط میشود، بهویژه در کدهای برنامهنویسی. برای نمونه، توکنساز معرفی شده در Claude 4.7 در متون مشابه، میتواند تا یکسوم توکنهای بیشتری نسبت به نسخههای قدیمی تولید کند. بنابراین بودجهای که ۶ ماه پیش محاسبه کردهاید، امروز احتمالاً غلط است. شما باید شمارش را بر اساس شناسه (ID) مدلی انجام دهید که واقعاً در محیط عملیاتی منتشر میکنید.
برای اجرای این مورد، نویسنده پیشنهاد میکند اسکریپتی در CI (یکپارچهسازی مداوم) با استفاده از کلاینت Anthropic نوشت تا مقدار HOT_BUDGET (مثلاً ۴۰۰۰ توکن) را چک کند. اگر فایل AGENT.md از این حد فراتر رفت، اسکریپت باید خطای SystemExit صادر کند. این کار از «برش خاموش» جلوگیری میکند؛ وضعیتی که در آن یک سیستم مدیریت متن، هر چیزی را که از سقف کاراکترهای سختگیرانه فراتر رود بدون هیچ اخطاری حذف میکند و شما بدون اینکه بدانید، انتهای زمینه (Context) خود را از دست میدهید.
قانون دوم: بازیابی بهجای بازخوانی کامل
بارگذاری کل یک فایل برای یافتن یک حقیقت واحد، اتلاف بودجه است. پیشنهاد میشود از SQLite و موتور جستوجوی متنی داخلی FTS5 برای بازیابی بر اساس کلمات کلیدی استفاده شود. این روش تنها از کتابخانههای استاندارد استفاده میکند و نیازی به پایگاهداده برداری (Vector Database)، پرداخت هزینه برای بردار معنایی (Embedding) یا نگه داشتن یک سرویس خارجی فعال ندارد.
جزئیات پیادهسازی FTS5:
- راهاندازی: ایجاد یک جدول مجازی با استفاده از
fts5(path, body). - اندکسگذاری: استفاده از
pathlib.Path("docs").rglob("*.md")برای خواندن و درج فایلهای مارکداون در پایگاهداده. - پرسوجو: استفاده از تابع
snippet()برای بازگرداندن تنها خطوط مرتبط (مثلاً ۲۰ توکن اطراف کلمه مورد نظر) بهجای کل فایل. - عملکرد: یک اندکس FTS5 روی چند هزار فایل، در حد چند ده میلیثانیه پاسخ میدهد و این سرعت برای پرسوجو در میانه یک دور گفتگو کاملاً کافی است.
تنها زمانی به سراغ بردار معنایی (Embeddings) بروید که واقعاً به بازیابی مفهومی نیاز دارید. برای سوالاتی که ساختاری شبیه به «درباره X چه تصمیمی گرفتم؟» دارند، جستوجوی کلمات کلیدی کافی و بهینهتر است.
قانون سوم: جداسازی خواندنهای سنگین توسط زیر-عاملها
وقتی تسکی نیاز به خواندن حجم عظیمی از داده برای تولید یک پاسخ کوتاه دارد، باید از یک زیر-عامل (Subagent) استفاده کرد. زیر-عامل خواندن سنگین را در پنجرهٔ زمینه خودش انجام میدهد و فقط یک نتیجهگیری موجز را به حلقه اصلی برمیگرداند.
این عدم تقارن، کلید بهرهوری است. خواندن ۴۰ فایل ممکن است صدها هزار توکن هزینه داشته باشد، اما پاسخ نهایی اغلب تنها ۲۰۰ کلمه است. با تعریف یک قرارداد سختگیرانه برای بازگشت داده، حلقه اصلی فقط هزینه آن ۲۰۰ کلمه را میپردازد. در همین راستا، رویکرد نمایشهای ساختاریافته گوگل توانسته است مصرف توکن در جلسات طولانی را تا ۹۴٪ کاهش دهد که نشاندهنده اهمیت بهینهسازی ساختار دادههای ارسالی است.
قرارداد زیر-عامل:
- محدودیت: بازگرداندن حداکثر ۲۰۰ کلمه.
- الزام: ارائه پاسخ بههمراه ارجاع دقیق به
file:lineکه پاسخ را پشتیبانی میکند. - ممنوعیت: عدم کپی کردن محتوای فایل در پاسخ.
- وضعیت شکست: اگر پاسخ در مخزن (Repo) نبود، زیر-عامل باید دقیقاً عبارت
blocked: <what you need>را ارسال کند.
این قرارداد صریح از «حدسهای مطمئن» جلوگیری میکند؛ حدسهایی که هزینه خطاهای پاییندستیشان بسیار بیشتر از توکنهای ذخیرهشده است.
برای کاربران API Anthropic، نسخه بتای context-management-2025-06-27 امکان ویرایش سمت سرور را فراهم میکند. این قابلیت اجازه میدهد خروجیهای قدیمی ابزارها را با استراتژی clear_tool_uses_20250919 یا بلوکهای تفکر را از طریق clear_thinking_20251015 پاک کنید. این روش بسیار بهتر از خلاصهسازی است چون صرفاً خروجیهای منسوخ ابزارها را که هیچکس دوباره نخواهد خواند، حذف میکند.
قانون چهارم: وضعیت پایدار روی دیسک
هر چیزی که باید پس از پایان یک جلسه باقی بماند، باید در فایل باشد، نه در گفتگو. گفتگو تنها لایه ذخیرهسازی است که تضمین شده ناپدید میشود. معیار تشخیص ساده است: اگر جلسه در میانه کار قطع شود، آیا یک جلسه جدید میتواند از روی دادههای موجود روی دیسک، کار را ادامه دهد؟
ساختار پیشنهادی برای وضعیت (State):
- ACTIVE.md: کارهای فعلی عامل و گام بعدیِ ملموس. این تنها فایلی است که در لایه داغ قرار میگیرد.
- DECISIONS.md: تصمیمات گرفته شده و استدلالهای پشت آنها. استدلالها بخش گرانقیمت دادهها هستند و اغلب از روی کد قابل بازیابی نیستند.
- LESSONS.md: چه چیزی خراب شد و چه قانونی برای جلوگیری از تکرار آن وضع شد. درسی که یکبار نوشته شود، به قانونی تبدیل میشود که حمل آن برای همیشه تقریباً هیچ هزینهای ندارد.
- notes.db: اندکس FTS5 برای تمام موارد بالا (لایه سرد).
نقش کش کردن پرامپت
کش کردن باعث میشود ارسال پیشوندهای طولانی ارزانتر شود، اما ارتباط دادهها را بهبود نمیبخشد. برای بیشترین بهرهوری، توسعهدهندگان باید محتوای ثابت (پرامپتهای سیستمی منجمد، لیست ابزارها با ترتیب قطعی) را در ابتدا و محتوای متغیر (برچسبهای زمانی، شناسههای درخواست، سوالات متغیر) را در انتها قرار دهند.
اگر پرامپت سیستمی با یک فراخوانی datetime.now() در ابتدا شروع شود، کل کش در هر درخواست باطل میشود. این موضوع را میتوانید با چک کردن usage.cache_read_input_tokens در ترافیک واقعی بررسی کنید؛ اگر مقدار آن صفر است، احتمالاً یک برچسب زمانی مقصر است. علاوه بر این، توجه داشته باشید که حداقل پیشوند قابل کش کردن به مدل بستگی دارد؛ اگر پرامپت بیش از حد کوتاه باشد، بهطور بیصدا هرگز کش نمیشود.
بودجهبندی باید اولویت اول باشد؛ کش کردن صرفاً راهی برای بهینهسازی چیزی است که از فیلتر بودجه عبور کرده است. یک توکن بیربطِ کششده، همچنان یک توکن بیربط در پنجرهٔ زمینه است.
این تغییر رویکرد، توسعه عاملهای هوش مصنوعی را از «مهندسی پرامپت» به سمت «معماری حافظه» میبرد. هدف این است که وضعیت عامل پایدار و توجه آن متمرکز باشد.
برای شروع بهبود عامل خود در این هفته، قانونی را انتخاب کنید که عامل شما بدترین تخطی را در آن دارد و فقط همان یک مورد را اصلاح کنید. برای اکثر کاربران، این قانون اول است: اندازه دادههایی که در هر دور گفتگو دوباره ارسال میکنید را اندازهگیری کنید. احتمالاً متوجه خواهید شد که «حماقت» عامل شما پس از یک جلسه طولانی، صرفاً نتیجهی یک لایه داغ حجیم و متورم است.
گام بعدی شما
- اندازه دادههایی که در هر دور گفتگو دوباره ارسال میکنید را اندازهگیری کنید تا حجم لایه داغ را بشناسید.
- برای دادههای حجیم، بهجای بارگذاری کامل فایل، یک دیتابیس ساده SQLite با FTS5 راهاندازی کنید.
- یک فایل
DECISIONS.mdایجاد کنید تا استدلالهای مدل را از حافظه موقت به دیسک منتقل کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو