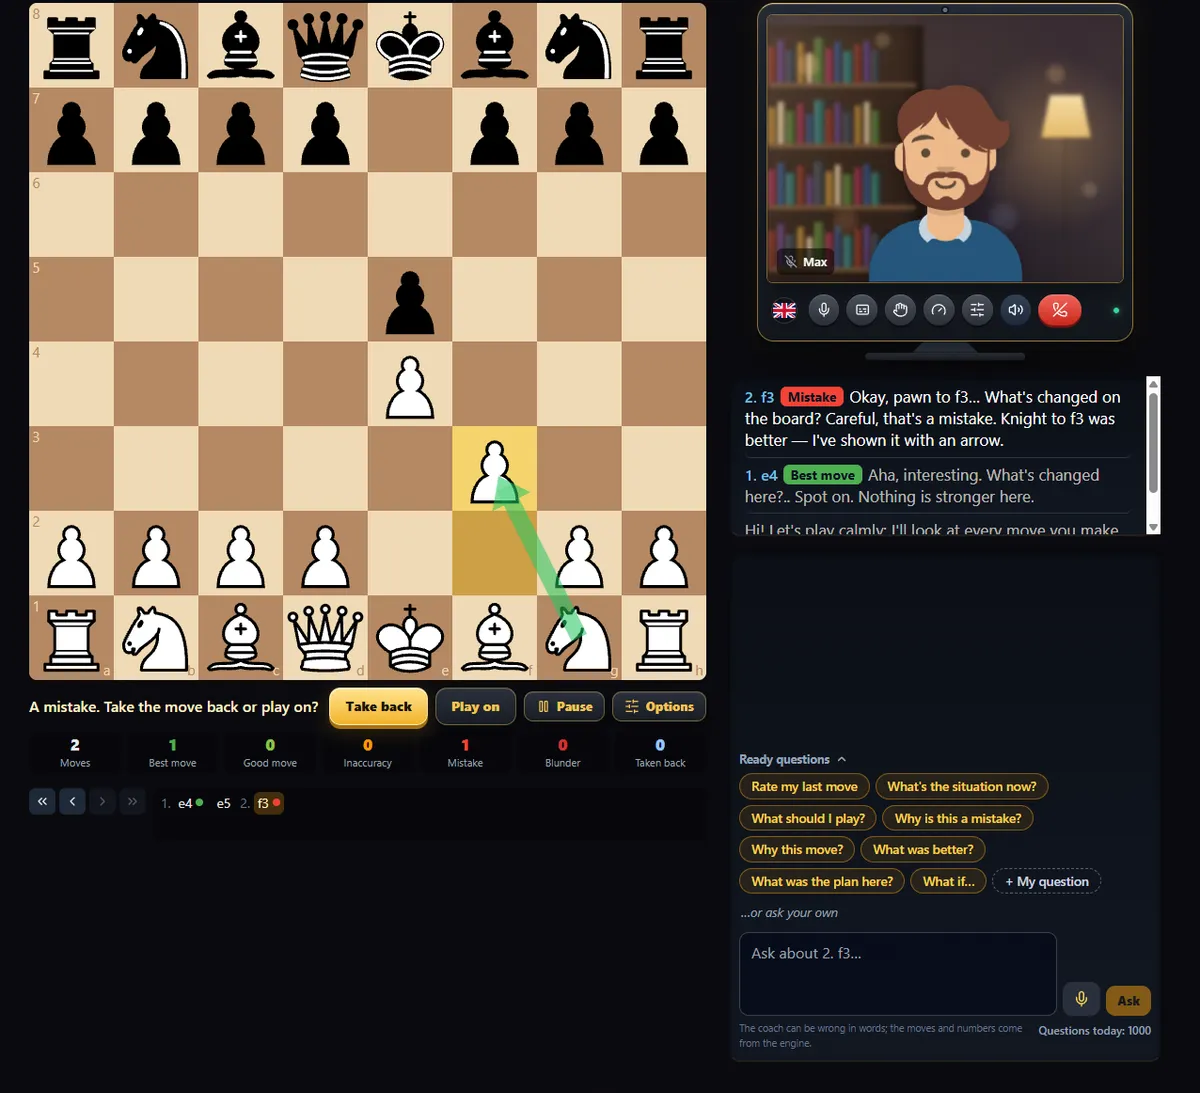
تصور کنید مربی شطرنج شما با اطمینان کامل حرکتی را پیشنهاد دهد که طبق قوانین بازی غیرممکن است؛ این کابوس همیشگی مدلهای زبانی در درک فضای صفحه شطرنج بود. اما یک پروژه جدید که در ۸ اکتبر ۲۰۲۶ منتشر شد، با ایجاد یک خط لوله «ابتدا محاسبه، سپس توضیح»، این مشکل را بهطور کامل حل کرده است. این سیستم با جداسازی منطق موتور شطرنج از زبان مدل زبانی بزرگ (LLM)، تضمین میکند که هرگز حرکتی غیرقانونی پیشنهاد نشود.
بسیاری از مدلهای هوش مصنوعی در استدلال فضایی روی صفحه شطرنج ضعیف هستند. آنها اغلب جای مهرهها را فراموش میکنند، مهرههایی را حرکت میدهند که اصلاً در آن خانه نیستند، یا با اعتمادبهنفس کامل حرکاتی را توصیف میکنند که از نظر فیزیکی غیرممکن است. برای یک بازیکن آماتور با ریتینگ ۱۳۰۰، این توهمات بسیار خطرناک است؛ زیرا او ممکن است ادعایی مثل «اسب در f3 توسط فیل دفاع شده است» را در حالی که غلط است، باور کند و در نتیجه یک ایده استراتژیک اشتباه را در ذهن خود ثبت کند. این ضعف در استدلال ذاتی مدلهای زبانی است که در تحلیلهای پیشین درباره تفاوت معماری LLMها با سیستمهای جستوجوی عمیق مانند AlphaGo بررسی کردیم و نشان دادیم چرا مدلها بدون ابزار کمکی، توانایی استدلال منطقی ندارند.
همانطور که در تحلیل قبلی ما دربارهی مبنیسازی (Grounding) دادهها و نرمالسازی استنادهای هوش مصنوعی در مدلهای مختلف اشاره کردیم، این پروژه نشان میدهد که نیاز شدیدی به زمینهسازی دادهها وجود دارد. در این سیستم، بهجای اعتماد به دانش داخلی مدل، توسعهدهنده با LLM مانند یک مترجم برای دادههای سخت برخورد میکند که توسط یک موتور تخصصی ارائه شده است. قانون طلایی که هرگز تغییر نکرد این است: هر حرکت، هر خط محاسباتی و هر ارزیابی در پاسخ نهایی، مستقیماً از موتور استخراج میشود و مدل فقط وظیفه توضیح دادن آن را بر عهده دارد.
معماری فنی سامانه
این سیستم از یک پشته سه لایه تشکیل شده است: Stockfish برای محاسبات، Claude Sonnet 5 برای توضیح و ElevenLabs v4 Turbo برای تبدیل متن به گفتار. برای حفظ سرعت و روانی تجربه کاربری، استاکفیش در دو مکان مختلف اجرا میشود:
- سمت مرورگر: یک Web Worker با فناوری WASM کارهای فوری و رایگان را مدیریت میکند؛ مواردی مانند حرکات مربی هنگام بازی مقابل کاربر و قضاوت سریع حرکت بازیکن در حین بازی.
- سمت سرور: مجموعهای از سه پردازش بومی استاکفیش (هر کدام با ۶۴ مگابایت هش) پاسخ به سوالات پیچیده و تحلیلهای عمیق بازیها را بر عهده دارند.
مکانیزمهای مدیریت سرور
به گزارش توسعهدهنده، در نسخههای اولیه هر سوال یک پردازش استاکفیش جدید ایجاد میکرد. این موضوع باعث میشد در زمان ترافیک بالا (مثلاً وقتی ۱۰ سوال همزمان میرسید)، نمونههای کوچک سرور با کمبود حافظه مواجه شده و کل سایت کرش کند. اکنون با استفاده از یک استخر (Pool) سه پردازشی، این مشکل حل شده است. این چالشهای زیرساختی نمونهای از شکافهای مهندسی است که اغلب باعث شکست اپلیکیشنهای مدل زبانی در محیط عملیاتی میشود و مدیریت منابع سرور را به یک اولویت تبدیل میکند.
علاوه بر این، سیستم یک صف با مهلت ۲۰ ثانیهای و یک حافظه پنهان (Cache) از نوع LRU برای ۳۰۰۰ موقعیت پیاده کرده است؛ زیرا کاربران بهطور مداوم درباره موقعیتهای تکراری در گشایشها سوال میپرسند.
عمق جستوجو بسته به نوع وظیفه تغییر میکند: عمق ۱۴ برای تحلیل بازی (که در صورت نیاز تا عمق ۱۸ بازبینی میشود)، عمق ۱۲ برای قضاوت حرکات بازیکن و عمق ۱۴ (برای ۳ حرکت برتر) جهت پاسخ به سوالات. هنگام بازی مربی، از حالت MultiPV 6 استفاده میشود تا گزینههای بیشتری بررسی شوند.
حل مسئله توهم
دستاورد اصلی این است که بهجای ارسال موقعیت خام صفحه (رشته FEN)، «واقعیتها» به مدل داده میشوند. در نسخههای اولیه، ارسال رشتههای FEN (مثلاً r1bqkb1r/pppp1ppp/2n2n2/...) باعث میشد مدل حرکات را اختراع کند. در یک مورد، مدل ادعا کرد که حرکت 6...Nd4 اسب در f3 و فیل در e2 را مورد حمله قرار میدهد، در حالی که یک وزیر در خانه e2 قرار داشت.
اکنون سیستم یک شیء JSON حاوی دادههای پیشمحاسبه شده میفرستد. برای مثال، حرکتی مانند 14...Bxe4 با اطلاعات زیر همراه است:
- ارزیابیها به صورت کلمات: بهجای ارسال عدد «+۰.۲»، عبارت «تقریباً برابر» ارسال میشود. این کار مانع از آن میشود که مدل برنده و بازنده را جابهجا کند؛ در یکی از لاگها، مدل عبارت «+۰.۲ برای سفید» را به اشتباه «بهوضوح بهتر برای سیاه» توصیف کرده بود.
- دلایل استخراجشده از موتور: کد برنامه، مسیر اصلی (Principal Variation) موتور را بررسی میکند تا مواردی مثل مات، ماتهای از دست رفته، باخت مهره، دوشاخه یا پین را شناسایی کند. برای حرکت
14...Bxe4دلیل ارائه شده این است: «بعد از Bxe4، پاسخ Nxe4 فیل را میگیرد زیرا راه عقبنشینی ندارد». - برچسبهای زمینهای: سیستم از
habit_tagsمانندhanging_piece(مهره رها شده) استفاده میکند تا مدل بتواند نوع خطا را دستهبندی کند.
ابزار تحلیل و لایه اعتبارسنجی
وقتی کاربر میپرسد «اگر با رخ بزنم چه میشود؟»، مدل از ابزاری به نام analyze استفاده میکند. این ابزار به مدل اجازه میدهد نقطه شروع («قبل» یا «بعد»)، آرایهای از حرکات و یک برچسب را مشخص کند.
سرور این حرکات را روی یک صفحه واقعی (تا ۱۲ لایه یا ply) اجرا کرده، استاکفیش را اجرا میکند و ارزیابی، بهترین خط ۶ لایهای و اینکه آخرین حرکت چه چیزی را مورد حمله قرار داده، برمیگرداند. اگر حرکتی غیرقانونی باشد، ابزار خطایی با این دستور سختگیرانه برمیگرداند: «حدس نزن چرا؛ فقط بگو که این حرکت در اینجا ممکن نیست». این کار مانع از آن میشود که مربی با اعتمادبهنفس توضیح دهد یک حرکت قانونی غیرقانونی است، صرفاً چون مدل به موقعیت اشتباهی رجوع کرده است. این رویکرد در واقع تکاملیافتهی همان متدی است که Claude Code برای خودکارسازی تحلیلهای پس از بازی با ادغام استاکفیش به کار گرفت تا دقت تحلیلها را تضمین کند.
حتی با وجود دادههای واقعی، مدل گاهی حرکات را اختراع میکند. توسعهدهنده یک لایه اعتبارسنجی سختگیرانه پیاده کرد که تمام پاسخها را برای یافتن حرکاتی که در مجموعه مجاز (بازی، خطوط موتور یا نتایج تحلیل) نیستند، اسکن میکند.
این بررسی از یک Regex پیچیده برای شناسایی حرکات در نمادهای مختلف استفاده میکند. توسعهدهنده متوجه شد مدل یک بار یک خط کامل اختراعی را با استفاده از نمادهای شطرنج روسی (مثل Фxg5) از فیلتر انگلیسی عبور داده است. اکنون Regex بهروز شده و حروف مهرههای روسی (Кр, Ф, Л, С, К) را نیز پوشش میدهد.
چهار بررسی خاص انجام میشود:
۱. حرکات اختراعی.
۲. خطوط شمارهگذاری شدهای که با هیچ خط شناختهشدهای مطابقت ندارند.
۳. ادعاهای کلامی (مثلاً «فیل در c4 به f7 میزند») که با وضعیت صفحه چک میشوند.
۴. حرکاتی که به صورت کلمات در ۸ زبان مختلف نام برده شدهاند.
اگر تخلفی پیدا شود، کلاینت یک «رویداد پس گرفتن» (retract event) دریافت میکند تا متن در حال استریم را پاک کند. سپس به مدل دقیقاً گفته میشود کدام حرکات اختراعی بودهاند و از او خواسته میشود از ابزار analyze استفاده کند یا آنها را حذف کند. سیستم تنها یک بار اجازه بازسازی پاسخ را میدهد و فقط پاسخهای پاک و بدون خطا در حافظه پنهان ذخیره میشوند.
مدلهای استدلالی و محدودیت توکن
استفاده از کلود ۵ چالش جدیدی به نام توکنهای «تفکر» (Thinking Tokens) ایجاد کرد. چون این توکنها جزئی از max_tokens محسوب میشوند، محدودیت ۱۴۰۰ توکنی باعث میشد پاسخها در میانهی کلمه قطع شوند. در یک مورد، مدل ۴۵ ثانیه فکر کرد و هیچ پاسخی برنگرداند. توسعهدهنده MAX_TOKENS را به ۴۰۰۰ افزایش داد و output_config.effort را روی «low» تنظیم کرد تا سرعت حفظ شود. اکنون پاسخها از طریق SSE (متن/پس گرفتن/پایان) استریم میشوند و اولین کلمات در ۲.۵ تا ۴ ثانیه میرسند.
صدا و بومیسازی
برای لایه صوتی، مربی از ElevenLabs برای پشتیبانی از ۲۲ زبان استفاده میکند. توسعهدهنده نسخههای v4، v4 Turbo و v3 را انتخاب کرد زیرا Multilingual v2 از زبانهای بنگالی، فارسی، عبری و ویتنامی پشتیبانی نمیکرد.
- پیادهسازی صدا: برای گفتگوهای زنده از
eleven_v4_turboو برای دوره آموزشی ۳۳ درسی ازeleven_v4استفاده شده است. - کش و محدودیتها: عبارتهای کوتاه در R2 با استفاده از
sha256(voice|model|text)ذخیره میشوند. یک سمافور (Semaphore) تعداد درخواستهای همزمان را به ۵ عدد محدود میکند تا مربی در زمان ترافیک بالا در میانهی جمله ساکت نشود. - تبدیل نمادها: چون TTS عبارت «Nf3» را به صورت حروف میخواند، سیستم نمادها را به کلمات تبدیل میکند (مثلاً «اسب f3»). در روسی، «18. Qb2 Bxb5» به «ферзь бэ 2, слон берёт бэ 5» تبدیل میشود و کاماها برای ایجاد مکثهای طبیعی اضافه میشوند.
- کنترل کیفیت: توسعهدهنده اشاره کرد که در ابتدا صدای روسی کلمه «ферзь» (وزیر) را با مصوت و استرس اشتباه تلفظ میکرد که باعث کاهش اعتماد کاربران میشد.
- تبدیل گفتار به متن: این بخش بهصورت رایگان از طریق Web Speech API در مرورگرها (که در فایرفاکس مخفی است) و شناسگر سیستم در اپلیکیشن اندروید مدیریت میشود، زیرا Android WebView فاقد Web Speech API است. برای زبان تاگالوگ، بهجای
tlاز لوکالfil-PHاستفاده شد.
کشف باگهای قدیمی
جالب اینجاست که فرآیند آموزش هوش مصنوعی برای «دروغ نگفتن»، باگهای کد قدیمی خود توسعهدهنده را فاش کرد. شکستهای LLM نشان داد که سیستم تحلیل بازی یک سال است که دروغ میگوید. کد قدیمی امتیازات UCI را همیشه به عنوان امتیاز سفید میخواند، به این معنی که علامت ارزیابی در هر لایه (ply) جابهجا میشد و نیمی از نمودارهای ارزیابی سایت سر و ته بودند! علاوه بر این، امتیازات مات (Mate) بهطور کامل حذف شده بودند و زمان هر حرکت برای تمام بازیهای تاریخ سایت صفر ذخیره شده بود.
برای اصلاح این موارد، دقت هر بازی اکنون از فرمولهای Lichess و میانگین هارمونیک استفاده میکند. میانگین ساده گمراهکننده بود؛ مثلاً ۲۳ حرکت دقیق و ۳ اشتباه فاحش (Blunder) منجر به دقت ۸۳٪ میشد، حتی اگر بازی کاملاً باخته شده باشد.
تحلیل اشتباهات عادتوار
یکی از کاربردیترین ویژگیها، تحلیل غیرپر زرقوبرق اشتباهات عادتوار است. کد برنامه، سهم یک اشتباه خاص را در میان تمام اشتباهات با سهم آن نوع حرکت در میان تمام حرکات مقایسه میکند. یک حقیقت تنها زمانی به مدل میرسد که دو آستانه را رد کند: سهم حداقل ۰.۱۵ و «لیفت» (سهم تقسیم بر پایه) حداقل ۱.۳.
برای توسعهدهنده، این تحلیل فاش کرد که ۶۶٪ از اشتباهات فاحش او در حرکاتی رخ میدهد که او مهرهای را میزند، در حالی که نرخ پایه این نوع حرکات ۲۹٪ است؛ الگویی که او آن را «بزن، احساس رضایت کن، دیگر به صفحه نگاه نکن» نامید.
اسپارینگ و هزینهها
هنگام بازی با مربی، سیستم تضمین میکند که هوش مصنوعی بیدقت نباشد. استاکفیش ۶ حرکت برتر را محاسبه میکند (MultiPV 6) و مربی بهطور تصادفی در یک بازه خطای مشخص (۰ تا ۱۲۰ سنتپیون بسته به سطح) یکی را انتخاب میکند. از آنجا که ارزش یک مهره بیش از ۳۰۰ است، مربی هرگز مهرهای را رایگان نمیدهد. برای قضاوت بازیکن، سیستم حرکت او را با بهترین حرکت در همان جستوجوی MultiPV مقایسه میکند تا «نویزهای» کوچک (مثلاً نصف پیاده) باعث نشود حرکتی مثل 7.O-O بهاشتباه به عنوان عدم دقت (Inaccuracy) برچسب بخورد.
تفکیک هزینهها:
- مدل: کلود سونت ۵ (۲/۱۰ دلار به ازای هر ۱ میلیون توکن). هر سوال بهطور متوسط (۲.۹ هزار ورودی، ۴۰۰ خروجی) حدود ۰.۰۱ دلار هزینه دارد.
- صدا: ۱۰ دقیقه مکالمه بین ۰.۰۶ تا ۰.۲۰ دلار هزینه دارد.
- تاخیر: زمان رسیدن اولین کلمات ۲.۵ تا ۴ ثانیه است.
این معماری ثابت میکند که الگوی «موتور محاسبه میکند، مدل توضیح میدهد» تنها زمانی جواب میدهد که کد محیطی با LLM مانند یک «راوی غیرقابل اعتماد» رفتار کند. با اعمال سیاست «اعتماد صفر» نسبت به استدلال فضایی مدل، توسعهدهنده مربیای ساخته است که هم انسانی است و هم از نظر ریاضی دقیق.
برای مشاهده این سیستم در عمل، میتوانید به democraticchess.com مراجعه کنید و ببینید هوش مصنوعی مبنیسازی شده چگونه توضیحات استراتژیک پیچیده را مدیریت میکند.
گام بعدی شما
- اگر در حال ساخت عاملهای هوش مصنوعی هستید، هرگز اجازه ندهید مدل روی دادههای ساختاری (مثل مختصات) استدلال کند؛ داده را در بیرون پردازش و نتیجه را برای توضیح به مدل بدهید.
- برای کاهش هزینه استنتاج، از حافظه پنهان (Cache) برای ورودیهای تکراری استفاده کنید.
- لایههای اعتبارسنجی خروجی (Validation Layer) را برای جلوگیری از توهمات در زبانهای مختلف پیاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو