تصور کنید هر پاسخ سریع یک چتبات، در واقع خروجیِ یک آسمانخراش صنعتی است که در چند سال اخیر ساخته شده است. اگر در حال توسعه یک محصول هوش مصنوعی هستید، دانستن اینکه در کدام طبقه از این ساختمان فعالیت میکنید، مستقیماً هزینه، سرعت و میزان کنترل شما را تعیین میکند.
به گزارش وبسایت dev.to در ۱۷ اکتبر ۲۰۲۶، مسیر تبدیل یک پرسش کاربر به پاسخ، از هفت لایه مجزا از فناوری و نظارت انسانی عبور میکند. این ساختار شبیه به یک کارخانه است؛ در زیرزمین ماشینآلات سنگین قرار دارند و در طبقات بالا، رابطهای صیقلخوردهای که کاربر لمس میکند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، هر لایه از این پشته، نقاط ضعف و قوت خاص خود را دارد. لایه اول، محاسبات (Compute) است که شامل واحد پردازش گرافیکی (GPU)، واحد پردازش تنسور (TPU) و مراکز داده میشود. در حال حاضر سرمایههای کلانی به این لایه سرازیر شده است، زیرا سختافزار تعیینکننده هزینه آموزش، هزینه استنتاج و تأخیر هر پرسش است. این فشار سختافزاری باعث شده تا بهینهسازی مصرف انرژی و سیستمهای خنککننده به یکی از معیارهای حیاتی در ارزیابی موتورهای هوش مصنوعی تبدیل شود.
بالای تراشهها، لایه داده قرار دارد. مدلها از ترکیبی از متن، کد، تصویر، صوت و بازخوردهای انسانی یاد میگیرند. طبق این گزارش، اولویت صنعت از «کمیت» به «کیفیت» تغییر کرده است؛ تغییری که بحثهای جدیتری را درباره مالکیت دادهها و منشأ آنها برانگیخته است.
در قلب این سیستم، مدلهای بنیادی (Foundation Models) — مثل موتور یک ماشین که تمام قدرت را تأمین میکند — قرار دارند. آموزش این مدلها به تریلیونها توکن (Token) — تکههای کوچکی از متن شبیه برشهای یک کیک که مدل تکهتکه میخورد — و هزاران تراشه متصل به هم نیاز دارد که از طریق شبکههای ارتباطی سریع با یکدیگر همکاری میکنند. به دلیل هزینههای سرسامآور، تنها آزمایشگاههای معدودی قادر به ساخت بزرگترین مدلها هستند، هرچند مدلهای متنباز فاصله را کم کردهاند. خانوادههای مشهوری مثل GPT، Claude، Gemini، Llama و Mistral در این لایه جای میگیرند و اکثر توسعهدهندگان از طریق API با آنها ارتباط میگیرند.
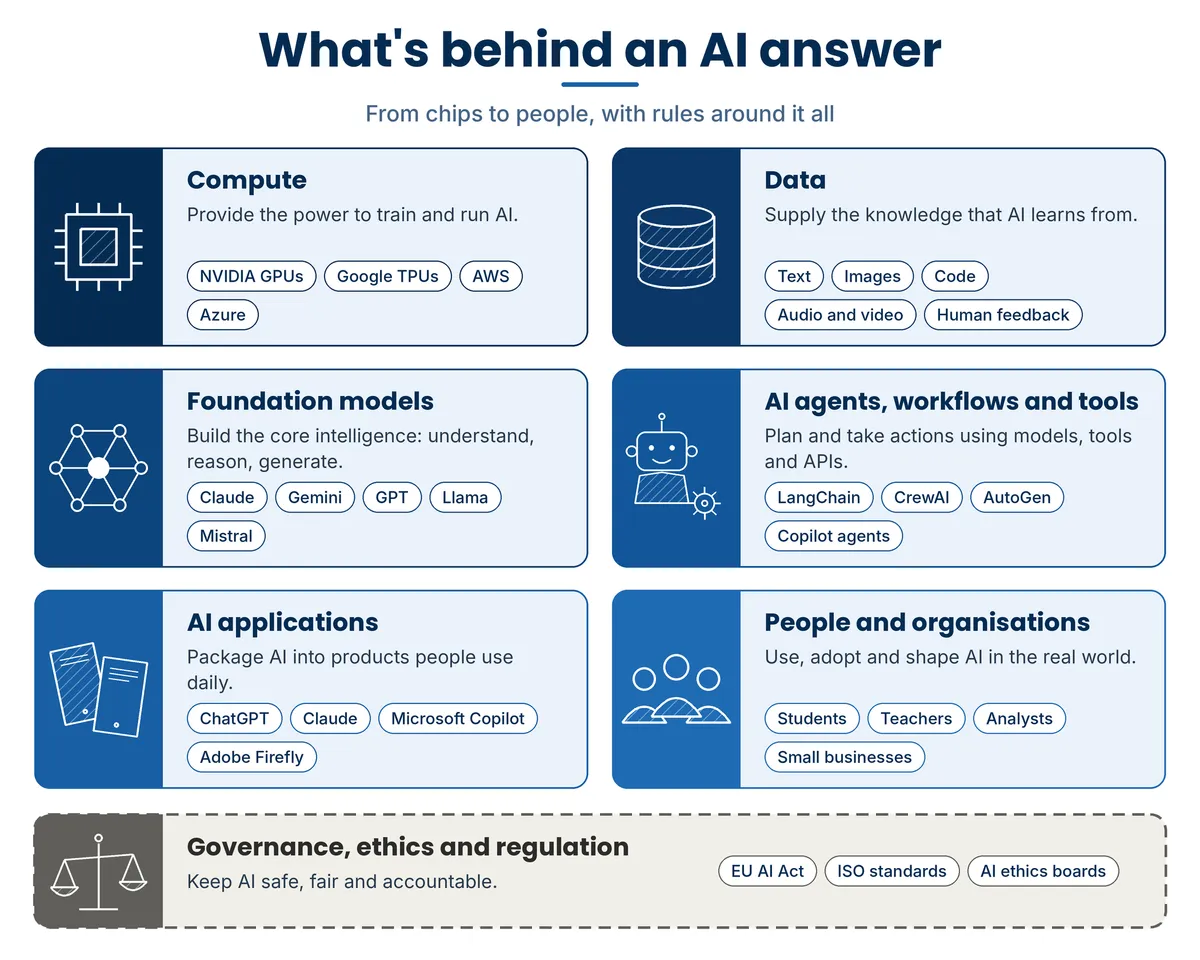
در لایه ارکستراسیون، هوش مصنوعی از تولید متن ساده به سمت «انجام کار» حرکت میکند. در اینجا سه مکانیزم حیاتی وجود دارد:
- عاملها (Agents): مدل خودش مراحل را انتخاب میکند. شما هدف را میگویید (مثلاً «علت تأخیر سفارش را پیدا کن») و مدل تصمیم میگیرد از چه ابزاری استفاده کند، نتیجه را میخواند و تا زمانی که باور کند کار تمام شده است، این چرخه را تکرار میکند. این روش برای مسائل باز و بدون ساختار قدرتمند است اما پیشبینی و تست آن سختتر است. در واقع، علیرغم پتانسیل بالا، چالشهای جدی در زمینه دیباگینگ تولید همچنان یکی از نقاط ضعف اصلی عاملهای هوشمند در محیطهای عملیاتی است.
- جریانهای کاری (Workflows): توسعهدهنده مراحل را تعریف میکند. مدل فقط جزئیات یک توالی پیشفرض را پر میکند (مثلاً: خلاصه پیام $ \rightarrow $ طبقهبندی $ \rightarrow $ پیشنویس پاسخ). این روش پیشبینیپذیر، تکرارپذیر و برای اتوماسیون کسبوکار ایدهآل است.
- ابزارها (Tools): قابلیتهای خارجی هستند که مدل برای کارهایی که با متن نمیتواند انجام دهد، فراخوانی میکند؛ مثل جستوجوی وب، اجرای کد، پرسوجو از یک پایگاه داده، ارسال ایمیل یا فراخوانی API یک سرویس دیگر. این فرآیند به فراخوانی تابع (Function Calling) معروف است. در این حالت، مدل درخواست استفاده از ابزار را میدهد، اپلیکیشن آن را اجرا میکند و نتیجه را به مدل بازمیگرداند.
در نهایت، لایه اپلیکیشنها قرار دارد؛ محصولاتی مثل کوپایلتها، دستیارهای چت یا ویژگیهای هوش مصنوعی که درون ابزارهای موجود تعبیه شدهاند. این لایه اصلی برای کسانی است که قصد عرضه یک محصول نهایی را دارند.
سپس لایه افراد و سازمانها میآید؛ جایی که ارزش واقعی مدل زمانی خلق میشود که یک برنامهنویس در محیط ویرایشگر کد، یک معلم در کلاس درس، یا شرکتی که در حال ساخت یک جریان کاری روزانه است، از آن استفاده کند. در این نقطه است که ارزش یا خلق میشود و یا از دست میرود.
آخرین لایه، حاکمیت، اخلاق و مقررات است که قوانین بازی را تعیین میکند. این قوانین بسته به منطقه جغرافیایی متفاوت است و مدام در حال بازبینی هستند. برای مثال، قانون هوش مصنوعی اتحادیه اروپا (EU AI Act) برجستهترین نمونه در این زمینه است. سازندگان باید دقیقاً بررسی کنند که کدام قوانین بر محصول خاص و کاربران آنها اعمال میشود.
برای یک توسعهدهنده، این لایهها جزیرههای جداگانه نیستند. ارائهدهندگان ابری اکنون مدلهای خود را میسازند و سازندگان مدل، اپلیکیشنها و عاملهای خود را عرضه میکنند. هر نقطه تلاقی، ترکیبات جدیدی ایجاد میکند و باعث رشد ابزارهای هوش مصنوعی میشود.
انتخاب مدل شما مستقیماً بر هزینه درخواست، سرعت پاسخ و قابلیتهایی مثل پردازش تصویر یا فراخوانی ابزارها اثر میگذارد. این تصمیمات از ابتدای مسیر تا لحظه عرضه نهایی محصول شما را دنبال میکنند.
همانطور که هوش مصنوعی بدون توقف به پیشروی سریع خود ادامه میدهد، این لایهها احتمالاً تغییر شکل خواهند داد. پرسش حیاتی برای هر سازنده این است که آیا میخواهد کد او فرمانده باشد (Workflows) یا مدل فرمانده باشد (Agents). شما در کدام لایه فعالیت میکنید؟ در نظرات برای ما بنویسید.
گام بعدی شما
- بررسی کنید که آیا محصول شما به انعطافپذیری عاملها نیاز دارد یا پیشبینیپذیری جریانهای کاری.
- هزینههای استنتاج خود را بر اساس لایه سختافزاری مورد استفاده (GPU در برابر TPU) بهینهسازی کنید.
- تطابق محصول خود را با مقررات حاکمیتی منطقهای که در آن فعالیت میکنید، بازبینی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو