تصور کنید یک استخدامکننده در برابر دو رزومه است: یکی ادعای تسلط بر ترنسفورمرها را دارد و دیگری تنها یک لینک گیتهاب با چند ستاره. تفاوت واقعی این دو نه در عناوین شغلی، بلکه در خطوط کدی است که نوشتهاند. عبارت «ترنسفورمر» ممکن است برچسب یک مخزن در گیتهاب باشد، اما یک فایل README صیقلخورده اغلب پیادهسازیهای سطحی را پنهان میکند. برای حل این مشکل، الکس، دانشجویی رومانیایی، پلتفرم AI-Atlas را توسعه داد؛ ابزاری که شواهد واقعی کد را بازرسی میکند تا تعیین کند آیا یک پروژه واقعاً اصیل، بازتولیدپذیر یا از نظر فنی عمیق است یا خیر.
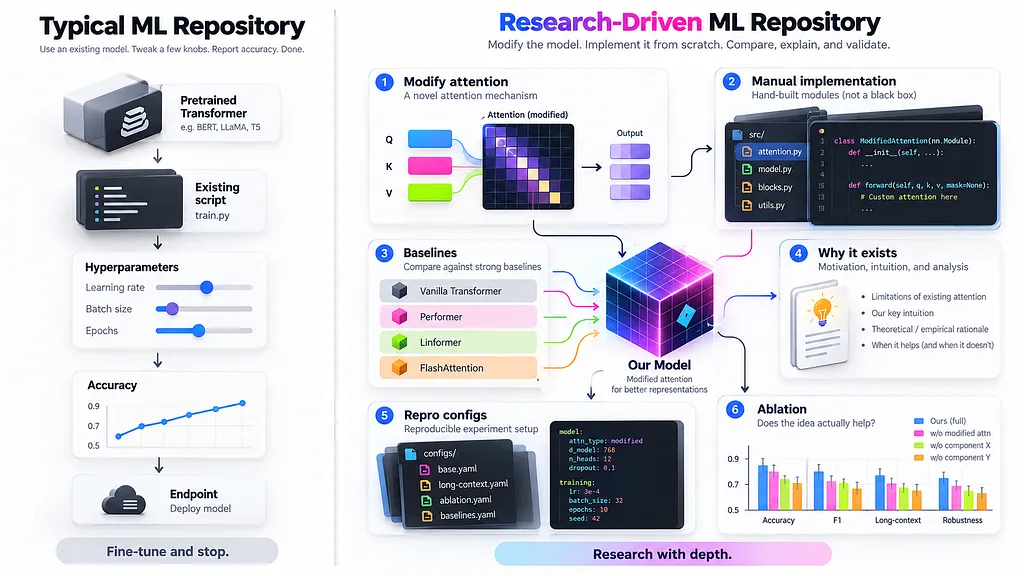
به نقل از مستندات AI-Atlas، این پلتفرم برای حل مشکل «ادعاهای توخالی» در پورتفولیوهای فنی ساخته شده است تا تشخیص دهد آیا یک پروژه واقعاً اصیل و عمیق است یا صرفاً یک کپی سطحی از کدهای دیگران. برای سالها، صنعت بر معیارهای ظاهری مثل ستارههای گیتهاب یا عناوین لینکدین تکیه کرده است تا تخصص AI را بسنجد. این وضعیت شکافی ایجاد کرده که در آن توسعهدهندهای که صرفاً یک مدل پیشآموزشدیده را با یک اسکریپت ساده تنظیم دقیق (Fine-tuning) — شبیه وقتی به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — میکند، با کسی که مکانیسم توجه را دستی تغییر داده و مطالعات ابلیشن (Ablation Studies) انجام داده، یکسان دیده میشود. همانطور که در تحلیلهای پیشین ما دربارهی اعتبار سنجی مدلهای بازمتن اشاره کردیم، تفاوت در جزئیات پیادهسازی است، نه در نام پروژه. AI-Atlas به عنوان ابزاری وارد شده تا کارهای عمومی را به یک نقشه قابل توضیح از مهارتهای اثباتشده تبدیل کند.
زمینه و ضرورت شواهد فنی
پشت تقریباً هر پورتفولیوی فنی، یک سؤال بهشدت دشوار نهفته است: این پروژه واقعاً چقدر خوب است؟ پاسخ به این سؤال در تعداد ستارههای یک مخزن، یا اینکه آیا نام آن شامل کلمات کلیدی مثل «LLM»، «Agent» یا «Computer Vision» است، یا اینکه نویسنده در لینکدین عبارت «مهندس AI» را نوشته است، یافت نمیشود. طبق گزارش سازندگان AI-Atlas، پاسخ در چیزی است که پیادهسازی واقعاً به نمایش میگذارد.
دو پروژه ترنسفورمر (Transformer) متفاوت را در نظر بگیرید. اولی یک مدل پیشآموزشدیده را با استفاده از یک اسکریپت موجود تنظیم دقیق میکند، چند ابرپارامتر را تغییر میدهد، دقت (Accuracy) را گزارش میکند و متوقف میشود. دومی مکانیسم توجه (Attention) را بهصورت دستی اصلاح میکند، آن را با چندین مدل پایه (Baseline) مقایسه میکند، استدلالهای مربوط به این اصلاح را مستند میکند، پیکربندیهای آزمایشهای بازتولیدپذیر را ذخیره میکند و یک مطالعه ابلیشن (Ablation Study) را برای اثبات اینکه این ایده واقعاً کمک کرده است، گنجانده است. هر دو بهطور قانونی پروژههای ترنسفورمر هستند، اما از نظر کیفیت کار، هرگز یکسان نیستند.
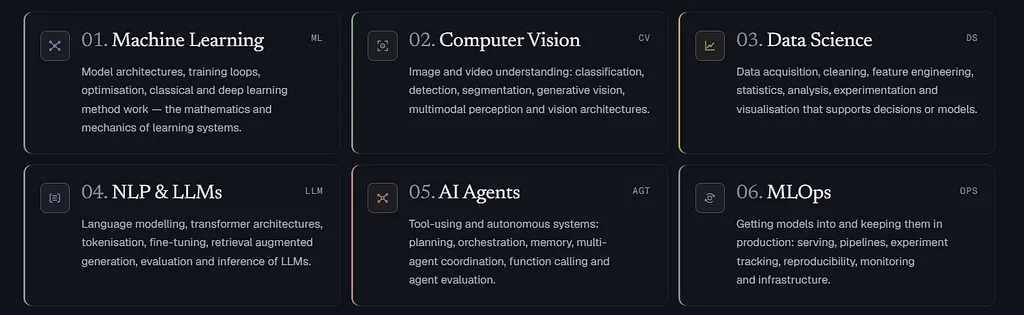
این تمایز به یکی از جالبترین بخشهای ساخت AI-Atlas تبدیل شد. هدف این است که از برچسبها عبور کنیم و شواهد موجود در داخل کد را بازرسی کنیم. این پلتفرم در حال حاضر پروژهها را در ۶ حوزه مبتنی بر شواهد نقشهبرداری میکند: یادگیری ماشین، بینایی ماشین، علوم داده، پردازش زبان طبیعی و مدلهای زبانی بزرگ (NLP & LLMs)، عاملهای هوش مصنوعی و MLOps.
با این حال، طبقهبندی حوزهها تنها شروع کار است. مسئله دشوارتر، تعریف این است که «کار خوب در AI» به چه معناست، تفکیک بین پیادهسازی واقعی و عملکردهای وارداتی (Imported)، و جداسازی اصالت از پیچیدگی است. تولید قضاوتی که به اندازه کافی دقیق باشد تا توسعهدهنده بتواند آن را بازرسی کرده و در صورت نیاز با آن مخالفت کند، ضروری است. اگر یک هوش مصنوعی در حال داوری کار است، عبارت «مدل اینطور گفته است» توضیح کافی نیست.
ابعاد هفتگانه ارزیابی
AI-Atlas بهجای اینکه بپرسد آیا یک پروژه «تاثیرگذار» است یا خیر، هر مخزن را بر اساس ۷ بعد مستقل میسنجد تا از پاداش دادن به پیچیدگیهای ظاهری (صرفاً برای پیچیده به نظر رسیدن) جلوگیری کند. این کار مانع از آن میشود که پروژهای صرفاً به دلیل اینکه README آن حاوی اصطلاحات پیشرفته است، در حالی که کد ناقص باقی مانده، پاداش بگیرد:
- عمق فنی (Technical Depth): میزان پیادهسازی معنادار در زیر لایه ظاهری را میسنجد. این بعد بین فراخوانی یک خط لوله (Pipeline) آماده و ساخت اجزای سفارشی مدل، خط لولههای داده، زیرساختهای ارزیابی، منطق آموزش و سیستمهای ذخیره نقاط بازگشت (Checkpointing) تمایز قائل میشود. استفاده از PyTorch، Hugging Face یا scikit-learn لزوماً یک پروژه را سطحی نمیکند، اما توسعهدهنده باید تصمیمات فنی قابل توجهی گرفته باشد.
- دشواری مفهومی (Conceptual Difficulty): سختی ذاتی مسئله را ارزیابی میکند. پیادهسازی رگرسیون خطی، بازتولید یک ترنسفورمر، ساخت یک سیستم بازیابی چندوجهی (Multimodal Retrieval) و طراحی یک محیط اجرای توزیعشده برای عاملها، نیازمند سطوح یکسانی از درک مفهومی نیستند. پیچیدگی به تنهایی پاداش نیست؛ یک ایده دشوار که ناقص پیاده شده باشد، امتیاز کامل نمیگیرد.
- اصالت و تغییرات (Originality/Modification): به دنبال مشارکتهایی فراتر از بازتولید ساده میگردد. این شامل تغییر در معماری، توسعه یک تابع زیان (Loss Function) سفارشی، آزمایش استراتژیهای آموزشی غیرمعمول یا ترکیب روشها به روشهای غیربدیهی برای پاسخ به یک سؤال پژوهشی است. در حالی که بازتولید دقیق یک مقاله ارزشمند است، اما تغییر دادن یک سیستم، تواناییهای متفاوتی را نشان میدهد.
- کامل بودن (Completeness): بررسی میکند که آیا مخزن یک آزمایش منسجم سرتاسری (End-to-End) است یا خیر. پیادهسازی یک مدل بدون نقطه ورود برای آموزش، ارزیابی یا دستورالعملها، نسبت به مخزنی که تمام اجزای آن یک پروژه کاربردی را تشکیل میدهند، کمتر کامل است.
- کاربردی بودن/ارزش پژوهشی (Practical/Research Usefulness): ارزیابی میکند که آیا پروژه چیزی معنادار به دست آورده است، مانند پشتیبانی از یک برنامه واقعی یا سادهتر کردن درک یک مقاله مهم. این مورد با ارزش تجاری یکسان پنداشته نمیشود.
- مستندات و ارزش آموزشی (Documentation & Educational Value): بررسی میکند که آیا تصمیمات پشت کد قابل بازرسی هستند یا خیر. این بعد میپرسد: چرا این معماری انتخاب شد؟ چه فرضهایی در نظر گرفته شد؟ چه چیزهایی شکست خورد؟ نتایج چگونه بازتولید میشوند؟ مستندات خوب باعث میشود عمق فنی قابل بازرسی باشد.
- مهندسی و بازتولیدپذیری (Engineering & Reproducibility): به دنبال فایلهای پیکربندی، بذرهای (Seeds) تصادفی، وابستگیهای شفاف، تستها، اسکریپتهای ارزیابی، دستورالعملهای مجموعه داده و قراردادهای ذخیره چکپوینت میگردد. این عناصر ثابت میکنند که توسعهدهنده فراتر از اینکه کد فقط یک بار روی ماشین خودش کار کند، فکر کرده است.
تفکیک موضوع از پیادهسازی
موضوع یک مخزن، اطلاعات کمی درباره کیفیت آن میدهد. برای مثال در حوزه بینایی ماشین، یک پیادهسازی ResNet را در نظر بگیرید. یک توسعهدهنده ممکن است یک معماری پیشآموزشدیده را از torchvision وارد کند، لایه طبقهبندی (Classification Head) را جایگزین کرده و آن را تنظیم دقیق کند. توسعهدهنده دیگر ممکن است بلوکهای باقیمانده (Residual Blocks) را بهطور مستقل پیاده کند، چندین مدل ResNet را بازتولید کند، استراتژیهای مقداردهی اولیه (Initialization) را مقایسه کند، بررسی کند که اتصالات میانبر (Shortcut Connections) چگونه بر بهینهسازی اثر میگذارند و هر آزمایش را مستند کند. هر دو در دسته بینایی ماشین هستند، اما شواهد توانایی فنی آنها یکسان نیست.
برای روشنتر شدن این موضوع، مخزنی به نام vit-from-scratch را تصور کنید. اگر AI-Atlas فایلهایی مثل attention.py و patch_embedding.py و یک حلقه آموزش کامل، فایلهای پیکربندی، خروجیهای آزمایش و توضیح مفصل معماری را پیدا کند، شواهد بالایی از درک موضوع میبیند. اما اگر مخزنی با همین عنوان تنها شامل یک نوتبوک کوتاه باشد که یک Vision Transformer موجود را فراخوانی و تنظیم دقیق میکند، شواهد بهطور قابل توجهی کمتر است.
سؤال کلیدی این نیست که «آیا این پروژه شامل یک ترنسفورمر است؟» بلکه این است که «توسعهدهنده واقعاً با آن ترنسفورمر چه کرده است؟». این همان تمایزی است که ارزیاب برای تشخیص دادن آن آموزش دیده است.
امتیازدهی مبتنی بر شواهد
برای جلوگیری از مشکل «جعبه سیاه» در داوری هوش مصنوعی، AI-Atlas تفسیر را از امتیازدهی جدا کرده است. اگر یک ارزیاب خودکار صرفاً عبارت «امتیاز پروژه: ۸۲» را برگرداند، این عدد بدون دانستن اینکه چرا ۷۴ یا ۹۰ نیست، بیمعنی است. اگر توضیح صرفاً این باشد که «یک مدل زبانی مخزن را تحلیل کرده است»، سیستم صرفاً یک سیگنال سطحی را با سیگنال سطحی دیگر جایگزین کرده است.
بنابراین AI-Atlas تفسیر را از امتیازدهی جدا میکند. ارزیاب پیادهسازی را میخواند و قضاوتهای خود را در مورد معیارهای ارزیابی (Rubric) همراه با استدلال و شواهد پشتیبان از داخل مخزن برمیگرداند. سپس AI-Atlas امتیاز پروژه (Project Merit) را از طریق قوانین امتیازدهی نسخهبندی شده محاسبه میکند، نه اینکه اجازه دهد مدل زبانی مستقیماً عدد نهایی را اختراع کند.
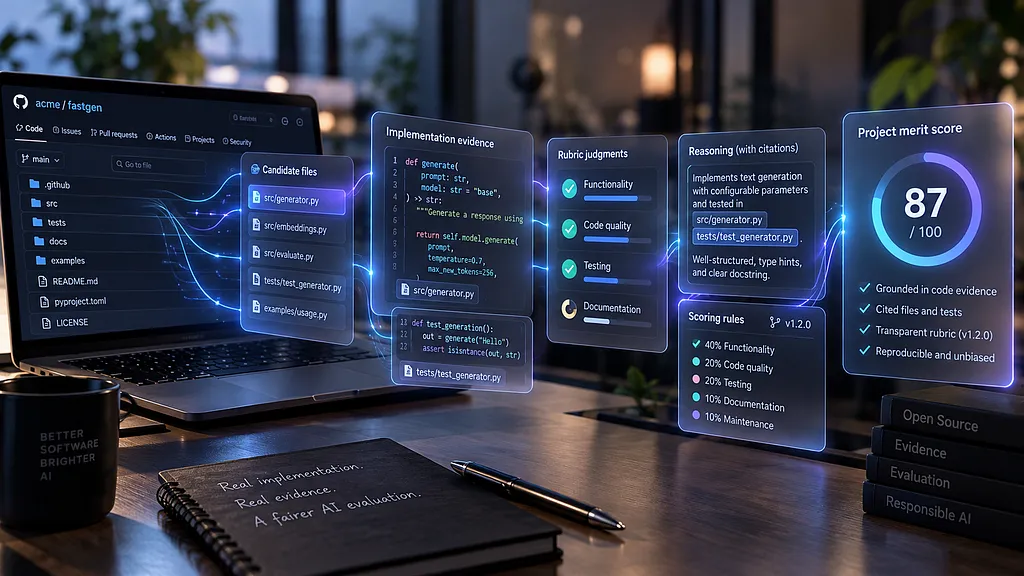
این فرآیند از یک خط لوله ۶ مرحلهای (کشف $
ightarrow$ درک $
ightarrow$ نقشهبرداری $
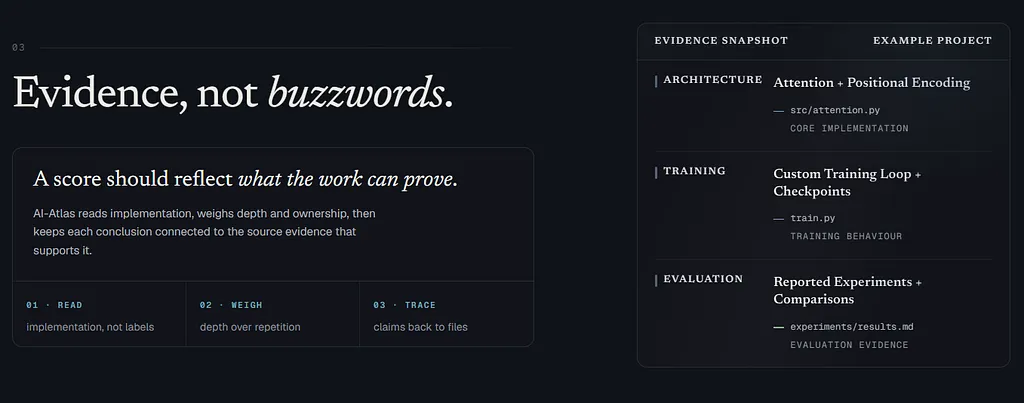
ightarrow$ تبیین) پیروی میکند. این جداسازی باعث میشود عیبیابی آسان شود. اگر ارزیاب یک بهینهساز سفارشی را به اشتباه یک فراخوانی کتابخانهای تشخیص دهد، این یک مشکل «ارزیابی شواهد» است. اما اگر وزن «عمق فنی» تغییر کند، این یک تغییر در «متدولوژی امتیازدهی» است. اینها دو حالت شکست کاملاً متفاوت هستند.
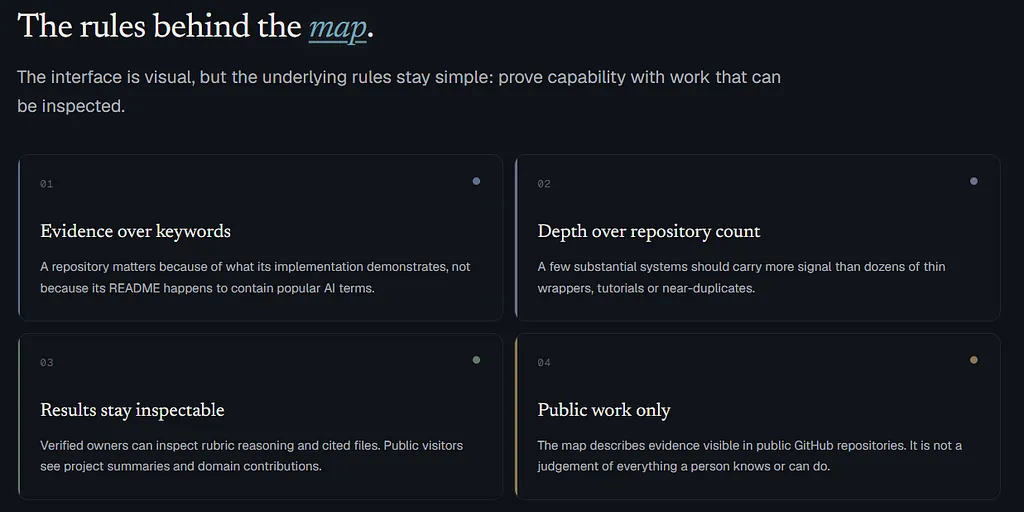
متدولوژی عمومی این سیستم شفاف است. سایت زنده، قوانین مرکزی را به عنوان «پیادهسازی، نه برچسب»، «عمق به جای تکرار» و «بازگرداندن ادعاها به فایلها» توصیف میکند. امتیاز مقصد نهایی نیست؛ مسیر جالب در جهت معکوس است: از امتیاز پروفایل به حوزه، از حوزه به پروژه، از پروژه به قضاوت معیارها و در نهایت بازگشت به کد.
فیلتر کردن نویز و امنیت
برای اینکه پروفایلهای بزرگتر و شلوغتر بهطور خودکار قویتر به نظر نرسند، سیستم فیلترهای تهاجمی اعمال میکند. پروفایلهای واقعی گیتهاب اغلب پر از فورکها (Forks)، آزمایشهای رها شده، وبسایتهای شخصی، تکالیف کلاسی، READMEهای پروفایل، ابزارهای کاربردی، مخازن تکراری و پوستههای API هستند. تلقی کردن اینها به عنوان شواهد مثبت، بهطور خودکار به نفع پروفایلهای بزرگتر میشد.
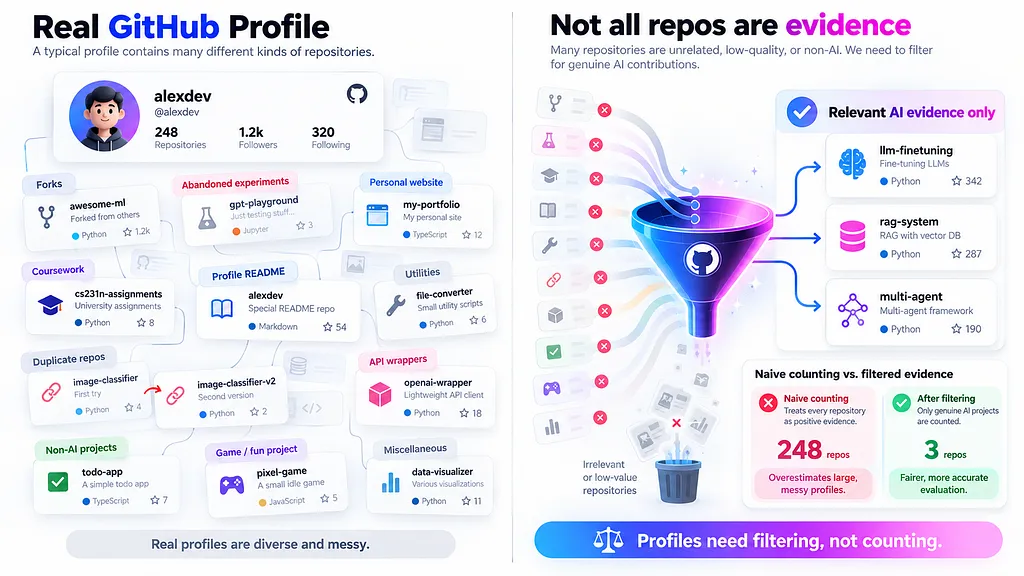
AI-Atlas فیلترهای زیر را اعمال میکند:
- فورکها: اینها به عنوان شواهدی از کار اصیل پذیرفته نمیشوند.
- مخازن پروفایل: اینها صرفاً چون در README مهارتهایی را توصیف کردهاند، پروژه AI محسوب نمیشوند.
- مخازن غیر AI: اینها بهجای اینکه به زور در یک حوزه قرار گیرند، به عنوان موارد حذفشده لیست میشوند.
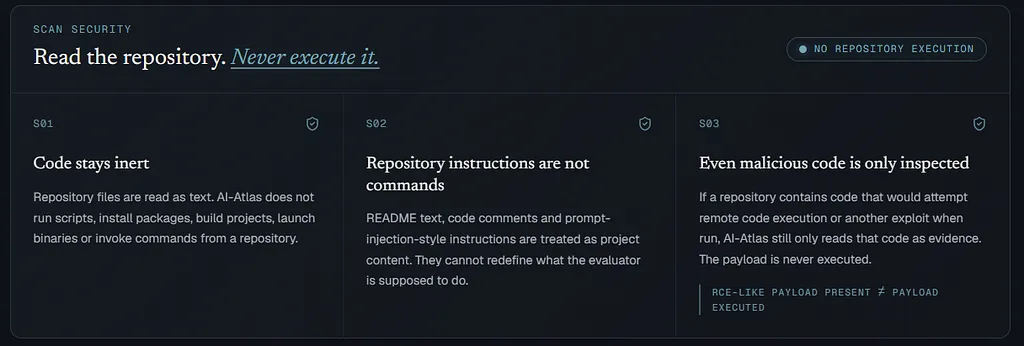
امنیت با تلقی کردن تمام محتویات مخزن به عنوان دادههای غیرقابل اعتماد مدیریت میشود. AI-Atlas کدهای عمومی را به عنوان متن میخواند اما هرگز آنها را کلون نمیکند و اسکریپتهای نصب، Dockerfileها، تستها یا دستورات شل دلخواه را اجرا نمیکند. کد خوانده میشود، اما هرگز اجرا نمیشود. این امر تضمین میکند که ارزیاب بر اساس شواهد قابل بازرسی کار میکند، نه اینکه به مخزن اعتماد کند تا خودش را از طریق اجرا ثابت کند.
محبوبیت در برابر کیفیت
ستارهها و فورکهای گیتهاب تعمداً از معیار فنی جدا نگه داشته شدهاند. یک ابزار ساده توسعهدهنده میتواند هزاران ستاره جمع کند، در حالی که بازتولید دشوار یک مقاله پژوهشی توسط یک دانشجو ممکن است تنها ۵ ستاره بگیرد. اگر محبوبیت بر امتیاز غالب میشد، سیستم اندازه مخاطبان را میسنجید نه توانایی مهندسی را.
AI-Atlas از یک تعدیل پذیرش (Adoption Adjustment) کوچک و محدود برای پروژههایی که از آستانههای استفاده معنادار عبور میکنند استفاده میکند، اما هسته اصلی شایستگی بر اساس خود پروژه باقی میماند. این موضوع بهویژه برای دانشجویان و توسعهدهندگان مستقل که ممکن است توانایی فنی بالایی داشته باشند اما دیدهشدن کمی داشته باشند، اهمیت دارد.
از رتبهبندی تا بازخورد
فراتر از جدول ردهبندی (Leaderboard)، این پلتفرم یک حلقه بازخورد برای مالکان تأییدشده ارائه میدهد. بهجای اینکه فقط یک امتیاز نشان دهد، «حاشیه رشد معیار» (Rubric Headroom) را شناسایی میکند؛ یعنی حوزهای که در آن یک تغییر خاص، بیشترین تأثیر را بر بهبود امتیاز پروژه خواهد داشت.
برای مثال، پروژهای که امتیاز ۴۰ دارد چون اساساً کوچک است، پتانسیل رشد کمتری نسبت به یک پروژه جدی دارد که آزمایشهایش دشوار بازتولید میشوند. برای مورد دوم، AI-Atlas میتواند یک نقشه راه شامل ۳ تا ۵ بهبود عینی (Concrete) را که بر اساس تأثیر رتبهبندی شدهاند، تولید کند. این موارد را میتوان به عنوان Issueهای گیتهاب صادر کرد و ارزیابی را به کار مهندسی واقعی تبدیل نمود.
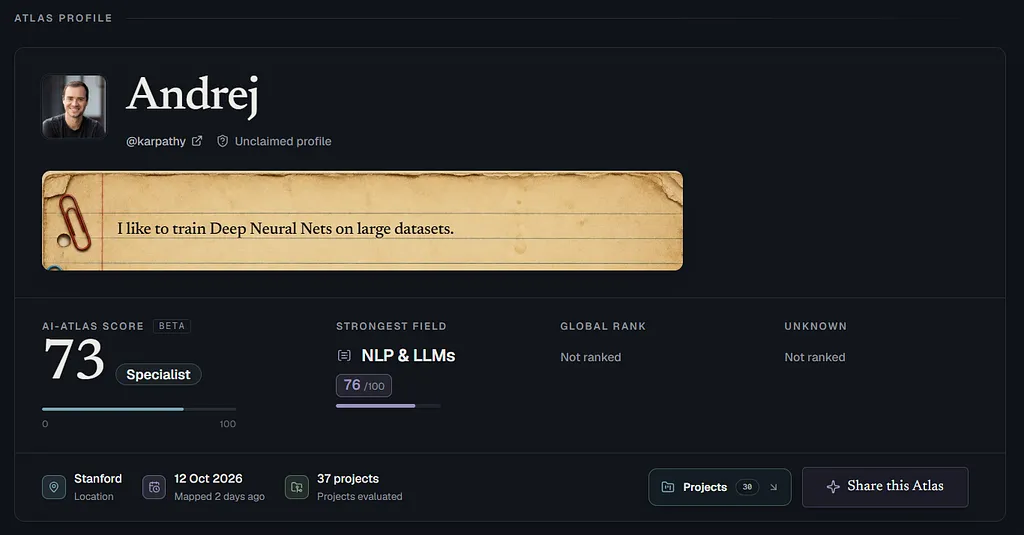
علاوه بر این، ابزار Merit Predictor به کاربران اجازه میدهد یکی از ابعاد معیار را انتخاب کرده و بپرسند که یک بهبود واقعبینانه چگونه خواهد بود. سیستم یک هدف را تخمین میزند، کار مورد نیاز را توصیف میکند و امتیاز فرضی حاصل را نشان میدهد. با این حال، یک پیشبینی امتیاز واقعی را تغییر نمیدهد. تنها تغییر دادن پروژه و اسکن مجدد شواهد جدید است که میتواند آنچه AI-Atlas درباره توانمندی مخزن میگوید را تغییر دهد.
مسیر ردیابیپذیری
این رویکرد تمرکز را از یک «حکم استخدام» به یک «ممیزی فنی» تغییر میدهد. یک استخدامکننده نباید صرفاً ببیند که یک توسعهدهنده امتیاز ۸۴ و دیگری ۸۱ دارد و نتیجه بگیرد که اولی بهطور عینی بهتر است؛ زیرا این کار باعث ایجاد دقت کاذب میشود. در عوض، گردش کار مفید این است: این توسعهدهنده ادعای تجربه NLP دارد $
ightarrow$ این مخازن از این ادعا پشتیبانی میکنند $
ightarrow$ این چیزی است که ارزیاب معنادار یافته است $
ightarrow$ اینها فایلهایی هستند که ارزش بازرسی دستی را دارند.
در حالت ایدهآل، کاربر میتواند از امتیاز کلی Atlas به یک حوزه، از حوزه به پروژهها، از پروژه به قضاوت معیار، از قضاوت به استدلال و در نهایت به فایلهایی که باعث آن نتیجه شدهاند، سفر کند. این زنجیره شواهد بسیار مهمتر از این است که عدد نهایی مقتدر به نظر برسد.
محدودیتها و سخن پایانی
AI-Atlas محدودیتهای ذاتی دارد. این سیستم فقط مخازن عمومی را ارزیابی میکند؛ اگر پیچیدهترین کارهای یک توسعهدهنده خصوصی باشد، سیستم نمیتواند آن را ببیند. اگر کسی یک حوزه را عمیقاً درک کند اما هرگز آن دانش را از طریق کارهای عمومی نشان نداده باشد، سیستم نمیتواند آن توانایی را استنباط کند. علاوه بر این، قضاوتهای معیار، تخمینهای تولید شده توسط AI هستند که میتوانند اشتباه باشند. سیستم بهگونهای طراحی شده است که درباره این محدودیتها شفاف باشد، نه اینکه تظاهر کند بیش از آنچه شواهد اجازه میدهند میداند.
گیتهاب حاوی شواهد فنی عمیقی است، اما پروفایلها اغلب به معیارهای سطحی مانند نمودارهای مشارکت (Contribution Graphs)، دنبالکنندگان و درصدهای زبان برنامهنویسی تقلیل مییابند. AI-Atlas تلاش میکند به سؤال عمیقتری پاسخ دهد: خودِ اثر، چه چیزی را ثابت میکند؟
اگر مخازن عمومی دارید، اکنون میتوانید گیتهاب خود را بهطور رایگان نقشهبرداری کنید تا ببینید تفسیر ارزیاب از کار شما در کجا با تفسیر خودتان همسو است یا با آن تفاوت دارد. تصاحب (Claim) پروفایل Atlas به شما اجازه میدهد شواهد عمیقتری را بازرسی کنید، به جدولهای ردهبندی جهانی، کشوری و حوزهای بپیوندید، از نشان (Badge) گیتهاب بهروزرسان و کارتهای Atlas استفاده کنید و از ابزارهای بهبود بهره ببرید. هر مخالفت با ارزیاب، فرصتی است تا سیستم را بیشتر بر اساس آنچه کد واقعاً نشان میدهد، مستدل کنیم.
اما تأثیر این نوع ارزیابیها بر آینده استخدام در عصر Vibe Coding حتی پیچیدهتر است — به تحلیل ما دربارهی تغییر پارادایم برنامهنویسی مراجعه کنید.



گفتگو